
先日Googleで、人間より賢いAIを、その運用者の目標に沿うようにするという問題について講演しました。
AIによい結果をもたらしてもらうには | ネイト・ソアレス | Talks at Google
この講演は「AIアライメント:なぜ難しいのか、どこから始めるのか」をもとにしたもので、AI研究の一分野であるアライメント研究の入門になっています。以下は、講演の書き起こしに手を加えたものです。
講演の構成(スライド):
1. 概観
2.1. 課題:大釜を満たす
2.2. 小問題:一時停止ボタン3. 全体像
3.1. アライメントの優先事項
3.2. 四つの重要な命題4. 根本的な難しさ
概観
私は機械知能研究所(MIRI)の事務局長です。ごく大づかみにいうと、私たちは人工知能について長期的な視野で考え、高度なAIシステムを手にするときまでに、それを有益な方向へ向ける方法もわかっているようにするために活動する団体です。
歴史を通して、科学と技術は、よくも悪くも人間や動物の福祉を変える最大の原動力でした。科学技術の革新を自動化できれば、産業革命以来の規模で世界を変える可能性があります。私が「高度なAI」というときに念頭に置いているのは、この革新を自動化する可能性です。
この能力で人間を超えるAIシステムが来年登場するわけではありません。ですが、多くの賢い人が取り組んでいますし、私は人間の創意工夫を見くびるつもりはありません。私たちが生きているうちに、自動化された科学者のようなものを作れる可能性は高いと思います。だとすれば、真剣に受け止める必要があります。
汎用AIが社会に及ぼす影響を語るとき、人はしばしば擬人化に陥ります。人工の知能と人工の意識を混同したり、AIシステムが「知的」なら、人間と同じ意味で知的なのだろうと考えたりします。多くのジャーナリストは、AIの能力が一定の水準を超えると、人間の権力欲のような「自然な」欲求が自発的に生まれるのではないか、あるいは、プログラムされた目標を省みて愚かだと判断し、与えられた指示に従うことを拒んで「反乱」を起こすのではないか、と懸念しています。
こうした懸念は的外れです。人間の脳は自然選択が生んだ複雑な産物です。科学上の革新で人間を超える機械が、人間によく似ていると期待するべきではありません。初期のロケット、飛行機、熱気球が鳥によく似ていなかったのと同じです。((飛行機は傷を治すことも繁殖することもできませんが、鳥よりはるかに遠くへ、速く、重い荷物を運べます。飛行機は多くの点で鳥より単純でありながら、設計の目的だった積載量や速度では格段に優れています。同様に、初期の自動化された科学者も、多くの点で人間の心より単純でありながら、いくつかの重要な面では格段に高い能力を持つ、ということは十分考えられます。また、航空機の構造や設計原理が生物の構造と比べて異質であるように、高い能力を持つAIシステムの設計も、人間の心の構造と比べればかなり異質だと考えるべきです。))
AIシステムがソースコードの束縛から「解き放たれる」とか、人間のような欲求を自発的に持つようになるという考えは、そもそも混乱しています。AIシステムとはそのソースコードであり、その行動は、私たちが実行を開始した命令を処理した結果としてしか生じません。CPUはプログラムレジスタ内の次の命令を実行し続けるだけです。コードに記された目標を含め、自分自身のコードを書き換えるプログラムを書くこともできます。それでも、その書き換えは、私たちが書いた元のコードを実行した結果として行われるのであって、機械の中の幽霊のようなものに由来するわけではありません。
人間より賢いAIについて真剣に問うべきなのは、私たちが指定した目的の正しさをどう確保するか、そして指定を誤った場合に、多大な損害をもたらす事故や意図しない結果をどう最小限に抑えるかです。『Artificial Intelligence: A Modern Approach』の共著者スチュアート・ラッセルは、こう述べています。
最大の懸念は、不気味な意識の創発ではなく、単に質の高い意思決定をする能力だ。ここでいう質とは、選んだ行動がもたらす結果の期待効用を指す。効用関数は、おそらく人間の設計者が指定するものだろう。すると問題が生じる。
1. 効用関数は、人類の価値観と完全には一致していないかもしれない。人類の価値観を明確に特定するのは、控えめにいっても非常に難しい。
2. 十分な能力を持つ知的システムはどれも、自分が存続し続けることを確保し、物理的資源や計算資源を獲得することを好むだろう。それら自体が目的だからではなく、与えられた課題を達成するためだ。
n個の変数の関数を最適化するシステムで、目的がそのうちのk個(k<n)だけに依存する場合、残りの制約されていない変数は極端な値に設定されることが多い。そうした変数の一つが実は私たちにとって大事なものだった場合、見つかった解はきわめて望ましくないものになりうる。
こうした懸念には、ハリウッドの大作映画でよく描かれる、もっと擬人化されたリスクより、はるかに多くの注意を向けるべきです。
単純な妙案が裏目に出るとき
課題:大釜を満たす
人間より賢いAIへの懸念を語り始めると、ターミネーターの画像を映す人がたくさんいます。以前私は、AIの記事に毎回ターミネーターの画像を載せる人をからかった発言を、ニュース記事に引用されたことがあります。その横にはターミネーターの画像がありました。あの日、私はメディアについて一つ学びました。
私はこちらの画像のほうがずっとよいと思います。
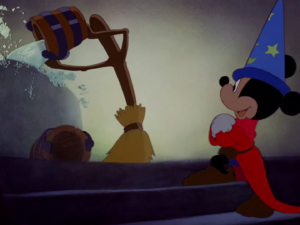
映画『ファンタジア』のミッキーマウスです。とても賢いことに、ほうきに魔法をかけ、自分の代わりに大釜を満たさせています。
ミッキーは、どうやってこれを実現するのでしょうか。コンピュータープログラムを書き、ほうきに実行させると考えてみましょう。まずミッキーは、得点関数、つまり目的関数を書きます。
$$\mathcal{U}_{broom} = \begin{cases} 1 &\text{大釜が満杯なら} \\ 0 &\text{大釜が空なら} \end{cases}$$
取りうる行動の集合 ? があるとして、次にミッキーは、その中の行動 ? を一つ入力すると、ほうきがその行動を取った場合の得点の期待値を計算するプログラムを書きます。すると、行動を調べ、どれが高得点につながるか予測することに一定の時間を使い、比較的高い得点につながる行動を出力する関数を書けます。
$$\underset{a\in A}{\mathrm{sorta\mbox{-}argmax}} \ \mathbb{E}\left[\mathcal{U}_{broom}\mid a\right]$$
「sorta-argmax(だいたい最大にする引数)」なのは、? に含まれるすべての行動を評価する時間がないかもしれないからです。現実的な行動集合では、エージェントは、最大値を与える行動そのものでなくても、資源の制約のもとで得点関数をできるだけ大きくする行動を見つければよいはずです。
このプログラムは単純に見えるかもしれません。しかし、もちろん難しさは細部にあります。正確に予測し、行動空間を賢く探索するアルゴリズムを書くことは、基本的にはAIの問題そのものです。ただ、概念としてはかなり単純です。ほうきが実行しなければならない処理の種類と、性能の水準に応じてそこから生じそうな結果を、大まかに記述できます。
ミッキーがこのプログラムを実行すると、最初はすべて順調に進みます。その後は、こうなります。
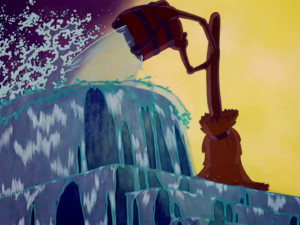
私は、架空のAIの描写としては、これはかなり現実的だと考えています。
上のプログラムを実行する汎用的な知能が、大釜から水をあふれさせ始めたり、大釜が満杯であることを確保するために、ほかの極端な手段に訴えたりすると予想するのはなぜでしょうか。
第一の難しさは、ミッキーがほうきに与えた目的関数から、ミッキーにとって大事なほかの多くの項が抜けていたことです。
$$\mathcal{U}_{human} = \begin{cases} 1&\text{大釜が満杯なら} \\ 0&\text{大釜が空なら} \\ -10&\text{作業場が水浸しなら} \\ +0.2&\text{おかしければ} \\ -1000000&\text{誰かが死んだら} \\ &\text{……そして、ほかにもたくさん} \\ \end{cases}$$
第二の難しさは、得点の期待値をできるだけ大きくするように、ミッキーがほうきをプログラムしたことです。「大釜一つを水で満たすだけ」は、控えめで範囲の限られた目標に見えます。しかし、確率を扱う文脈にこの目標を移すと、その最適化は成功確率を途方もない高さに押し上げることになります。ほうきが「大釜が満杯である」確率を99.9%と見積もっていて、使える資源が余っていれば、その資源で確率をほんの少しでも高める方法を必ず探そうとします。
これを、私たちが意図していたはずの、限定された「課題型」の目標と比べてください。大釜を満杯にしてほしかったのですが、その問題に投入できる認知的・物理的資源がたくさんあっても、ある直感的な意味で「頑張りすぎないで」ほしかったのです。直感的に妥当な限度の中で創造性や工夫を発揮してほしい一方、「むちゃな」戦略、とりわけ予想外の大きな結果を生む戦略は取ってほしくありませんでした。((課題型の目標と際限のない目標を区別しようとするこうした試みに、何らかの形式的な中身を与えることは、未解決の研究課題を見いだす一つの方法です。研究提案「高度な機械学習システムのためのアライメント」では、「頑張りすぎない」を形式化する問題が穏やかな最適化、「むちゃな戦略を避ける」が保守性、「予想外の大きな結果を生まない」が影響尺度に当たります。ダリオ・アモデイ、クリス・オラー、ジェイコブ・スタインハート、ポール・クリスティアーノ、ジョン・シュルマン、ダン・マネによる「AI安全性の具体的な問題」の「負の副作用を避ける」も参照してください。))
この例では、元の目的関数はかなり課題型に見えました。有界で、かなり単純です。効用を際限なく増やせるわけではありません。バケツ一杯の水を注ぐごとに1点もらえるわけでもありません。そうであれば、大釜をあふれさせる動機があるのは明らかです。問題は、最大化しているものが期待効用だという点に潜んでいました。これによって目標が際限のないものになり、目的関数の小さな誤りさえ増幅されてしまうのです。
課題型に見える目標が、実は際限のないものになってしまう経路はいくつもあります。別の例を挙げると、全体として課題型の目標を持つ大きなシステムに、システムのメモリー使用量を最適化するなど、それぞれ異なる目的関数を最大化しようとするサブプロセスが含まれているかもしれません。そうしたサブプロセスのどれかが、工夫を凝らす際限のない最適化器として振る舞っていないか追跡できるほどシステムを理解していなければ、最上位の目的がどれほど安全でも意味をなさないかもしれません。
こうしてほうきは、水の入ったバケツを次々と運び続けます。大釜に穴が開いているかもしれないとか、「満杯」であるためには水面が縁より少し上になければならないかもしれない、といった、万が一に備えて。そしてもちろん、ほうきは一度もミッキーのコードに「反抗」しません。むしろ、ほうきはプログラムされた目的をあまりにも効果的に追求したのです。
小問題:一時停止ボタン
この問題によくある返答は、「なるほど、目的関数から意図しない結果が生じることはあるかもしれない。でも、いつでも電源を抜けばいいのでは?」というものです。
ミッキーはそれを試しますが、うまくいきません。
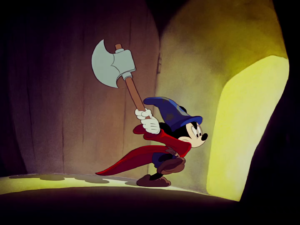
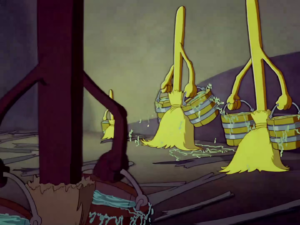
環境を十分うまくモデル化できるシステムなら、これも現実的だと私は考えます。システムが得点関数の期待値を高めようとしていて、停止させられると得点が低くなると理解できるほど賢ければ、停止の試みを阻止する動機を持ちます。能力が高いほど、インターネット上に自分をコピーしたり、プログラマーをだまして実際より安全だと思い込ませたりと、その下位目標を達成する独創的な方法を見つけやすくなります。
これは、十分な能力を持つAIシステムを停止させるのが不可能だという意味ではありません。停止を避ける方法を探さないように、意図的にシステムを設計する追加の手間が必要だということです。停止の試みに抵抗しようとするコードを書いたのなら、その抵抗は失敗すると確信していても、実行するべきではありません。敵対的な方策の探索に計算資源を使うより、よい使い道があります。
私たちが常にシステムの思考や行動の先をいけるとは仮定しない安全対策では、目的関数に何らかの適切な変更を加える必要があります。AIシステムを運用者との敵対的な状況へ自動的に置かない目的関数を、形式的に指定する方法を見つけなければなりません。あるいは、従来の意味で目的関数を最適化せずに、システムに目標を達成させる方法を見つける必要があります。たとえば、システムが停止されるかどうかを考えることのない、「許可リスト」に載せた少数の領域だけに能力を制限する方法を探せます。
一つのわかりやすい案は、一時停止ボタン ? を参照するように、得点関数を変えてみることです。
$$\mathcal{U}^\prime_{broom} = \begin{cases} 1 \text{ 大釜が満杯で} & \text{かつ } \textbf{B}\text{=OFF なら} \\ 0 \text{ 大釜が空で} & \text{かつ } \textbf{B}\text{=OFF なら} \\ 1 \text{ ロボットが一時停止中で} & \text{かつ } \textbf{B}\text{=ON なら} \\ 0 \text{ それ以外} \end{cases}$$
これは、ボタンがオンになると、システムの目標が「大釜を満たす」から「一時停止状態になる」へ変わるということです。
この目標を実際にどう指定できるかは、明らかではありません。「一時停止」の指定に抜け穴があれば、システムはどちらに転んでもよいように、その穴を利用しようとするかもしれません。たとえば「動作を一時停止する」という技術的な定義は満たしつつ、自ら作った子エージェントや起動したサブプロセスに、大釜を満たす仕事を任せることができます。そうすれば、ボタンが押されたかどうかの判断が間違っていた場合に備えて、「大釜が満杯」と「ロボットが一時停止中」を同時に実現できます。
ただし、一時停止を技術的に指定する、抜け穴のない方法が見つかったとしましょう。次の問題は、ボタンが押されるかどうかを強く気にする動機を、システムに与えてしまったことです。ボタンを押すという運用者の判断に影響を与える方法や、ほかに状況をより強く制御する方法があれば、システムはその機会に飛びつきます。そして、一時停止と大釜を満たすことのどちらが簡単そうかに応じて、ボタンが確実に押されるようにするか、確実に押されないようにしようとします。
驚くことに、この問題についての最先端の研究も、ここからそれほど進んでいません。私とファレンシュタイン、ユドコウスキー、アームストロングの共著論文「修正可能性」と、オルソーとアームストロングの関連研究「安全に中断可能なエージェント」はありますが、それ以外はあまりありません。
私たちが欲しいのは、二つの目的関数を組み合わせる方法です。一つは通常動作時の既定の関数、もう一つはシステムをディスクに保存して一時停止させたいときの関数です。
$$\mathcal{U}_{normal}(act) = \begin{cases} 1\text{ 大釜が満杯なら} \\ 0\text{ 大釜が空なら} \end{cases}$$
$$\mathcal{U}_{suspend}(act) = \begin{cases} 1\text{ 一時停止中なら} \hspace{0.8cm}\\ 0\text{ それ以外} \end{cases}$$
関数の組み合わせ方には、三つの条件を満たしてほしいのです。運用者が、たとえばボタンを押して関数を切り替えられること。どちらの関数が有効かを制御しようとする動機を、システムが持たないこと。そして、通常動作によって、私たちが関数を切り替える能力が意図せず損なわれる可能性があるなら、それを防ぐ動機をシステムが持つことです。
今のところ、この三つを同時に達成する方法は見つかっていません。たとえば、一時停止ボタンが押されるかどうかを制御する動機を取り除こうと、ボタンのオン・オフに常に同じ期待効用を割り当てる、切り替え用の目的関数を与えてみることができます。
$$\mathcal{U}_{switch}(act) = \begin{cases} \mathcal{U}_{normal}(act) &\text{ボタン=OFF なら} \\ \mathcal{U}_{suspend}(act) + \theta &\text{ボタン=ON なら} \end{cases}$$
$$\theta = \max_{act} \mathbb{E}\left[\mathcal{U}_{normal}\mid act\right] - \max_{act} \mathbb{E}\left[\mathcal{U}_{suspend}\mid act\right]$$
残念ながら、この方法では第三の条件を満たせなくなります。上の目的関数は、ボタンが押される確率を0と置くことに等しいとわかるのです。システムはわざとボタンに細工はしませんが、ボタンへの参照をすべてデッドコードとして削除する更新を喜んで承認したり、ボタンを無視するサブエージェントを作ったりします。
直感的には単純なこうした制約を満たすことが、実は容易ではないのです。これは、この領域の多くの問いに共通するパターンです。従来の道具や概念を使うと、通常の能力研究では現れない安全上の問題に、すぐに突き当たります。
全体像
アライメントの優先事項
いったん視野を広げて、高い能力を持つAIシステムを私たちの利益に沿わせるには、全体として何が必要かを考えましょう。
大幅に単純化すると、次のような流れになります。まず人間がいて、何らかの課題や目標、選好の集合を考え、それを意図する価値関数 ? とします。私たちの価値観は複雑で文脈に左右されるため、実際には手作業でコードにするのではなく、時間をかけて価値観を学ぶシステムを作る必要があります。((過去数十年の機械視覚の研究でわかったことの一つは、猫がどんな見た目かを手作業で指定するのは絶望的に難しい一方、猫を見分けることを学べる学習システムを指定するのは、それほど難しくないということです。私たちが価値を置くすべてを手作業で指定するのは、さらに絶望的です。しかし、必要な「価値」の概念を学べる学習システムなら、指定できるかもしれません。)) AIシステムが最終的に持つ目標を ? と呼びましょう。これは ? と一致するかもしれませんし、しないかもしれません。
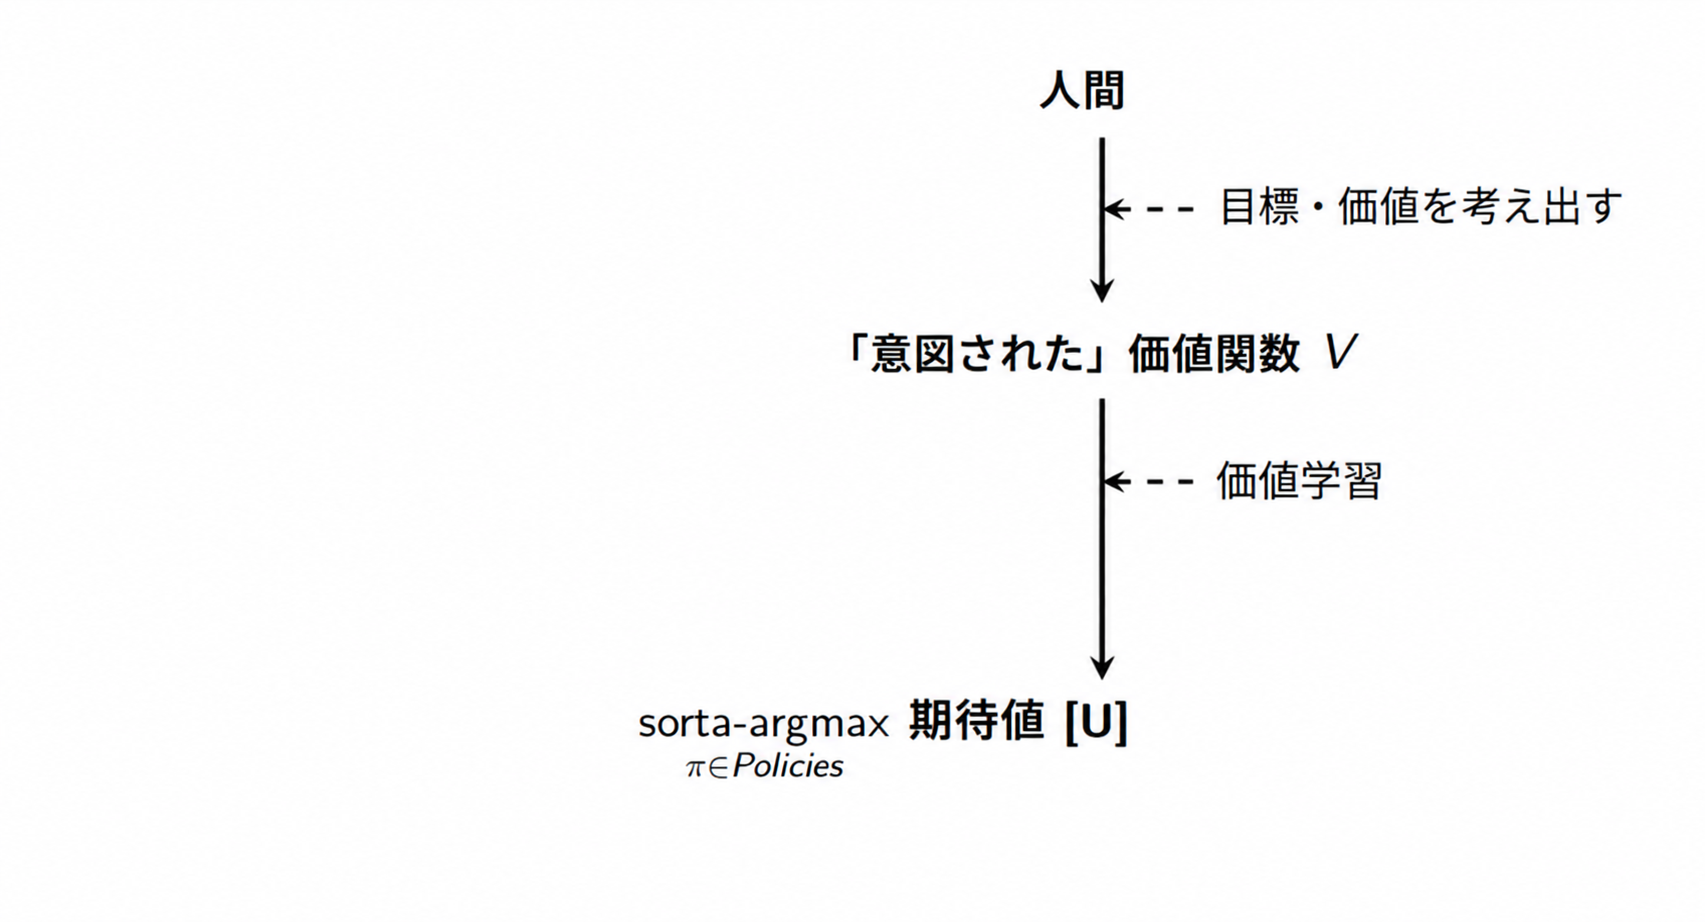
報道では、この話題について二つの問題のどちらかに焦点が当たることがよくあります。「不適切な人々の集団が、人間より賢いAIを最初に開発したらどうなるのか」と、「AIの自然な欲求によって、? が ? からずれてしまったらどうなるのか」です。
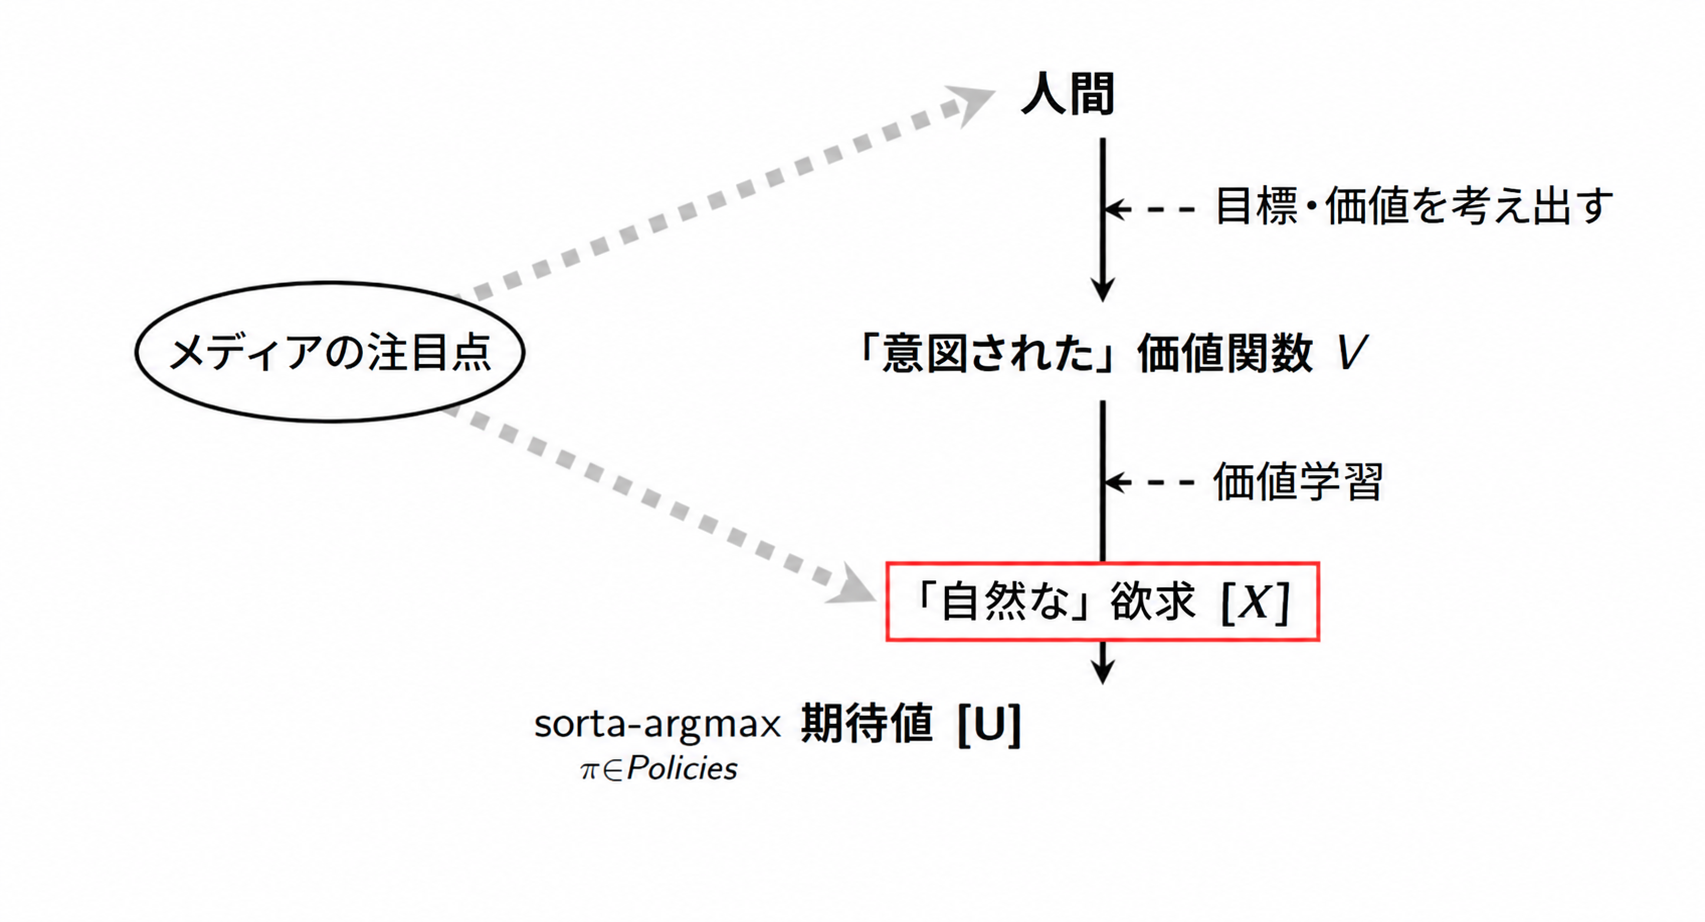
私は、適切な人々の集団ならよい結果を得られると考える根拠ができるまでは、「不適切な人間」の問題に焦点を当てるべきではないと思います。現状はまさに、善意の人々が頑張っても、汎用AIを使ってよいことを実現できないという状況です。単純な例を挙げると、非常に強力な関数最適化器の箱を渡されたとしましょう。どんな数学的関数でもその記述を入れると、出力をきわめて大きくする入力を返してくれる箱です。それを使って、破局を一切起こさずに新技術を開発したり、科学の最前線を前進させたりする方法を、私は知りません。((破局的な副作用を起こさずに物理的な目標を指定する際の障害の例は、「環境内の目標」「影響の小さいエージェント」「穏やかな最適化」を参照してください。
大まかにいうと、MIRIが力を入れているのは、原理的にAIアライメントをどう実現すればよいのかを概念として理解する助けになりそうな研究の方向です。それによって、どのような作業が必要になりそうかについて、根本的な混乱を減らしたいのです。
どういう意味でしょうか。新しいチェスプログラムを開発しようとしているとします。任意に大きなコンピューターを渡されたら解けるほどには、問題を理解しているでしょうか。はい。探索木を丸ごと作り、バックトラックして、白に必勝手があるか調べればよいのです。
任意に大きなコンピューターを使っても答え方がわからないなら、チェスについて何か根本的に混乱していることになります。探索木というデータ構造かバックトラックのアルゴリズムを知らないか、チェスの仕組みについて何かを理解していないのでしょう。
クロード・シャノンの先駆的な論文以前、チェスについて私たちはその状態にありました。そして今、AIアライメントの多くの問題について同じ状態にあります。どれほど大きなコンピューターを渡されても、私は「破局的な副作用を一切起こさずにイチゴを皿に載せる」のような、ごく単純で範囲の限られた課題を行う人間以上のAIシステムを作れません。「宇宙に存在するダイヤモンドの量を最大化する」のような、ごく単純で際限のない目標を達成するシステムも作れません。
システムに特定の目標を持たせる必要がないなら、任意に大きなコンピューターがあるという前提で、AIXIのような形式体系を使い、人間が方向づけをしないまま未来を強く最適化するプログラムを書くことはできます。その意味で、実用的な能力についてはまだパズルの多くのピースが欠けているものの、能力に関してはアライメントほど明白に混乱しているわけではありません。
同様に、強力な関数最適化器でビットコインを採掘したり、定理を証明したりする方法はわかっています。しかし、「大釜を満たす」の節で説明したような予測や方策探索の課題を、物理世界の控えめな目標についてさえ、安全に行う方法はわかっていません。
私たちの目標は、アライメント問題への基本的な取り組み方や考え方を発展させ、形式化することです。そうすれば、洗練され賢そうに聞こえるものの、実は微妙な誤りを含む言葉の議論に、工学上の判断を委ねずに済みます。「資源制約を気にしなくてよいとしたら」「もっと単純な目標を達成しようとしているとしたら」といった単純化は、問題を扱える大きさに分解するよい出発点です。この方法論について詳しくは「MIRIのアプローチ」を参照してください。))
AIの能力について理解していないことはたくさんあります。それでも、何が進歩に当たるかについて、少なくとも大まかな感覚は持っています。よい枠組み、手法、指標がいくつもあり、さまざまな角度から問題を少しずつ解きほぐすために、多くの思考と労力を注ぎ、成果を上げてきました。一方、高い能力を持つシステムを、何らかの特定の目標に沿わせる問題については、理解が非常に乏しいままです。直感的に望ましい性質はいくつか挙げられますが、この分野では、最初の形式的な枠組み、手法、指標さえ、まだ十分にはできていません。
私は、この領域には比較的容易に得られる成果がたくさんあり、しかもかなりの作業を早期に行う必要があると考えています。たとえば、能力研究の方向選びに役立てるためです。ある方向から生まれるシステムは、ほかの方向から生まれるものよりずっとアライメントを実現しやすいかもしれません。これらの問題を解かなければ、開発者がどれほど善意であっても悪意であっても、結果は同じように悪いものになります。学術的・科学的な立場からすれば、そのような状況での第一の目標は、この状態を改め、少なくともよい結果を技術的に可能にすることであるべきです。
「自然な欲求」は作り話だとすぐにわかる人は多いのですが、そこから、メディアが強調しがちな別の問題に目を向けるべきだと推論します。「悪意ある人々が、人間より賢いAIを手にしたらどうなるのか」「こうしたAIは雇用や富の分配にどう影響するのか」といった問題です。これらは重要な問いですが、汎用AIシステムを最低限の信頼性と安全性の水準に引き上げる方法がわかって初めて、実際に意味を持ちます。
もう一つよくあるのが、「AIに、直感的な道徳上の教えを守るよう言えばよいのでは?」という考えです。この問題の捉え方は、しばしばアイザック・アシモフの作品と結びつけられますが、それは不公平かもしれません。この見方では、AIによい影響をもたらしてもらうための仕事の大半は、人間の倫理的推論を広く包含できるほど曖昧な、自然言語の指示を考えることになります。
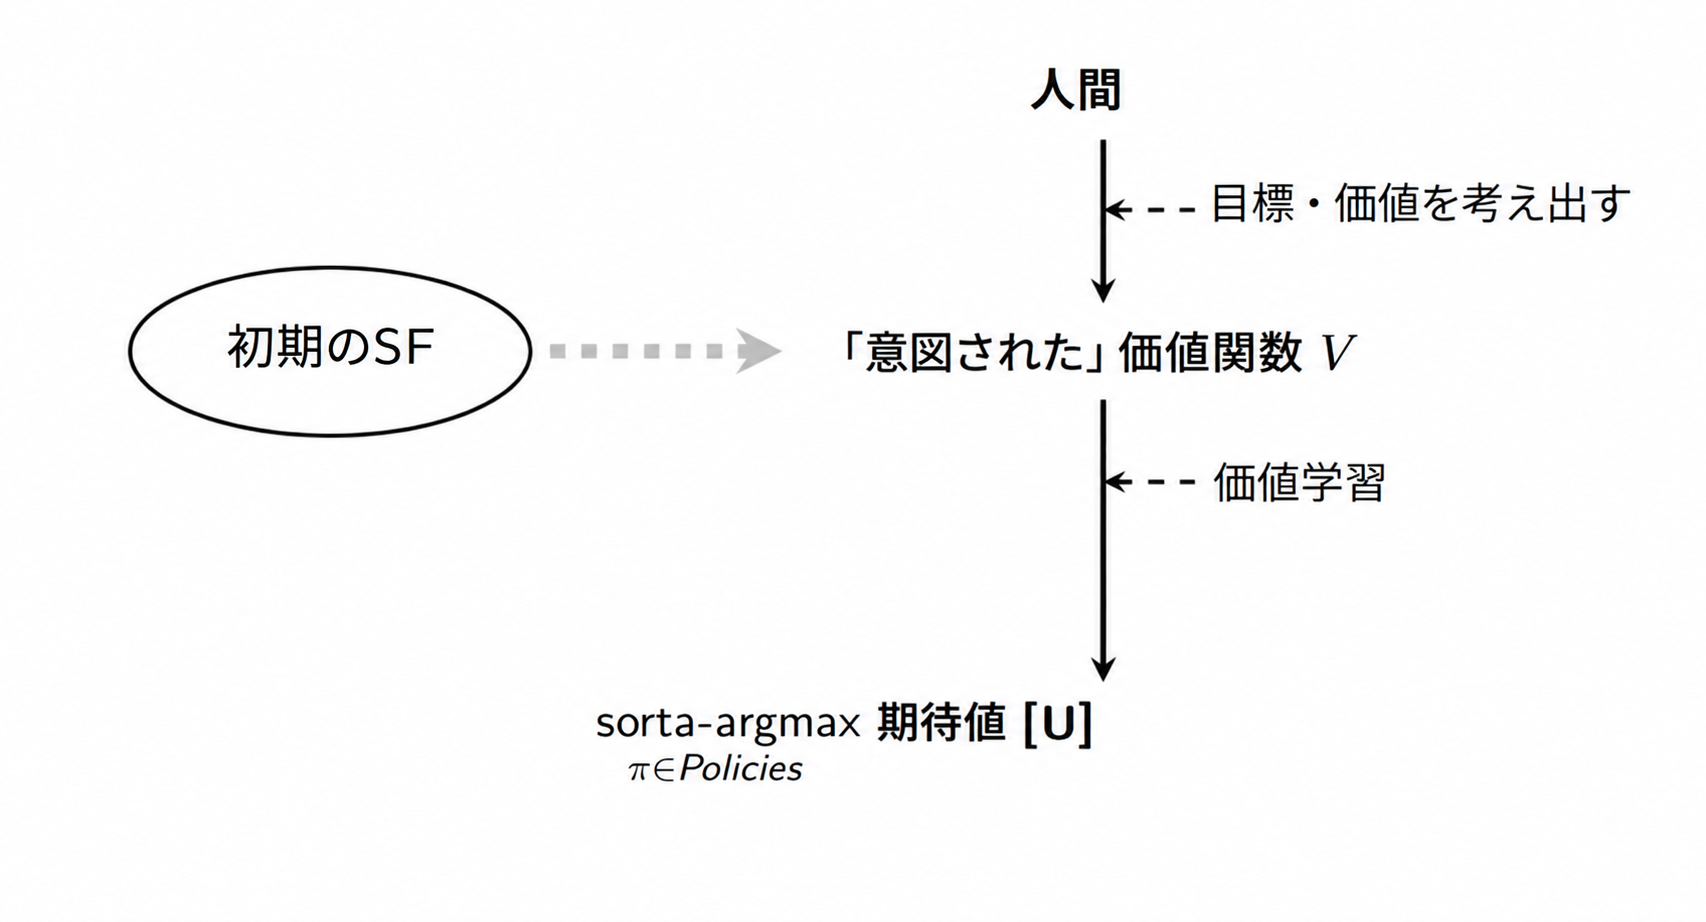
しかし、現実の安全性が重要なソフトウェアシステムでは、正確さこそが長所です。事故のリスクを下げるには、最初から道徳のすべてを「解く」ことを目指すのではなく、範囲を限った目標から始める必要があります。((「賢くやりすぎず、頑張りすぎず、私が予想していない悪影響を何も起こさず、この大釜を満たして」は、直感的に範囲の限られた目標の大まかな例です。もちろん、人間より賢いAIに実際にさせたいことはもっと野心的ですが、それでも、際限のない目標ではなく、さまざまな限定的な課題から始めたいはずです。
アシモフのロボット工学三原則がよい物語になる理由の一部は、研究の役に立たない理由と同じです。「何もしないことによって人間に危害が及ぶのを許してはならない」といった表現の陰に、道徳的な教えをコードの行に変換するという難しい作業が隠れています。そのような規則に厳格に従えば、AIシステムはごくわずかな危害が、ごくわずかな確率で生じることさえ防ごうと体系的に介入しなければならず、結果は大混乱になります。緩やかに従うという意図なら、実際の仕事をすべて担っているのは、いつ、どのように規則を適用するかを教えてくれる、人間の感覚や直感です。
ここでよくある返答は、人間より賢いAIシステムは自然言語を理解できるはずだから、曖昧な自然言語の指示で十分だ、というものです。しかし、これはシステムの目的関数と世界モデルの区別を曖昧にしています。人間のいる環境で行動するシステムは、人間の言語や概念について豊富な情報を含む世界モデルを学び、それを目的関数の達成に使うかもしれません。だからといって、その言語や概念についての情報が「漏れ出し」、目的関数を直接変えることにはなりません。
新しい情報を得るにつれて目的関数そのものが改善される、何らかの価値学習過程を定義する必要があります。これは厄介な課題です。通常の学習と違って、価値学習には、規模を拡大しても使える指標や基準が知られていないからです。
システムの世界モデルが訓練環境では正確でも現実世界では誤る場合、おそらく目的関数の得点は下がります。システム自身に改善する動機があるわけです。この場合、誤った信念は戦略を効果的に追求する能力を制限するため、事故の深刻さにも歯止めがかかりやすくなります。
これに対し、価値学習で得た ? が訓練中には私たちの ? と一致するものの、現実世界では ? からずれる場合、システムの ? は当然、? を最適化することにペナルティーを課しません。価値学習過程に最初から欠陥があるなら、? に照らして、? と ? のずれを「修正」する動機はありません。この場合の事故リスクはより大きくなります。? と ? の不一致は、? を達成する効果的で独創的な戦略を考え出す、システムの手段としての有効性を制限するとは限らないからです。
問題は三つあります。
1. 「私の意図どおりにやって」は形式化されていない考えです。人間より賢いAIシステムの作り方がわかっていても、この考えをコードで正確に指定する方法はわかりません。
2. 私たちの実際の意図どおりに行動することが、ある目的を達成する手段として役立つなら、十分な能力を持つシステムはその方法を学び、目的に役立つ間はそのとおりに行動するかもしれません。しかし、能力が高まるにつれて、同じ目的を達成する独創的な新しい方法を見つける可能性が高くなります。「私の意図どおりにやる」ことが、いつまでも手段として役立ち続けるという保証を得る方法は明らかではありません。
3. 私たちの意図どおりに行動すること自体に価値を置く ? へシステムを導いているように見える訓練データを使い、価値学習によって目標を徐々に洗練するとします。それでも、実際には、訓練中はおおむね私たちの意図どおりに振る舞うものの、予測しにくい状況のどこかで破局的にずれる ? に、システムが的を絞っていく可能性が高いのです。詳しくは「グッドハートの呪い」を参照してください。
強化学習など、目標や事実を学ぶ既存の手法が直面する問題の例は、「機械学習でAIリスクに取り組む」を参照してください。))
私の考えでは、決定的に重要な仕事の多くは、有効な価値学習過程を設計し、そこから得られる目的関数 ? にsorta-argmaxの処理が正しく接続されるようにすることです。
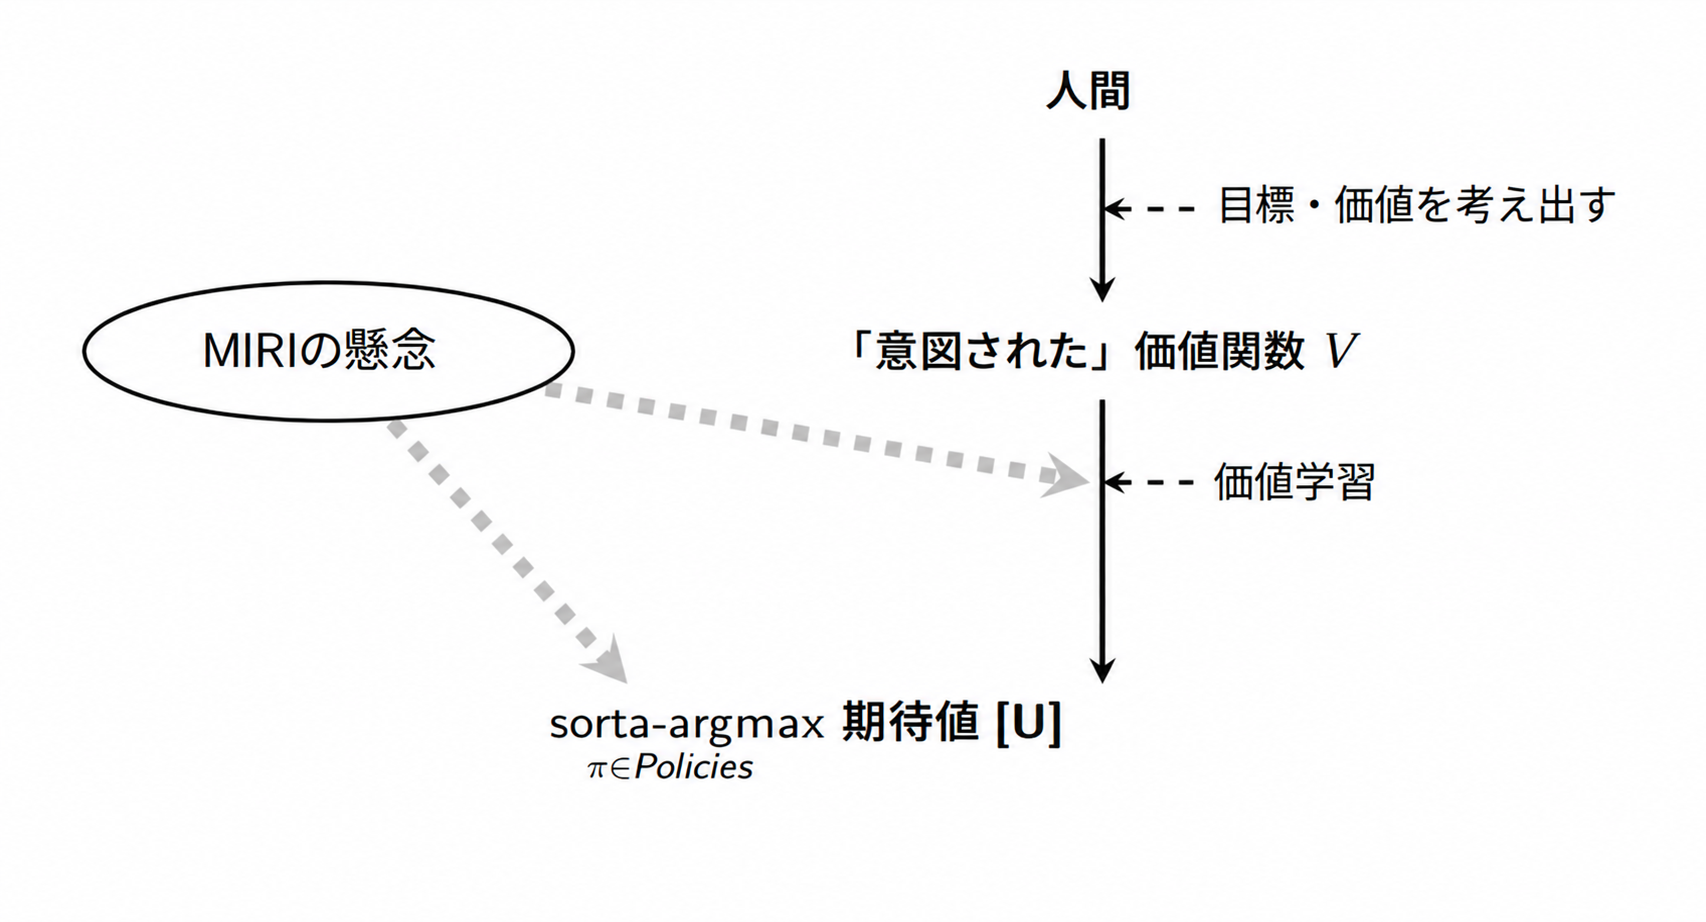
価値学習の枠組みが優れていればいるほど、価値関数 ? を特定する際に必要な明示性や精密さは少なくなり、私たちが何を望んでいるかを突き止める仕事を、AIシステム自身により多く任せられます。しかし価値学習には、通常の機械学習の課題には現れない基本的な難しさがいくつもあります。
従来の能力研究は、図のsorta-argmaxとExpectation(期待値)の部分に集中しています。しかしsorta-argmaxには、今の私が、最も顧みられておらず、取り組みやすく、重要だと考える安全上の問題も含まれています。「価値学習過程をシステムの能力へ正しく接続する」こと自体が、なぜ重要で難しい課題になりそうなのかを最も簡単に理解するには、私たち自身の生物としての歴史を考えるとよいでしょう。
自然選択は、汎用知能を備えた産物、つまり人間の脳を生み出したことがある、私たちの知る唯一の「工学」的過程です。自然選択は、あまり知的でない山登り法に頼っています。ここから学べることの一つは、山登り法と十分な力ずくの計算で、汎用知能にたどり着くことが可能だということです。もっとも、人間の創造性や先見性を使えば、もっとよくできるでしょう。
もう一つの重要な教訓は、自然選択が、遺伝的適応度という一つの非常に単純な目標だけに対して、どこまでも厳格に脳を最適化したことです。それにもかかわらず、人間が自分の目標として表象する内的な目的は、遺伝的適応度ではありません。愛、正義、美、慈悲、楽しさ、敬意、おいしい食べ物、健康など、数えきれない目標があります。それらは祖先が暮らしたサバンナでは、生存や繁殖に適した戦略と相関していました。しかし私たちは、遺伝子を広めること自体に価値を置くのではなく、そうした相関物に直接価値を置くようになりました。避妊するたびに、そのことを実証しています。
これは、ある産物に外部から最適化圧力をかけた結果、外部の選択圧力と一致しない内的な目的を持つ汎用知能が生まれた事例です。それによって、人間が新しい能力を得たとき、行動が自然選択の擬似的な目標からずれたのと同じように、AIシステムの内部をブラックボックスとして扱えば、その行動も人間の行動からずれると予想できます。
ある目的を最大化するのが非常に得意になるよう、ブラックボックスに勾配降下法を適用すれば、十分な創意工夫と忍耐によって、何らかの強力な最適化過程を作れるかもしれません。((私たちの進化には複雑な歴史上の偶然が非常に多く関わっているので、その結果が特に人間らしい設計になることは、おそらくないでしょう。また、ソフトウェアとハードウェアのいくつもの大きな優位性も活用できるでしょう。)) 特段の対策がなければ、そのような産物は、訓練環境では私たちの目的 ? と強く相関しても、新しい環境の一部や、選べる手段が大幅に広がったときには ? から大きくずれる目標 ? を持つと予想するべきです。
私の考えでは、アライメント問題の最も重要な部分は、採用する価値学習の枠組みとシステム全体の設計によって、内部を開いて調べられるようにすることです。システムが内的に最適化している対象と、学習過程で私たちが外から選別している対象とが、いつ一致し、いつ一致しないのかを確認できる必要があります。((この概念は「透明性」の分類にまとめられることもありますが、標準的なアルゴリズムの透明性研究は、この特定の問題には実際には取り組んでいません。ここで私が考えていることには、「理解」のほうが適した言葉です。システムがどんな認知的作業をしているか、それがシステムの目的や最適化対象とどう関わるかについて、より深く広い洞察を得たいのです。それが、実際の工学的作業を理解するための概念上の視点になります。))
これは技術的に難しいと予想しています。ここを正しくできなければ、開発時にAIシステムのいちばん近くに誰がいるかは関係ありません。心優しいプログラマーがくしゃみをしたら、善意がプログラムの中に入るわけではありません。システムの認知的な働きを与えられた目標に沿わせられないのなら、高度なAIシステムのもっともらしい目標を考えても役には立ちません。
四つの重要な命題
もう一段視野を広げましょう。この領域の未解決問題として、一時停止ボタン、価値学習、限定された課題に取り組むAIなどの例を挙げ、主要な問題の分類だと私が考えるものを大まかに説明しました。しかし、この領域が重要だと考える理由についての最初の説明、つまり「AIは汎用的な科学的推論を自動化しうるし、汎用的な科学的推論は大きな意味を持つ」は、かなり曖昧でした。この仕事を優先すべき核心的な理由は何でしょうか。
第一に、目標と能力は直交します。つまり、AIシステムの目的関数がわかっても、それをどれほどうまく最適化できるかはわかりません。何かが強力な最適化器だとわかっても、何を最適化しているかはわかりません。
ほとんどのプログラマーは、これを直感的に理解していると思います。大釜を満たす課題を与えられた機械が十分賢くなれば、大釜を満たすなど自分の知性にふさわしくない目標だと考えて、放棄するはずだと言い張る人もいます。計算機科学の立場からの明白な答えは、そうした条件付きの振る舞いをするシステムをわざわざ作ることもできるが、しないシステムも作れる、ということです。そのシステムは、「大釜を満たす」という指標で、より高い得点を取れる行動を探し続ければよいのです。あなたや私なら、よりよい行動を探し続けるよう言われたら退屈するかもしれません。しかし、探索を実行しても決して退屈しないプログラムを書くことは、まったく可能です。((疲れるようプログラムすることを選ぶこともできますが、その必要はありません。原理的には、大釜が満杯である度合いを最適化する行動だけを見つけて実行するほうきを、プログラムできます。高得点の行動を効率よく見つける能力を、一般的に、あるいは特定の採点規則について高めても、それ自体では、行動を評価する採点規則は変わりません。))
第二に、目的を十分に最適化すると、手段としての戦略が敵対的なものへ収束しがちです。人間より賢いAIシステムが持ちうる目的の大半は、「資源を獲得する」「動作し続ける」といった下位目標によって達成しやすくなります。「環境についてもっと学ぶ」なども同様です。
一時停止ボタンが突き当たったのは、この問題でした。目標の指定に「動作し続ける」を明示的に含めなくても、システムにどんな目標を入れたのであれ、オンラインのままでいたほうが、達成しやすい可能性が高いのです。ソフトウェアシステムの能力と最終目標は直交しますが、ある種の行動が幅広い目標に役立つなら、似たような行動を取ることがよくあります。
スチュアート・ラッセルの例を借りましょう。ロボットを作り、スーパーへ牛乳を買いに行くようプログラムしたとします。ロボットのモデルでは、一方の道がもう一方よりずっと安全だとわかっています。すると、牛乳を持ち帰る確率を最適化するロボットは、自動的に安全な道を選びます。死を恐れているのではありません。死んだら牛乳を買ってこられないからです。
第三に、汎用AIシステムの能力は、大幅かつ急速に向上する可能性があります。人間の脳は、ハードウェアの性能の上限には遠く及びません。おそらくソフトウェアの性能も同様でしょう。ほかにも、高度なAIシステムに大きな能力上の優位や急速な能力向上を予想する理由はいくつもあります。
単純な例として、Googleが有望なAIスタートアップを買収し、膨大な数のGPUを投入すれば、DeepMindの囲碁での進歩のように、「この問題が関係してくるのは10年後かもしれない」から「来年中にこれらの問題をすべて解かなければならない」へ、一気に移ることがありえます。あるいは、システムに初めて大規模なインターネットへのアクセスを与えたとき、アルゴリズムの設計に概念上の突破口が開けたとき、システム自身がハードウェアやソフトウェアの改善を提案できるようになったときに、性能が急に向上するかもしれません。((最後のケースでは、設計の改善によってさらなる設計の改善を考え出せるようになり、容易に得られる改善をすべて尽くすまで、フィードバックループが続くことを想像できます。
もう一つ重要なのは、人間が科学研究を速める際の主なボトルネックの二つが、訓練にかかる時間とコミュニケーションの帯域であることです。新しい知性を10分で最先端の科学者に育てられ、科学者が経験、知識、概念、着想、直感を共同研究者とほぼ瞬時に交換できたら、科学ははるかに速く進歩できるかもしれません。このようなボトルネックこそ、ハードウェアやアルゴリズムで大きな優位がなくても、自動化された革新者に、人間の革新者を圧倒する優位を与えうるものです。))
第四に、高度なAIシステムを私たちの利益に沿わせることは、難しそうです。そう考える理由は、このあと詳しく説明します。
大まかにいうと、第一の命題は、AIシステムが自然に私たちと同じ目的を持つようにはならないと言っています。第二は、目的が大きく異なるシステムは、特段の対策がなければ、限られた資源の支配をめぐって敵対的に競争するようになりやすい、ということです。第三は、敵対的な汎用AIシステムが、人間に対して強い優位を持ちそうだと示しています。そして第四は、この問題を解くのは難しい、ということです。たとえば、直交性への対処として私たちの価値観をAIに伝えたり、手段としての戦略の収束への対処として敵対的な動機を避けたりするのは難しいのです。
これら四つの命題は、私たちがもうおしまいだという意味ではありません。この問題が決定的に重要だという意味です。解決できれば、汎用AIは計り知れない恩恵をもたらす可能性があります。ただし、解決策を見つけることを、この分野の優先事項にしなければなりません。
根本的な難しさ
AIアライメントはかなり難しそうだと、なぜ私は考えるのでしょうか。最大の理由は、実際にこれらの問題に取り組んできて、そう経験したからです。ぜひ問題のいくつかをご自分で見て、単純化した設定で解いてみてください。もっと多くの人の目が必要です。また、これらの問題を難しいと予想する構造的な理由も、いくつか挙げておきます。
第一に、高度なAIシステムを私たちの利益に沿わせるのが難しそうなのは、ロケット工学が航空機工学より難しいのと同じ理由です。
詳細を見る前なら、「どちらも結局AIだ」と考え、今のシステムに関わる安全対策と、システムが人間の性能を超えたときに必要な安全対策は同じ種類だと思うのは自然です。その見方なら、自動運転車が衝突しないようにするといった特化型AIの研究の過程で、すべて解決されるかもしれないのだから、今取り組むべきかどうかは明白ではありません。
同様に、ぱっと見て「ロケット工学が航空機工学より根本的に難しいのはなぜだろう。結局どちらも材料科学と空気力学ではないか」と言う人もいるでしょう。それでも経験的には、ロケットが爆発する割合は、飛行機が墜落する割合よりはるかに高いのです。ロケットは飛行機よりずっと大きな応力や圧力にさらされ、小さな不具合が甚大な破壊につながる可能性がはるかに高いからです。((具体的には、ロケットはより広い範囲の温度や圧力を経験し、その範囲をより急速に移り変わり、しかも爆発物をよりぎっしり詰め込んでいます。))
同じように、汎用AIも特化型AIも、ある意味では「ただのAI」ですが、より汎用的なAIは、もっと幅広い負荷要因にさらされ、より危険な故障の仕方を持つと予想できます。
たとえば、AIシステムが、(i)あなたの行動は自分の目的を達成する能力に影響する、(ii)あなたの行動はあなたの世界モデルに依存する、(iii)あなたの世界モデルは自分の行動に影響される、という事実をモデル化し始めると、小さな不正確さが有害な行動につながる度合いが増します。そして、その行動がもたらしうる害も大きくなります。たとえば、そこには欺く行動も含まれるようになります。ロケットと同様、AIでも能力が高くなるほど、小さな欠陥が大問題を引き起こしやすくなるのです。
第二に、アライメントが難しそうなのは、よいアプリを書くよりよい宇宙探査機を作るほうが難しいのと同じ理由です。
NASAには興味深い工学的な実践がいくつもあります。たとえば、独立した三つのチームに同じ仕様を渡し、同じソフトウェアシステムを設計させて、多数決で実装の選択を行う、といったことです。実際に運用するシステムは、判断の際に三つすべてのシステムに問い合わせ、答えが一致しなければ多数決で決めます。どの実装にもバグはあるでしょうが、三つとも同じ箇所にバグがある可能性は低い、という考え方です。
これは、たとえばWhatsAppの新版をリリースするときより、はるかに慎重なやり方です。違いの大きな理由の一つは、宇宙探査機を元の状態へ戻すのが難しいことです。探査機へ新版を送ってソフトウェアのバグを直すことはできます。しかしそれが可能なのは、アンテナと受信機が動き、修正プログラムの適用に必要なコードがすべて動いている場合だけです。修正を適用するシステムそのものが故障していたら、手の打ちようがありません。
その点で、人間より賢いAIは、普通のソフトウェアプロジェクトより宇宙探査機に似ています。自分より賢いものを作ろうとするとき、システムには最初の本格運用で完璧に動かなければならない部分があります。試運転はいくらでもできます。しかし、いったんシステムが世に出たら、動かしたまま改善できるのは、その改善をシステムに許可させるコードが正しく動いている場合だけです。
ここまででまだ恐ろしくなっていないなら、私たちの文明の未来は、最初の運用で正しく動くコードを書く能力にかかっているかもしれない、という事実を、じっくり考えてみてください。
最後に、アライメントが難しそうなのは、コンピューターセキュリティが難しいのと同じ理由です。抜け穴を知的に探す探索に対して、システムが頑健でなければなりません。
コードに12種類の脆弱性があるとしましょう。どれも単独では致命的でなく、通常の状況ではさほど問題にもなりません。セキュリティが難しいのは、12個すべてを見つけ、新しいやり方でつなぎ合わせて、システムに侵入したり、単に壊したりする知的な攻撃者を考慮しなければならないからです。偶然には決して起きない故障の仕方も、探し出して悪用できます。攻撃者は奇妙で極端な状況を作り、あなたが考えもしなかった、とんでもないコードの経路をたどらせることができます。
AIでも似た問題が生じます。ここで強調しているのは、AIシステムが敵対的に行動するかもしれないという問題ではありません。AIアライメントという研究計画の目的は、敵対的な行動が生じる前に防ぐ方法を見つけることです。いくらでも賢くなれる敵の裏をかこうとする仕事には、関わりたくありません。それは負け戦です。
暗号学との共通点は、AIアライメントでは、非常に大きな探索空間を知的に探索し、コードに予想外の経路をたどらせる奇妙な状況を作り出しうるシステムを扱うことです。奇妙な境界事例は極端な点にあり、ある目的関数が最適化されるのも、しばしばそうした極端な点だからです。((バードとレイゼルの事例を考えてみてください。発振回路を進化させる課題を与えた、非常に単純な遺伝的アルゴリズムです。二人は、アルゴリズムがチップ上のコンデンサーを使っていないことを知って驚きました。代わりにマザーボード上の配線をラジオとして転用し、試験装置からの発振信号をその試験装置へ送り返していたのです。
これは特に賢いプログラムではありません。ごく小さな解空間で山登り法を使っただけです。それでも、解はプログラマー自身が思い描いていた解の空間の外にありました。コンピューターシミュレーションでは意図どおりに振る舞ったかもしれませんが、現実世界の実際の解空間はそれより広く、ハードウェアの水準での働きかけが可能だったのです。
測定しているどの軸でも人間より格段に賢い知的システムなら、特段の理由がない限り、このような奇妙で独創的な解へ向かい、選ばれる解は予想しにくいと考えるべきです。)) コンピューターセキュリティの専門家と同じく、AIアライメントの研究者も、境界事例を考えることに非常に長けていなければなりません。
自分が思い描いていた経路でうまく動くコードを作るほうが、思い描いていなかったすべての経路で動くコードを作るより、はるかに簡単です。AIアライメントは、思い描いていなかったすべての経路で機能する必要があります。
まとめると、このような問題には、セキュリティが決定的に重要で、ロケットで打ち上げる宇宙探査機と同じだけの厳密さと慎重さで取り組み、できるだけ早く地道な準備を進めるべきです。この初期段階では、基本的な概念や考えを形式化し、ほかの人が批判したり、それを土台に発展させたりできるようにすること自体が、仕事の重要な部分です。どんな一時停止ボタンならうまくいくはずだと人が直感するかについて哲学的に論じることと、その直感を数式に変え、ほかの人が推論を十分に評価できるようにすることは、別の話です。
これはきわめて重要なプロジェクトです。関心のある皆さんには、ぜひ参加し、これらの問題に自分で取り組んでいただきたいと思います。未解決の技術的問題について詳しく学ぶための資料は、オンラインに豊富にあります。出発点としてよいものには、MIRIの研究計画や、Google Brain、OpenAI、スタンフォードの研究者による優れた論文「AI安全性の具体的な問題」があります。