
技術ガバナンス
MIRIは現在、人工超知能がもたらす極端なリスクについて政策立案者と話し合い、汎用性を増していくAIモデルの開発を止めようとする活動に重点を置いています。私たちの技術ガバナンス研究は、こうした規制・政策目標に関わる技術的な問いを探究するものです。
技術ガバナンスの論文
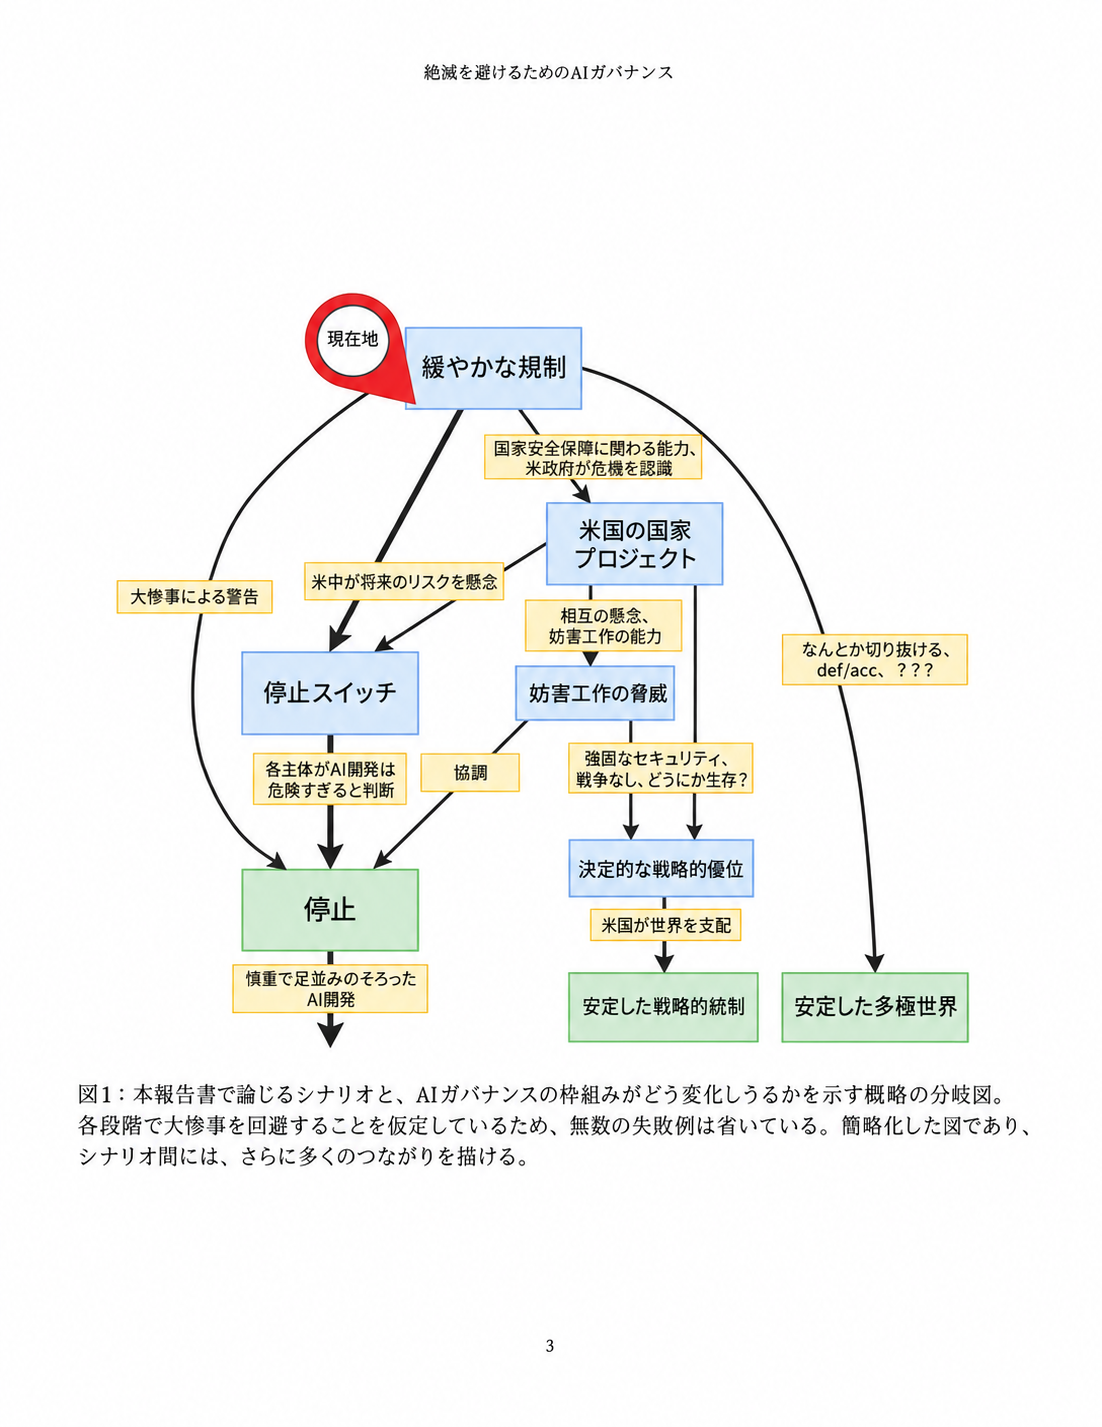
絶滅を避けるためのAIガバナンス:戦略的な状況と、取り組める研究課題
このAIガバナンス研究計画では、戦略的な状況についての私たちの見方と、実際に取り組める研究課題を示しています。これらの問いに答えられれば、AIによる壊滅的リスクや絶滅リスクをどう減らすかについて、重要な知見が得られるでしょう。
壊滅的リスクを防ぐためのAI評価に、できることとできないこと
AI評価は、AIガバナンスの手段の重要な一部であり、壊滅的リスクを防ぐために安全性の論証(セーフティケース)を行う、現在の取り組みの土台となっています。この論文では、評価から何がわかり、何がわからないのかを検討します。評価者が十分に力を注げば、AIの能力の下限を確かめ、一部の悪用リスクを評価できます。
しかし残念ながら、評価には、現在の枠組みでは克服できない根本的な限界があります。能力の上限を確定できないこと、将来のモデルの能力を確実には予測できないこと、自律AIシステムのリスクを頑健に評価できないことなどです。したがって、評価は価値ある道具ではあっても、AIシステムの安全を確保する主要な手段として頼るべきではありません。論文の結びでは、これらの根本的な限界が未解決のままであると認めつつ、フロンティアAIの安全性を少しずつ改善するための提案を示しています。
AI開発に関する国際合意の遵守を検証する仕組み
高度なAIシステムによる壊滅的リスクを減らすには、AI開発に関する国際合意が必要になるかもしれません。しかし、これほど重大な影響を持つ技術についての合意には、検証の仕組みが必要です。通常は違反の検知を通じて、相手が合意した規則に従っているとの確信を高める、手続きや道具のことです。この報告書は、三つの政策目標の例について、ありうる検証方法を概観します。各国が互いのAI開発・配備に関する主張を、実際にどう検証できるかを示すことが目的です。国際合意と国家が関わるAI開発に重点を置いていますが、これらの方法は企業への国内規制にも応用できます。理想的な検証方法の多くは、まだ技術的に実現できません。しかし、関係者に十分な政治的意思があれば、データセンターの現地査察など、アクセスを広げることで、そうした技術的方法の代わりになる場合が多いと強調しています。したがって、強い政治的意思があれば、強固な検証の仕組みを備えた野心的な国際協調を実現し、壊滅的なAIリスクを減らせるという希望を、私たちは持っています。
AIアラインメント
AIアラインメント研究は、人間より賢いAIを、絶滅規模の大惨事を引き起こさずに開発・配備できるようにするための、技術的問題の解決を目指します。
MIRIの20年以上の歴史の大部分において、中心となっていたのはAIアラインメント研究でした。しかし2024年、私たちは戦略転換を発表しました。MIRIでも分野全体でも、アラインメント研究の進み方は遅すぎました。かつてない大惨事を防ぐのに間に合うよう、この研究が成功する可能性は、きわめて低いと考えるようになったのです。
そのため、最近はAIリスクに対する政策的な解決策を見いだし、伝えることに重点を置いています。AIアラインメント研究も一部続けていますが、今では活動のかなり小さな部分です。
過去のAIアラインメント研究については、以下の論文などをご覧ください。
AIアラインメントの論文
修正可能性
AIシステムの知能と能力が高まるにつれ、プログラマーによる介入に抵抗する選択肢を持つことがあります。合理的なエージェントには通常、停止や選好の変更に抵抗する誘因があります。それにもかかわらず、作成者が修正のためとみなす介入に協力するAIシステムを、私たちは「修正可能」と呼びます。本論文では、修正可能性という概念を導入し、停止ボタンが押されたときにエージェントを安全に停止させようとする効用関数を分析します。その際、ボタンが押されるのを妨げたり、逆に押させたりする誘因を避けること、さらに、新しい下位システムを作ったり自己改変したりするときにも、停止する振る舞いが引き継がれることを、あわせて目指します。
論理的帰納
与えられた形式言語のすべての論理文に確率を割り当て、時間とともにその確率の精度を高める、計算可能なアルゴリズムを示します。このアルゴリズムが、直感的に望まれる性質をいくつも満たすこと、そしてそれらの性質が、株式取引との一連の類推から着想された「論理的帰納の基準」に従うことを示します。大まかに言えば、各論理文φに、φが真なら1株1ドル、そうでなければ無価値になる株式を対応させます。そして、論理的に不確実な状況にある推論者の信念状態を、市場価格の集合として捉えます。Pn(φ) = 50%とは、n日目に、φの株を、その推論者から50セントで買ったり、その推論者に50セントで売ったりできる、という意味です。論理的帰納の基準は、ごく大まかに言えば、有限のリスク許容度を持ち、多項式時間で計算できる取引戦略で、時間とともにその市場から無限の利益を得られるものが、存在してはならないというものです。
パラメーター付き有界レーブの定理と、有界エージェントの頑健な協力
古典的なゲーム理論では、互いに裏切ることが合理的だというのは、ごく普通の結論です。しかし近年の研究は、エージェントが、相手の条件付きの行動について強い保証を持つ状況では、そうした結果の多くを一般化できない可能性を示しています。本論文は、計算資源に限りのある有界エージェントにも、頑健な協力均衡が存在することを示します。その過程で、レーブの定理、ひいてはゲーデルの第二不完全性定理の、新しい一般化を証明します。このパラメーター付きのレーブの定理は、n文字以下で書き表せる証明について成り立ち、パラメーターnは、任意の数に設定できます。