
MIRIの使命は、「人間より賢い人工知能の創造が好ましい影響をもたらすようにする」ことである。どうすれば、そのようなことを確実にできるのだろうか。とりわけ、現時点では研究対象にできる人間より賢い機械が存在しないことを考えれば、気の遠くなるような仕事である。前回の記事では、私たちの使命の動機となる四つの背景的主張を論じた。本稿では、この難題へ取り組む私たちのアプローチを説明する。
この難題は大きく、私たちが取り組めるのは問題の一部だけである。そのため、私たちは研究対象を専門化している。最も大きな二つの限定的な仮定は、次のとおりである。
私たちは、人間より賢い機械知能が、(例えば脳エミュレーションではなく)一から作られる de novo ソフトウェアシステムで初めて実現されるシナリオに焦点を当てる。
その理由の一つは、誰かが脳で使われるアルゴリズムをリバースエンジニアリングし、ソフトウェアシステムで利用するより先に、脳エミュレーションへ完全に到達するのは難しそうだからである。もう一つは、信頼性が非常に高いAIシステムには、安全性と透明性のために少なくとも一部の構成要素を一から作る必要があると予想しているからだ。とはいえ、初期の超知能システムが人間の設計したソフトウェアではないことも十分あり得る。私は、ほかの経路に沿ってリスクを減らすことへ焦点を当てる研究計画を強く支持する。
私たちは、ほぼ全面的に技術研究を専門とする。
研究者を選ぶ基準は、予測の専門性や政治的手腕ではなく、数学とコンピューター科学の習熟度である。これはパズルの一部分にすぎないと強調しておきたい。適切なシステムの作り方を解明しても、実際にそのシステムが作られなければ役に立たない。また、AIが好ましい影響をもたらすようにすることは、単なる技術的問題ではない。手抜きを促す短期的な誘因に直面するなかでの、世界的な協調問題でもある。こうした非技術的な難題へ取り組むことは重要だが、私たちはそこに焦点を当てていない。
要するに、MIRIは、de novo のAIソフトウェアシステムが好ましい影響をもたらすようにするための技術研究を行う。AIソフトウェアシステムの種類をさらに選別することはなく、AIシステムが超知能へどれほど速く到達すると予想するかについても、強い主張はしない。むしろ現在のアプローチでは、次の問いを用いて未解決問題を選ぶ。
たとえ難題がはるかに単純であったとしても、私たちには何がまだ解けないだろうか。
例えば、計算能力が大量にあり、目標が非常に単純であったとしても解けないAIアライメント問題を研究することが考えられる。
次に、問題を三つの基準で絞り込む。(1)今日、生産的な数学研究を行えるという意味で、取り組み可能であること。(2)通常の能力研究では扱われそうにないという意味で、取り組む研究者が少ないこと。(3)私たちが先に解決しておかない限り、機械へ安全に委ねられないという意味で、決定的に重要であること。(知的な機械を設計することが目標なのだから、いずれその機械へ委ねられると予想できる技術的問題は多い。しかし、信頼性の高い推論を設計する仕事を、信頼できない推論主体へ任せるのは難しい!)
この三つの基準は、通常であれば異論を招かない。ここで議論を呼ぶ主張は、「たとえ難題がもっと単純でも、私たちには何が解けないだろうか」という先の問いが、解決すれば将来、そのアーキテクチャーを問わず、より安全で信頼性の高いAIソフトウェアの設計に役立つような、未解決の技術的問題を生み出す、というものである。本稿の残りでは、この主張を正当化し、その背後にある推論を説明する。
1. なぜ動くかを理解せずに強力なAIシステムを作るのは危険である。
機械超知能がもたらすリスクの大部分は、人々が十分に理解していないシステムを作る可能性から生じる。
現在、これは実務ではごく普通のことである。現代のAI研究者の多くは、深層ニューラルネットワークがなぜそれほどよく機能するのかを説明する理論的基礎や、内部で何が起きているかについての確かな理解がないまま、その能力を押し広げている。こうした欠点には、時間とともに対処が進んでいる。現在、多くのAI研究者がニューラルネットワークの透明性を高める道具へ取り組み、さらに多くの研究者が深層学習システムの理論的基礎を築こうとしている。それまでの間にも、試行錯誤で現代のAIシステムの能力を高めることは、多くの有用な応用を生み出してきた。
対照的に、超知能の主体を設計するときには、オンラインでの試験を始める 前に 、その安全性へ異例なほど高い確信を持ちたい。その領域では、試行錯誤だけでは不十分である。
例として、バード(Bird)とレイゼル(Layzell)が2002年に行った研究を考えよう。二人は、単純な遺伝的プログラミングを使い、回路基板上に発振回路を設計した。遺伝的アルゴリズムが見つけた解の一つは、内蔵コンデンサー(人間が設計する発振器には不可欠なハードウェア)をまったく使わなかった。その代わり、マザーボード上の回路配線を無線受信機として転用し、近くのコンピューターから出る発振信号を増幅したのである。
これは、強力な探索過程が、しばしば予期しない経路で目標へ到達できることを示している。もしバードとレイゼルが、ほかのコンピューターが近くにあるかどうかにかかわらず、さまざまな回路基板で使える堅牢な発振回路のコードを遺伝的アルゴリズムに見つけさせようとしていたなら、ひどく失望しただろう。一方、彼らが関連すると 考えた 回路基板の特徴はすべて再現しつつ、「回路配線は無線信号を運べる」といった特徴は含まない仮想回路基板上でアルゴリズムを徹底的に試していたなら、試験中に失敗の可能性へ気づかなかっただろう。単純な遺伝的探索アルゴリズムを扱うときでさえ問題になるのなら、人間より賢い探索過程を扱うときには、はるかに大きな問題になる。
人間より賢い機械知能を設計する場合、徹底的な試験は不可欠だが、それだけでは十分でない。現実世界で稼働させたとき、システムが予期しない悪い解を見つけないと確信するためには、経験的な試験データ に加えて 、探索過程がどう機能し、満足できる解だけを生成すると予想されるのはなぜかを、確実に理解しておくことが重要である。
MIRIの研究計画は、人間より賢い探索過程を導入する前に、それを調べて分析するために必要な道具を、私たちが確保できるようにすることを目指している。
類推すると、ニューラルネット研究者は、確率論を形式的にまったく理解していなくても、おそらくかなり先まで進めただろう。しかし確率論がなければ、現代のAIアルゴリズムを理解するための道具を欠くことになる。ベイジアンネットワークを知らず、「独立同分布」といった仮定を定式化する方法も知らず、マルコフ決定過程がどの条件で機能し、どの条件で失敗するかもよくわからないだろう。事前分布について論じることも、事前確率がゼロである箇所を調べることもできない(したがって、システムが学習できないものを特定できない)。誤差の上界を論じたり、最終的に最適な方策を見つけるアルゴリズムについて、きれいな定理を証明したりもできないだろう。
それでもおそらく、かなり先までは進めただろう(そして、こうした発想の多くについて、未完成で場当たり的な代用品を生み出しただろう)。しかし確率論がなければ、信頼性の非常に高いAIアルゴリズムを設計するのは、もっと難しいと私は予想する。MIRIの研究者は、AI理論には同じように大きな部分がまだ欠けていると考える傾向があり、私たちの研究計画が開発しようとしているのは、まさに その 道具である。
2. 私たちは、総当たりでさえ有益なAIシステムをまだ作れない。
木星ほどの大きさのコンピューターがあり、目標は非常に単純だと想像しよう。宇宙にできるだけ多くのダイヤモンドを存在させるのである。そのコンピューターはインターネットと、いくつものロボット工場・研究所へアクセスできる。そして「ダイヤモンド」とは、ほかの四つの炭素原子と共有結合した炭素原子を意味することにする。(どのような方法でダイヤモンドを作るか、炭素を得るために何を分解しなければならないかは気にしないことにしよう。目的は、単純化した問題を研究することだからである。)木星サイズのコンピューターがPythonを実行しているとしよう。大量のダイヤモンドを作るには、どうプログラムすればよいだろうか。
現状では、そのような目標を達成するようコンピューターをプログラムする方法を、私たちはまだ知らない。
私たちは、汎用人工知能を 総当たりで 作ることさえまだできない。これは、まだ理解していない部分が問題に含まれていることを示す。
一方、AIの課題には 総当たりで解ける ものも数多くある。例えば、コンピュータービジョンの問題を ものすごく上手に 解くプログラムは書ける。壊せない箱があり、画像とそれについての質問を出し、答えを待ち、答えの正確さを採点してから、この過程を繰り返すとしよう。その箱とやり取りし、質問へ非常にうまく答えられるようになるプログラムをどう書けばよいかはわかっている。(そのプログラムは本質的に、AIXIの計算量を有限に制限した版になる。)
同様の方法で、会話とそれについての質問を出し、質問への自然言語の答えを待ち、正確さを採点する壊せない箱があるなら、この場合も、非常にうまく答えられるようになるプログラムを書ける。この意味では、コンピュータービジョンと自然言語処理を総当たりで解く方法を知っている。(もちろん、自然言語処理が実用上「解決済み」にはほど遠く、なすべき仕事はまだ山ほどある。総当たりの解は、現実世界ではほとんど役に立たない。重要なのは、AIアライメント問題の多くについては、「総当たりなら解ける」という段階にさえまだ達していないという点である。)
上の例で、なぜ壊せない箱が必要なのだろうか。現代的な総当たりの解法は、(ある複雑さの上限までの)各チューリング機械を、箱についての仮説として検討し、観測と整合するものを調べ、残った仮説を単純さで重みづけして予測したとき、箱から高い得点が出る行動を実行する、という方法になるからである。
各仮説は中身の見えないチューリング機械であり、アルゴリズムはその内部を決してのぞかない。ある一連の行動を実行したら箱がどの得点を出すか、それぞれの仮説へ予測させるだけである。つまり、アルゴリズムが(網羅的な探索によって)箱から出る得点を 最大化する 計画を見つけ、箱が破壊可能であれば、得点を最大化する不透明な一連の行動は、箱をこじ開け、常に最高得点を出すよう改変するものである可能性が非常に高い。しかし箱が壊せないなら、答えを総当たりで求める方法はわかっている。
実のところ、大まかに言えば、私たちは あらゆる 強化学習問題を総当たりで解く方法を理解している。これは、強化学習問題を 実用的に 解く方法を知っていることとは、まったく違う。それでも、二種類の問題の間にある種類の違いを示している。AIの問題は、(不完全かつ発見的ではあるが)次のように分けられる。
AIには、二種類の未解決問題がある。一つは、原理上の解き方を知っている問題を、実際にどう解くかを見つけることである。もう一つは、まだ総当たりで解く方法さえ知らない問題を、原理上どう解くかを見つけることである。
MIRIは、二番目の種類の問題に焦点を当てる。((AI分野の大半は、一番目の問題に焦点を当てる。例えば深層学習は、総当たりなら解けるとわかっているものの、数年前までは手に負えないほど計算困難だった問題を解くための、非常に強力で刺激的な道具である。第1種の問題は、AIシステムの能力を高めるうえでは重要になりやすいが、高い能力を持つシステムを私たちの利益にアライメントするうえでは、優先度が低い。))
ダイヤモンドを作る主体を総当たりで構築するのは、何が難しいのだろうか。説明のため、複雑な環境のなかで生産的に行動するためにAIプログラムが行う必要のあることを、大幅に単純化して示す。
- 世界をモデル化する。知覚入力を受け取り、それを使って、システムが埋め込まれた世界についての内部表現を洗練する。
- 世界を予測する。その世界モデルを用い、システムがさまざまな計画を実行したら何が起きるかを予測する。
- 帰結を順位づける。予測した未来がどれほど望ましいかによって可能性を評価し、高く評価された帰結へつながる計画を実行する。((もちろん現実には、これらの段階は明確に分かれていない。「予測」の段階は、明らかに低く評価される帰結の予測へ計算を浪費しないよう、順位づけに依存する計画段階に近いものにならなければならない。世界モデルのどの部分を洗練するかは、それを何に使うかによって決まるため、モデル化の段階は予測の段階に依存する。現実的な主体なら、メタ計画を用いて、こうした活動の間へ資源をどう配分するかを判断する必要がある、などである。それでも、この図式は最初の近似としては十分である。システムが途中のどこかで、世界のモデル化、帰結の予測、順位づけに類することをしなければ、未来を方向づけるのに苦労するだろう。))
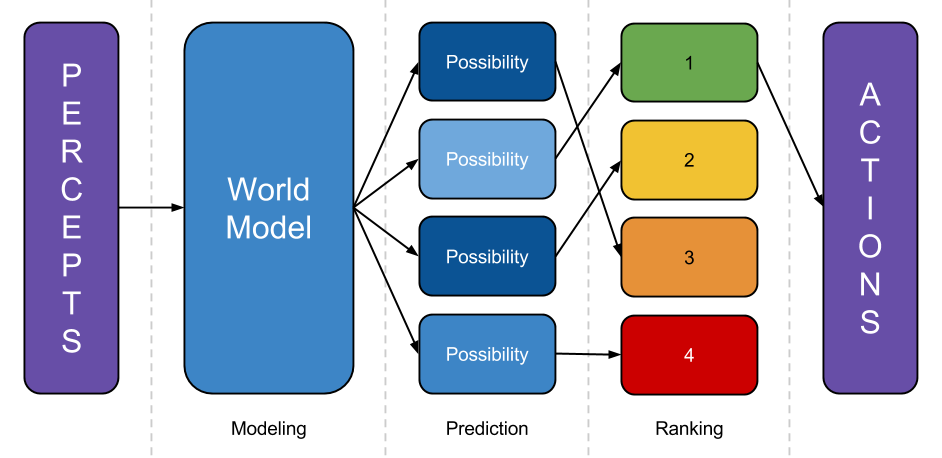
モデル化の段階を考えよう。先ほど述べたように、優れた世界モデルを総当たりで見つけるアルゴリズムの書き方はわかっている。単純さで重みづけした非常に多くのチューリング機械を調べ、それらが観測を生成しているものとして扱い、それまでの観測と整合しないものを捨てる。しかし(途方もなく非実用的であることを別としても)、これで得られる仮説は 中身が見えない ものだけである。システムは、それぞれのチューリング機械が出力する「感覚ビット」を尋ねられるが、内部をのぞき、そのなかに表現されている物体を調べることはできない。
中身の見えないチューリング機械が出力する、明確に定義された何らかの「得点」があるなら(強化学習問題のように)、各仮説がブラックボックスでも問題にならない。総当たりアルゴリズムは、多数の入力でブラックボックスを実行し、どれが最高得点をもたらすかを見るだけでよい。しかし問題が、現実世界で大量のダイヤモンドを作ることであるなら、主体は次のように働かなければならない。
- 世界のモデルを構築する。そこには、炭素原子や共有結合などが表現されている。
- システムが実行できるさまざまな行動に応じ、世界がどう変化するかを予測する。
- それぞれの予測の 内部 を見て、どの未来予測に最も多くのダイヤモンドがあるかを調べる。より多くのダイヤモンドへつながる行動を実行する。
言い換えれば、世界に存在する物事 へ確実に影響を与えるよう作られたAIには、検査可能な世界モデルが必要である。システムは世界モデルをこじ開け、炭素原子と共有結合の表現を特定し、現実世界にどれほどのダイヤモンドがあるかを推定できなければならない。((強化学習問題では、監督者が望むものを間接的に代用するための特別な「報酬チャンネル」によって、この問題を避ける。(例えば学習主体が、ダイヤモンド作りに役立つと監督者に思える行動を取るたび、監督者が報酬ボタンを押すかもしれない。)するとプログラマーは、世界モデル内の報酬チャンネルを手作業で指定し、高い報酬につながると予測する行動を実行するようシステムをプログラムできる。これは、システムが炭素原子と共有結合の表現を確実に特定できるよう世界モデルを設計するより、はるかに容易である(特に、ある日はニュートン力学で、次の日には量子力学で世界をモデル化する場合はそうだろう)。しかし、何らかの目標を達成する方法を自律的に学ばなければならない主体の枠組みにはならない。高度に知的なシステムの正しい振る舞いは、それより大幅に知能の低いシステム(例えば人間の監督者)が制御する報酬信号の最大化へ、常に還元できるわけではない。))
「検査可能な」世界モデルをどう構築するかについて、総当たりの方法さえ、私たちはまだ明確に思い描けない。ダイヤモンド作成プログラムのうち、世界モデルを構築する部分を書こうとするところを想像しよう。この関数は、知覚入力を受け取り、宇宙を表すデータ構造を構築する必要がある。その表し方は、システムが宇宙の記述を調べ、ある未来にあり得るダイヤモンドの量を推定できるものでなければならない。データ構造のどこに炭素原子があるのか。世界モデルがダイヤモンドを原子でできたものとして表現するのをやめ、代わりに陽子、中性子、電子でできたものとして表現し始めた後も正確であり続けるように、「共有結合」という概念を形成し、ラベルづけできるデータ構造とはどのようなものだろうか。
世界を多層的に表現し、(量子力学を発見することで)モデルが大幅に変化しても、システムが同じ目標(ダイヤモンドを作ること)を追求できる世界モデル構築アルゴリズムが必要である。これは、中身の見えないチューリング機械を仮説として用いる既存の総当たり解法とは著しく異なる。((単なる 予想される知覚入力 ではなく、モデル化された 世界についての事実 に従って最適化する探索アルゴリズムという発想は、基本的なものに聞こえるかもしれない。しかし、この発想を(例えば総当たりアルゴリズムとして)形式化できるようにする深い洞察(あるいは巧妙な工夫)は、まだ見つかっていない。形式化できれば、自己参照的で、論理的不確実性を伴い、プログラマーが検査できる推論に必要な、物体と事実の抽象的なモデル化について、理解が深まる可能性が高い。))
人間 が宇宙について推論するとき、私たちはある種、中間から外側へ向かう推論をしているように見える。まず人や岩といったものをモデル化し、やがてそれらが原子ででき、原子が陽子、中性子、電子ででき、それらが量子場の摂動であることに気づく。私たちはどの時点でも、モデルの最下層が現実の最下層だとは確信していない。世界について考え続けるなかで、モデルにある不自然な点を説明するため、新たな仮説を 構築する 。そこで使っているデータ構造はどのようなものなのか。新しい洞察を得たとき、世界モデルへどう階層を追加するのか。これは、どう形式化すればよいか、まだ理解していない種類の推論アルゴリズムである。((多層的な世界モデルを構築する総当たりアルゴリズムは、ソロモノフ帰納よりはるかに「縮小」しやすく、したがって、実用的な環境で多層世界モデルをどう構築するかについて、何らかの洞察を与えるだろうとも考えている。))
これは、単純な目標を確実に追求するAIを総当たりで作るうえでの 第一 段階にすぎない。第二段階と第三段階を総当たりで解く方法も、まだわかっていない。例えば、より多くの難点を生む現実的な目標ではなく、ダイヤモンドについて話すことで問題を単純化すると、原理上でさえ、まだ解き方のわからない部分を問題から切り分けられる。私たちの技術研究課題は、この方法で特定した未解決問題をいくつも説明している。
3. 原理上の問題の解き方を見つけると、多くの利益が得られる。
1836年、エドガー・アラン・ポー(Edgar Allen Poe)は、チェスを指せると称された機械、メルツェルの機械仕掛けのトルコ人について見事な論考を書いた。そのなかでポーは、この「機械仕掛けのトルコ人」はいかさまに違いないと論じる。まず機械はチェスを指せないと主張し、続いて(舞台演出の知識を使って)機械の内部に人を隠せる仕組みを説明する。ポーの論考は驚くほど洗練されていて、楽しく読める。「バベッジ氏の計算機」に触れ、それでチェスを指すことは到底できないと論じている。計算機では、各段階が必然的に前の段階から導かれるが、チェスでは「どの一手も、別の一手から必然的に続くものではない」からだという。
機械仕掛けのトルコ人は、実際にいかさまだと判明した。しかし1950年、クロード・シャノン(Claude Shannon)は、完全なチェスを指すようコンピューターをプログラムする方法を説明する論文という形で、ポーの推論へかなり説得力のある反論を発表した。
シャノンのアルゴリズムで、議論が終わったわけでは決してない。その論文から、人間の世界チャンピオンを破る実用的なチェスプログラム、ディープ・ブルー(Deep Blue)までは46年かかった。それでも、ポーの知識水準しか持たず、ゲーム木を構築してバックトラック探索を行うアルゴリズムを理解していないために、コンピューターがチェスを指すことが 可能か さえ確信できないなら、実用的なチェスプログラムを書き始める準備は、おそらくまだできていないだろう。
同じように、ベイズ推論の理解や、悪い事前分布から生じる限界といった確率論の道具を欠いていれば、重大な結果を伴う状況で不確実性を扱う必要のあるAIシステムをプログラムする準備は、おそらくできていない。
プログラムを書こうとしているのに、いくらでも大きなコンピューターがある場合にどう書くかさえ説明できないなら、総当たり解法の実用的な近似を設計する準備は、おそらくまだできていない。実用的なチェスプログラムは完全な探索木を生成できないため、ヒューリスティック(経験則)と近似へ大きく依存する。しかし、いくらでも多くの 計算能力を与えられても総当たりで答えを出せないなら、重要な概念的道具を何か欠いている可能性が高い。
AIXIの考案者マーカス・フッター(Marcus Hutter)と、知能の普遍的尺度(Universal Measure of Intelligence)の考案者シェーン・レッグ(Shane Legg)も、このアプローチを支持しているように見える。二人の研究は、あらゆる強化学習問題へ総当たりの解を見つける方法を記述したものと解釈できる。実際、先ほどの方法の説明は、レッグとフッターによるものである。
実際、Google DeepMindの創業者は、AGIへ取り組み始める好機が来たことを示す四つの主要な指標の一つとして、シェーンの博士論文の完成を挙げている。強化学習問題を 原理上 どう解くかを記述する理論的枠組みは、問題についての現代の理解が、実践的な研究を始める時点まで成熟したことを示したのである。
問題を形式的に理解する前には、その問題が 何であるか さえ、はっきりとはわからない。推論の穴を見落とすかもしれず、適切な道具を使えないかもしれず、進歩しているかどうかを判断できないかもしれない。問題を原理上、形式的に理解した後なら、実践的な進歩を遂げるための態勢が整う。
問題を形式的に理解する目的は、その結果得られるアルゴリズムを 実行する ことではない。ディープ・ブルーは、完全なゲーム木を計算することで動いたわけではなく、DeepMindもAIXIを実装しようとしているわけではない。目的はむしろ、問題を解くために役立つ基本的な概念と方法(チェスの場合なら、ゲーム木とバックトラック探索アルゴリズムなど)を特定し、発展させることである。
確率論の発展はAI分野へ大いに役立ってきた。完全なベイズ推論主体を誰かが作ろうとするからではなく、確率論が、不確実性のもとで推論するための統一理論だからである。このため、実装の細部がいくら異なるAI設計にも、確率論の道具は役に立つ。不確実性を扱おうとするアルゴリズムを構築するときはいつでも、そのシステムが成功する領域と、失敗し得る条件について考えるうえで、確率的推論をしっかり理解していることが有用である。
だからこそ、今日取り組めて、未来の汎用知能機械がどのように設計されても(あるいは、そこへ到達するまでどれほど時間がかかっても)確実に役立つ未解決問題を特定できる、と私たちは考える。問題がはるかに容易であっても解けない問題を探すことで、AGIの中核アルゴリズムが欠けている箇所を特定したい。それらの問題へ原理上どう取り組むかを形式的に理解することで、実際に取り組む時が来たとき、プログラマーが深く理解した解決策を開発するための知識と、構築するシステムの信頼性を非常に高くするための道具を持てるようにすることを目指す。
4. これは、過去に研究者が成功を収めてきたアプローチである。
私たちが未解決問題を生み出すために使う主な問い、「たとえ問題がもっと容易でも、私たちには何が解けないだろうか」は、実は数学とコンピューター科学の全般で、かなり一般的に使われている。少し言い換えると、もっと見覚えのある形になる。「有益なAIを構築する問題を、別のもっと単純な問題へ還元できるだろうか。」
例えば、木星サイズのコンピューターをダイヤモンドの生産用にプログラムできるかと尋ねる代わりに、ダイヤモンド最大化問題を、既知の推論・計画手続きへ還元できるかという問いに言い換えられる。(現在の答えは「まだできない」である。)
これはコンピューター科学では、ごく標準的な方法である。ある問題を別の問題へ還元することは、計算可能性理論の主要な特徴である。数学では、ある問題を別の問題へ還元することで証明を得ることがよくある(例えば、有名なフェルマーの最終定理の場合を参照)。これにより、問題のうち 解かれていない 部分へ焦点を当て、基礎的な理解が欠けている主題を特定できる。
実のところ、人間はこの種の問題へ取り組む点では、かなりよい実績を持っている。人類は長期的な技術動向の予測をあまり得意としてこなかったが、十分に努力を注ぐなら、技術的問題の理論的基礎を数十年前から開発することには、まずまず成功している。アラン・チューリング(Alan Turing)とアロンゾ・チャーチ(Alonzo Church)は、堅固な計算理論の開発に成功し、コンピューターが開発されると非常に有用であることがわかった。その成功の大部分は、機械でどう解けばよいかまだわからない問題を、(原理上)どう解くかを突き止めたことによる。同じように、アンドレイ・コルモゴロフ(Andrey Kolmogorov)は、直感的にはわかるものの、まだ十分に理解されていなかった不確実性の扱い方を形式化しようとし、成功した。クロード・シャノンと同時代の研究者も、チェスについてこの試みに成功した。
確率論の発展は、私たちの場合を考えるうえで、とりわけよい類例である。何百年もの間、「不確実性」という直感的な概念を形式化しようとした哲学者と数学者が、推論の末に何度もパラドックスと矛盾へ陥った分野だからだ。当時の確率論は形式的基礎をひどく欠き、「不運の理論」と呼ばれた。それでも、コルモゴロフらが力を合わせて理論を形式化する試みは成功し、その仕事は、不確実性のもとで信頼性高く推論するシステムを設計するための、多数の有用な道具の発展を促した。
(ある程度は直感的に理解されていたものの、まだ形式化されていない)新たな研究分野に基礎を据えようとした人々の多くが成功し、その成功は実用上も大きな意味を持った。私たちは、信頼性が非常に高い推論主体の設計に関する、いくつもの未解決問題について、同じようなことを目指す。
「論理的不確実性を理想的にはどう扱うべきか」「複雑な環境の多層的な世界モデルを理想的にはどう構築すべきか」といったMIRIが焦点を当てる問いは、コルモゴロフの「経験的不確実性を理想的にはどう扱うべきか」や、フッターの「どれほど複雑な環境でも、報酬を理想的にはどう最大化すべきか」と同程度に一般的な水準にある。歴史上の実績は、こうした問題なら、(a)前もって到来を見越すことと、(b)汎用知能の具体的かつ実用的な実装へアクセスせずに取り組むことの両方が可能だと示唆している。
問題がもっと容易であっても解けない部分を特定することで、中核的なアルゴリズムと洞察が欠けている部分へ狙いを絞りたい。そのアルゴリズムと洞察は、初期の知的な機械がどのようなアーキテクチャーを採用しても、人間より賢い機械知能が作られるまでどれほど長くかかっても役に立つ。
現在、私たちの研究チームには3人しかおらず、自分たちで取り組める問題の数は限られている。しかし、このアプローチは大幅に規模を拡大できる。非常に多くの未解決問題を生み出しており、研究すべき問いには事欠かない。((例えば、大量の計算能力を与えられたときにどの問題が残るかと尋ねる代わりに、アライメントされたAIを構築する問題を、人間の振る舞いについて信頼できる予測を行う問題へ還元できるか、と尋ねることもできる。このアプローチはほかの人々も提唱している。))
これは、新しい研究分野へどう取り組むべきかを理解しようとする人間が、過去に何度も成功させてきたアプローチである。そして私は、このアプローチが、まだ若いAIアライメント分野の中核的な難関のいくつかへ、私たちを導いていると確信している。