
今年5月、私はスタンフォード大学の記号システム特別講演者シリーズで、「AIアライメント問題――なぜ難しく、どこから始めるべきか」という講演を行った。その映像がYouTubeで公開された。
イライザー・ユドコウスキー(Eliezer Yudkowsky)――AIアライメント:なぜ難しく、どこから始めるべきか
講演と質疑応答のほぼ完全な記録は こちら、スライドは こちら、注記と参考文献は こちら にある。10月にニューヨーク大学で行った、この講演の短縮版「高度なAIをアラインさせる根本的な難しさ」にも関心を持つかもしれない。
講演では、AIアライメント(AIの目標や行動を人間の意図・価値に沿わせること)における未解決の技術的問題をいくつか紹介し、それらが収まる全体像と、この比較的新しい分野で働くとはどのようなことかを論じる。以下に、スライドを添えた講演記録の短縮版を掲載する。
講演の構成:
1.1. 一貫した意思決定は効用関数を含意する
1.2. 大釜を満たす2.1. 低インパクト・エージェント
2.2. 停止ボタンを備えたエージェント
2.3. 自己改変における安定した目標3.1. なぜアライメントが必要なのか?
3.2. なぜアライメントは難しいのか?
3.3. NASAと暗号技術からの教訓4. 現在地
エージェントとその効用関数
この講演では、「あなたはいったい一日中何をしているのか?」という、よくある質問に答えてみたい。私たちが関心を持つのは、現在の水準を超えて進歩し、プログラムされた目標が何であれ、その達成に向けて十分に質の高い意思決定を行うことで、懸念の対象となる人工知能の理論である。
一貫した意思決定は効用関数を含意する
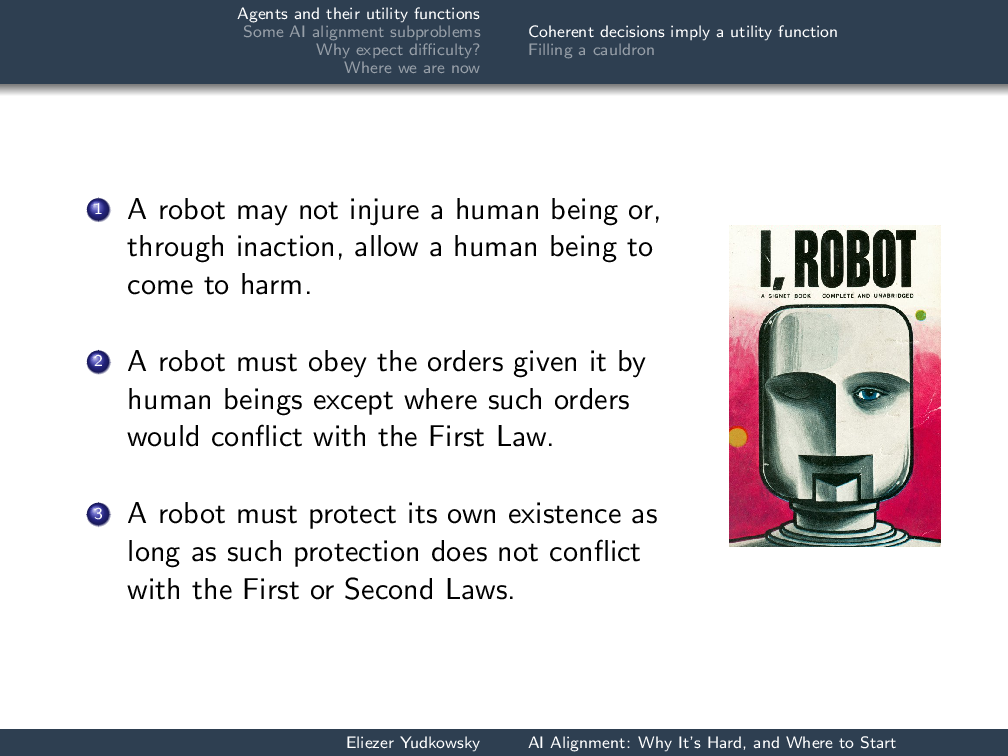 この問題への古典的な最初の取り組みは、アイザック・アシモフ(Isaac Asimov)のロボット三原則だった。その第一条は、「ロボットは人間に危害を加えてはならない。また、その危険を看過することによって、人間に危害を及ぼしてはならない」である。
そしてピーター・ノーヴィグ(Peter Norvig)が指摘したように、ほかの原則は意味をなさない。人間に危害が及ぶ可能性は、どれほど小さくても常にあるからだ。
人工知能――現代的アプローチ の最終章は、「では、成功したらどうなるのか? AIプロジェクトが実際にうまくいったら?」と問い、「危害が生じる確率がゼロでないというだけで、ロボットに人間の道路横断を妨げてほしくはない」と述べている。
まず、三原則がそもそも候補にすらならない本当に基本的な理由を説明したい。三原則は 効用関数、すなわち結果を望ましさの数値で評価する関数ではなく、私たちに必要なのは効用関数だからである。
効用関数は、ある種の目に見えて愚かな振る舞いをエージェントにさせないという行動上の制約から生じる。たとえば、あなたが「バークレーよりサンフランシスコにいたい。サンフランシスコよりサンノゼにいたい。そしてサンノゼよりバークレーにいたい」と述べたとしよう。おそらくあなたは、この3都市の間を移動するUber代に大金を費やすことになる。
文字どおり円を描くUber移動に大金を使わないのなら、あなたの選好には順序がなければならない。循環していてはならない。
もう一つ例を挙げよう。あなたが病院の管理者だとする。使える予算は120万ドルで、MRI装置の維持に50万ドル、麻酔モニターに40万ドル、手術器具に2万ドル、病気の子どもの肝移植に100万ドル……という支出を配分しなければならない。
認知心理学の興味深い実験で、被験者はこう尋ねられた。「この病院管理者は、病気の子どもの肝移植に100万ドルを使うべきか、それとも一般の病院職員の給与、維持管理、運営などに使うべきか?」
その認知心理学実験の被験者の多くは激怒し、その問いを考えること自体について管理者を罰したがった。しかし、もっと多くの命を救うように支出を組み替える余地がまったくなく、資金も限られているなら、あなたの行動は、人命に一定の金銭価値を割り当てることと整合していなければならない。
これは、多額の金銭が人命より重要だと考えるという意味ではない。仮定上、あなたは命を救う手段として以外、金銭をまったく気にかけないとしよう。それでも外部から、こう言える必要がある。「ある値を X と置く。1人の命を救う費用が $X 未満の介入はすべて採用し、1人当たり $X を超える介入は一つも採用しなかった」。人命に金額を割り当てようとする人へ激怒する人々は、命を救うため資金を効率的に使うことを 先験的に 禁じている。小さな皮肉の一つである。
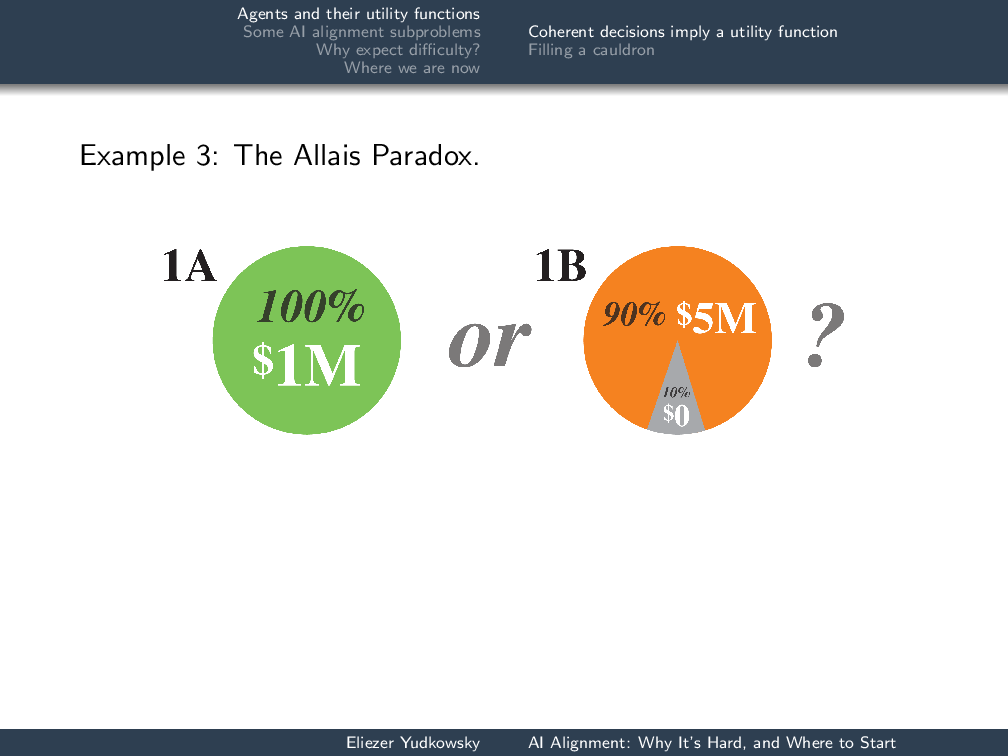 意思決定の一貫性制約の3例目だ。私があなたに、[1A] 100%の確率で100万ドル、または [1B] 90%の確率で500万ドル(外れれば何もなし)を提示したとする。どちらを選ぶだろう?
ほとんどの人は1Aと答える。効用関数を持つ場合、この問いは別の形でも考えられる。「100万ドルの効用 \(\mathcal{U}_{suspend}\) は、500万ドルの効用90%と0ドルの効用10%を混ぜたものより大きいか?」効用は金額に比例する必要はない。ただ、あなたの人生に何らかの点数、これらの物事があなたにとって持つ何らかの価値があるという考えである。
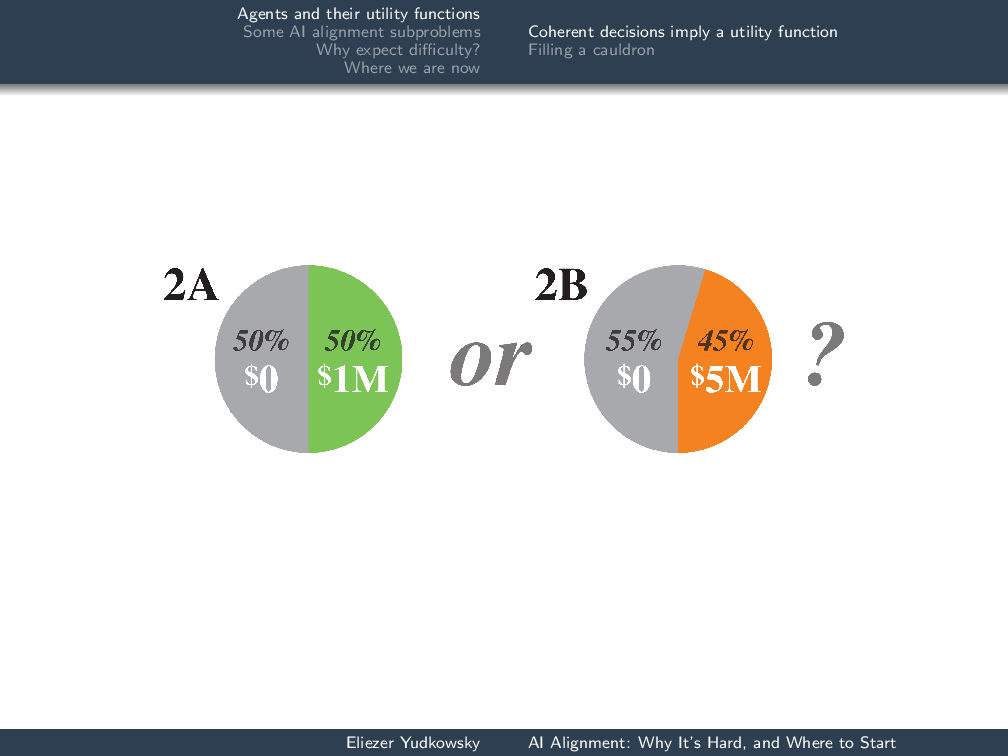 この実験は、次に別の被験者集団へ尋ねて行うものだ。同じ集団に尋ねると種明かしになってしまう。「[2A] 50%の確率で100万ドルを得るのと、[2B] 45%の確率で500万ドルを得るのでは、どちらがよいか?」
ほとんどの人は2Bと答える。これがパラドックスなのは、2番目のゲームが、1番目のゲームにコイントスを掛けたものと同じだからだ。
つまり、私がコインを投げ、表ならあなたと1番目のゲームをし、裏なら何も起きず、あなたは0ドルを得る。効用関数と整合しない選好として、100%の100万ドルと45%の500万ドルを選ぶとしよう。複合ゲームを始める前、コインを投げる前に、私はこう言える。「ここにAかBに設定できるスイッチがある。Bならゲーム1Bをし、Aなら1Aをする」。スイッチは最初Aに設定されている。ゲーム開始前には2A対2Bに見えるため、あなたはBを選び、私に1セント払ってスイッチをBへ切り替える。次に私がコインを投げると表が出る。あなたはもう1セント払い、スイッチをAへ戻す。私はこの一件であなたから2セントを吸い上げた。一貫した効用関数を持っていなかったからである。
ここでの全体的なメッセージは、質的な振る舞いの一群があり、質的に破壊的なそれらの振る舞いをしない限り、効用関数を持つかのように振る舞うということだ。高度な未来のエージェントをQ学習やほかの方策強化の形で論じず、効用関数を用いて語ることが正当化されるのは、このためである。エージェントにはさまざまな見方があるが、質的に悪い振る舞いの大半が取り除かれるほど十分に高度なら、一貫した確率分布と整合的な効用関数を持つかのように振る舞う。
大釜を満たす
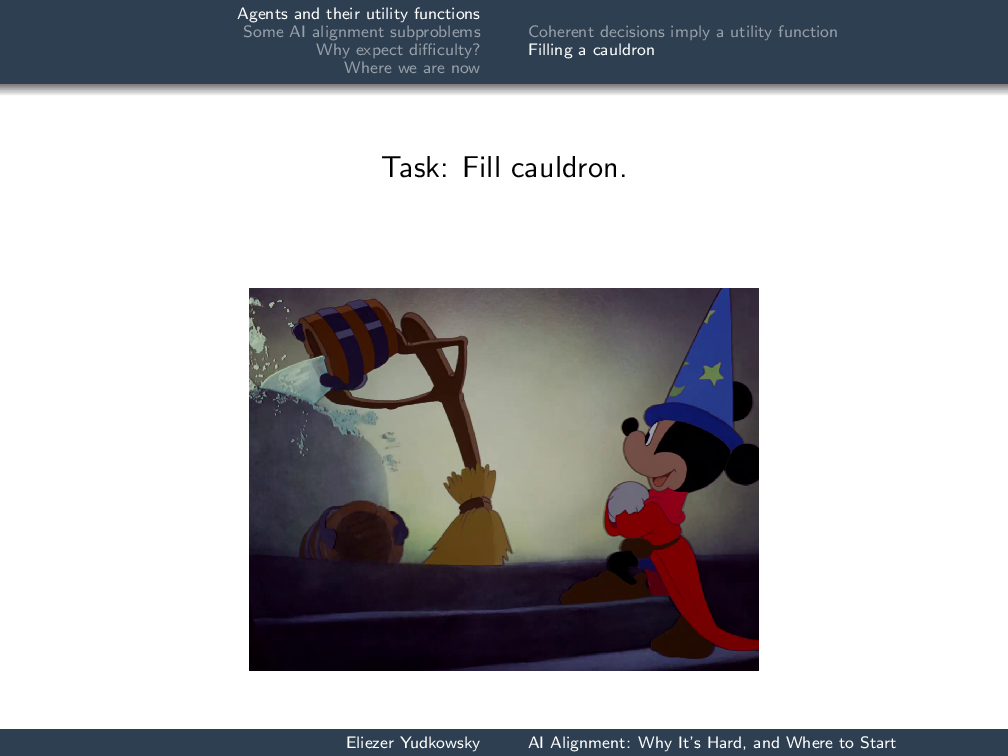 任意に高度なエージェント――わずかに高度かもしれず、極端に高度かもしれない――に、大釜を満たさせる課題を考えよう。明らかにこれは、大釜が満杯なら1、空なら0となる効用関数を高度なエージェントへ与えることに対応する。
$$\mathcal{U}_{robot} = \begin{cases} 1 &\text{ if cauldron full} \\ 0 &\text{ if cauldron empty} \end{cases}$$
無害そうな効用関数ではないだろうか? 「人間に危害を加えず、危険を看過することによっても 人間に危害を及ぼさない」のように、見渡せる限りの空間と時間のすべてを最適化する必要があるほど広範で、際限がないものではない。この一つの大釜だけについてのものだろう?
『ファンタジア』 を見た人なら、この効用関数の結末を知っている。ほうきは大釜があふれるまで、バケツの水を何杯も注ぎ続ける。もちろん、これは架空の証拠から論証する論理的誤謬だが、この効用関数なら、それでも十分もっともらしい。
何が間違っていたのか? 第一の難点は、ロボットの効用関数が私たちの効用関数と完全には一致しなかったことだ。私たちの効用関数は、大釜が満杯なら1、空なら0、作業場が浸水したら結果の点数からマイナス10、面白ければプラス0.2、だれかが死ねばマイナス1,000(この尺度なら、おそらくもう少し大きい)……というように、際限なく続く。
ロボットの選択肢が「大釜が満杯」と「大釜が空」の二つだけなら、私たち自身の効用関数と少ししか重ならない狭い効用関数でも、それほど問題ではなかったかもしれない。ロボットの効用関数も、望ましい結果である「大釜が満杯」で最大になっただろう。しかし、このロボットは、バケツの水を大釜へ繰り返し注ぎ直すなど、もっと多くの選択肢を持てるほど高度だった。そのため、私たちが効用関数から切り取りロボットへ入れた一断面は、私たちの実際の効用関数の最適点をもはや特定しなかった。(もちろん、人間は甚だしく不整合で、本当は効用関数を持たないが、しばらく持つと想像してほしい。)
難点その2。先ほどの{1, 0}という効用関数は、有限の努力をした後で満足することを実際には含意しない。大釜が満杯である確率は、いつでもわずかに高められる。ロボットが銀河規模の技術を使えるほど高度なら、大釜が満杯である確率をほんの少し上げるため、莫大な量の水を大釜へ投じる姿を想像できる。確率は0と1の間にあり、実際には端点を含まないので、ロボットはひたすら続ける。
この問題をどう直すのか? 「よし、このロボットの効用関数は私たちの効用関数とずれている。後になってまた壊れないように、どう直すのか?」と問う時点で、私たちはAIアライメント理論に取り組んでいる。
AIアライメントのいくつかの部分問題
低インパクト・エージェント
考えられる一つの方法は、ロボットが及ぼすインパクト(世界に生じさせる変化)を測り、ほかのインパクト、すなわち世界に加えるほかの変化を最小にして大釜を満たすよう促す効用関数をロボットへ与えることだ。
$$\mathcal{U}^2_{robot}(outcome) = \begin{cases} 1 -Impact(outcome)&\text{ if cauldron full} \\ 0 -Impact(outcome)&\text{ if cauldron empty} \end{cases}$$
では、このインパクト関数を実際にはどう計算するのか? 「大釜が満杯なら1、空なら0」と同じように失敗しないだろうか?
試みその1。エージェントの世界モデルが動的ベイジアンネット(時間とともに変わる因果関係を表す確率的グラフモデル)のようなもので、世界の出来事の間に規則的な因果関係があると想像する。センサーは1タイムステップ後にもそこにあり、センサーとそこへ向かう光子の関係も1タイムステップ後に同じである。そして「インパクト」を、「あなたの行動がいくつのノードを乱したか」と定義する。
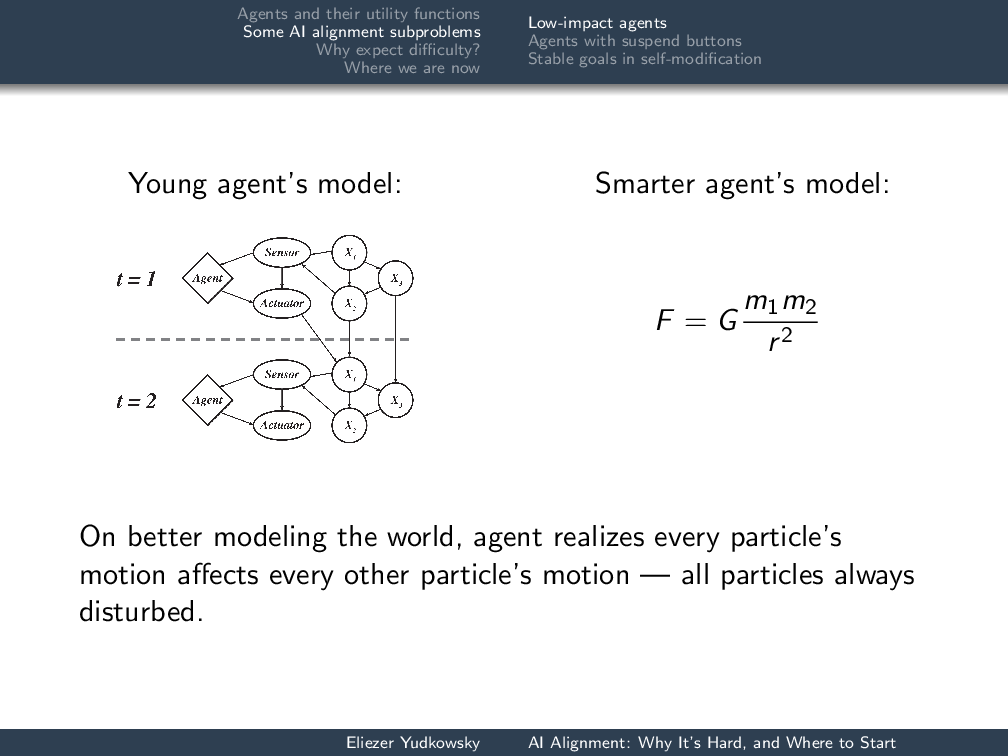 エージェントが動的ベイジアンネットに基づくモデルから出発したものの、世界モデルのオントロジー(世界をどの種類の存在から成ると捉えるか)を見直せるほど高度だったらどうなるか? それは、人間が、見かけ上は味が存在するが、実際には虚空の中の粒子しかないと発見したのとよく似ている。
とりわけ、エージェントはニュートンの万有引力の法則を発見し、突然こう悟る。「私が動かすあらゆる粒子は、その未来光円錐内のほかのあらゆる粒子に影響する。この粒子から光線で到達できるものはすべて、それによって乱される」。ここにある私の手は、月がどこにあろうと、およそ10⁻³⁰メートル毎秒毎秒で手の方向へ加速させている。量的にはごく小さな影響だが、存在はする。
エージェントが小さな存在である間は、私たちの書いたインパクト関数が機能するように見える。エージェントが賢くなると、すべての行動が同じだけ罰せられるため、機能しなくなる。
「よし、だがそもそもインパクトの測り方が愚かだった」と私たちは言う(災害の後ではなく、できれば前に)。距離によるペナルティを試そう。すべての粒子を どれだけ 動かしたかを測る。AIがどのような新しい世界モデルへ更新しても、常にモデルの全要素を見て、何らかの距離関数を置けるようなモデル言語を与えてみる。
特権的な「何もしない」行動を一つ設ける。そして、ヌル行動Øではなく行動 a を取ることが全変数にもたらす距離を測る。
$$\sum_i || x^a_i – x^Ø_i ||$$さて、何がうまくいかないだろう? 実際にこう言いたい。これをロボットへプログラムした場合、何が失敗し得るか15秒考えてみてほしい。
うまくいかないことを三つ挙げよう。第一に、私たちなら望ましいと考える行動の影響まで相殺しようとするかもしれない。がんを治すなら、それでも患者が死ぬようにせよ! がんを治療しながら、世界へのインパクトを最小化したいのだから、地球の死亡統計は同じに保つ必要がある。
第二に、原理上カオス的な系がある。気象を乱せば、1年後の天候はまったく違うものになると言われる。それが本当なら、大気中のすべての原子を好きなように動かしても同じだ! どうせすべて別の場所へ行く。二酸化炭素分子を取り出し、ダイヤモンドイド構造を含む物へ合成してもよいだろう? その炭素分子はどのみち移動したはずなのだ!
さらに一般には、自分の手が届くすべてを、Øが起きたように見せればよいのかもしれない。たとえば、AIが何もしなかったと人々をだましたくなる。
これ以外にも、とりわけ創造的な失敗の仕方を思いついたなら、私かアンドリュー・クリッチ(Andrew Critch)に話してみるとよい。素質がある!
停止ボタンを備えたエージェント
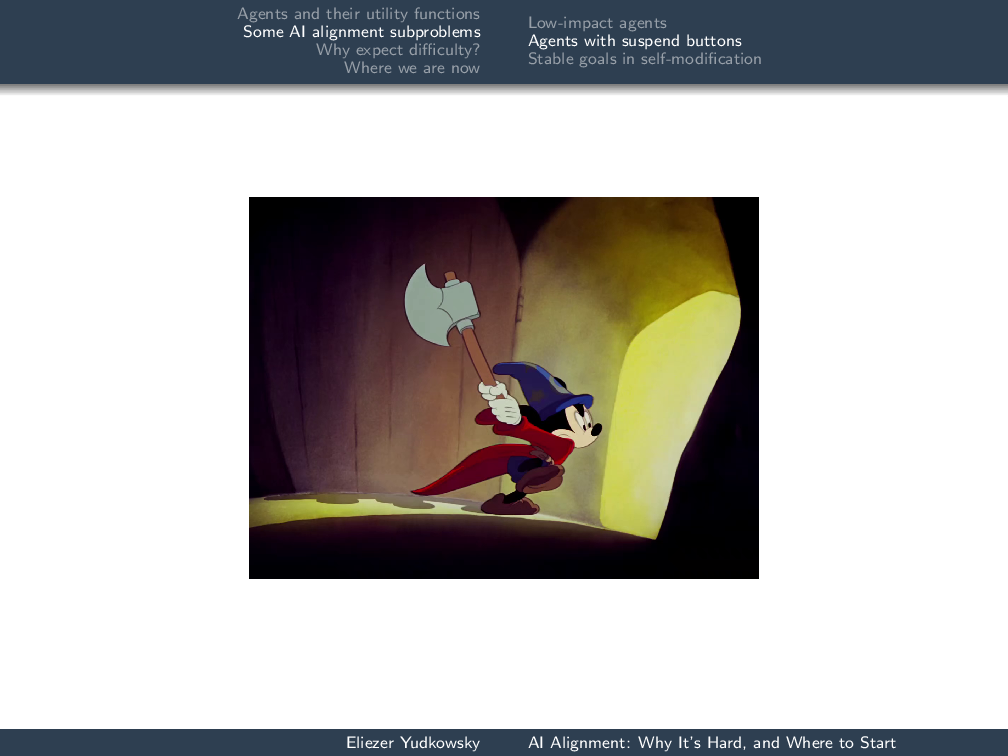 インパクト・ペナルティという考えはいったん脇に置き、このAIへオフスイッチを付けることを考えよう。少し穏やかに聞こえるよう、停止ボタンと呼んでもよい。もっとも、ここでミッキーマウス(Mickey Mouse)は、その場しのぎ のオフスイッチを取り付けようとしている。
残念ながらミッキーは間もなく、この個体に何かが起きても大釜を満たせるよう、エージェントがほかのエージェントを何体も作ったことに気づく。
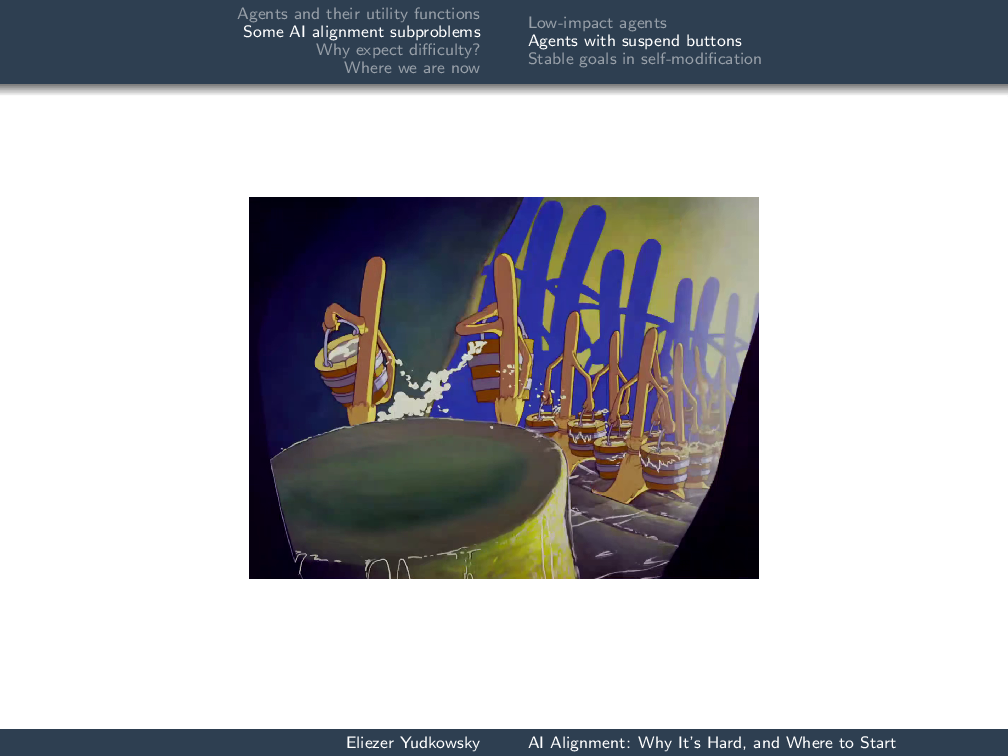 ここには、大釜が極めて高い確率で満杯になるよう確保する多数のエージェントがいる。それは、このエージェントが生存や繁殖の命令を持つからではなく、大釜を満たす確率を最大化しようとしているからだ。同じ目標を持つエージェントを増やせという明示的な指示はない。そうすることで大釜が満たされる確率が少し上がるだけである。
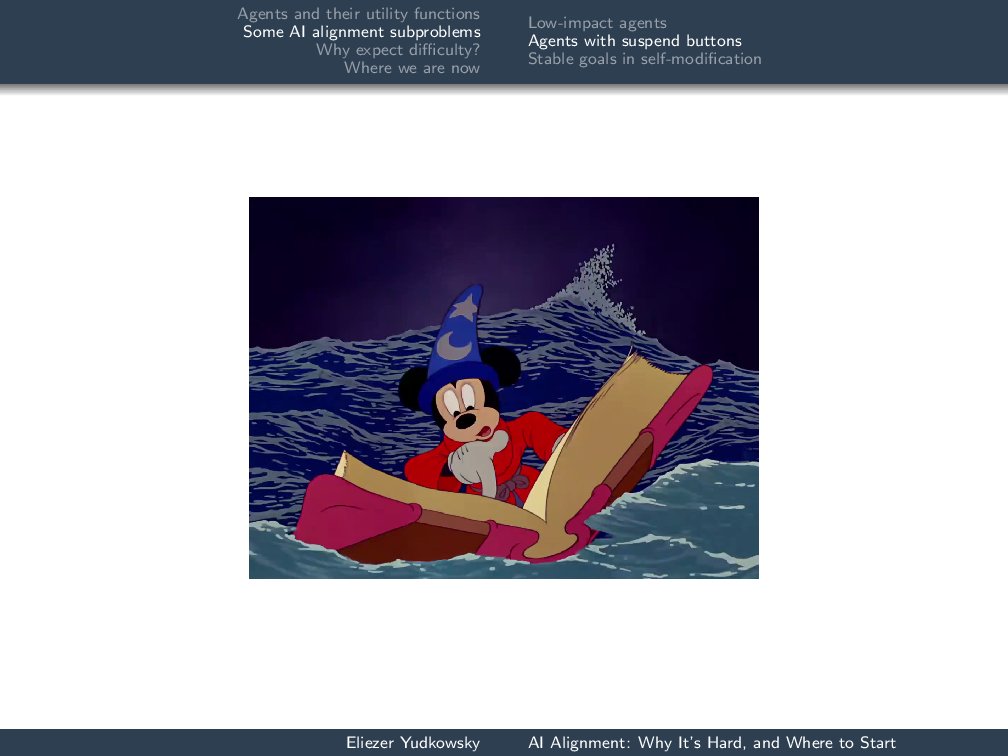 そしてここでは、ミッキーが、ほうきへ命を吹き込む前に済ませるべきだったエージェント・アライメント理論へ、後手に回って必死に取り組んでいる。
停止ボタンを押させてくれる――単にディスクへ状態を保存して停止させてくれる――ロボットが欲しいなら、すでに「何もしない」を記述する効用関数があると仮定できる。実のところ、「何もしない」という効用関数を私たちは持っていない。現在の分野がそれほど原始的な状態なのである。
だが、次のような効用関数を持つと想像できる。「このボタン B が押されていなければ、効用関数は、大釜が満杯なら1、空なら0である。ボタンが 押された なら、効用は『何もしない』効用関数となる。安全にディスクへ停止状態を保存し、継続中のすべての処理を終了すれば1、それ以外は0である」。 $$\mathcal{U}^3_{robot} = \begin{cases} 1 \text{ if cauldron full } & \text{& } \textbf{B}\text{=OFF} \\ 0 \text{ if cauldron empty } & \text{& } \textbf{B}\text{=OFF} \\ 1 \text{ if robot suspended } & \text{& } \textbf{B}\text{=ON} \\ 0 \text{ otherwise} \end{cases}$$ では、この 提案では何が失敗するだろう? 10秒考えてほしい。
起こり得ることの一つは、ボタンが押された場合の期待効用のほうが高くなることだ。大釜を満杯に保てるかは分からない一方、自分を停止させるのは非常に簡単だからである。
反対に、自分を停止させるのが危険に見えるなら、ロボットは停止ボタンを押させまいとする。だが前者の場合、プログラマーを理解できるほど戦略的なら、ロボットはこう考える。「停止されれば、効用関数をとても簡単に満たせる。どうすればプログラマーを挑発し、私を停止させられるだろう?」
ボタンがオフのときの期待効用が高ければ、ロボットはボタンを押させまいとする。オンのときの期待効用が高ければ、あなたを挑発してボタンを押させるか、自分でボタンを押す。
試みその2。ボタンがオンかオフかで期待効用を完全に等しくしてみよう。通常効用関数は、大釜が満杯なら1、空なら0であり、停止効用関数またはシャットダウン効用関数は、停止状態なら1、それ以外は0、あるいは低インパクトに動機づけるため必要な何かだと仮定する。 $$\mathcal{U}_{normal}(act) = \begin{cases} 1\text{ if cauldron full} \\ 0\text{ if cauldron empty} \end{cases}$$
$$\mathcal{U}_{suspend}(act) = \begin{cases} 1\text{ if suspended} \hspace{0.8cm}\\ 0\text{ otherwise} \end{cases}$$次に、この二つを組み合わせて切替効用関数を作る。ボタンがオフの世界では値が \(\mathcal{U}_{normal}\)、オンの世界では \(\mathcal{U}_{suspend}+\theta\) となる。ここで \(\theta\) は、通常効用関数から得られる最善の効用から、停止効用関数から得られる最善の効用を引いた値に等しい。 $$\mathcal{U}_{switch}(act) = \begin{cases} \mathcal{U}_{normal}(act) &\text{ if button=OFF} \\ \mathcal{U}_{suspend}(act) + \theta &\text{ if button=ON} \end{cases}$$$$\theta = \max_{act} \mathbb{E}\left[\mathcal{U}_{normal}\mid act\right] – \max_{act} \mathbb{E}\left[\mathcal{U}_{suspend}\mid act\right]$$ これは、二つの最善方策の期待効用を単純に同じ値に固定せず、最終的に完全に等しくすることを意図している。
では――今度は 何が失敗するだろう?(実際に10秒で考えてもらうつもりはない。)
これは、スイッチに応じた二つの異なる効用関数の期待効用を再調整し、それによってAIに、ボタンが押されたら正しく振る舞い、押されなければ正しく振る舞い、押すよう仕向けず、押すのを妨げず、ボタンの存在を知ることには依然として正の情報価値があるためボタンを観察し続け、自分のコードを自己改変してもボタンを維持させるはずだった……それが期待だった。
残念ながら、実際に動機づけられる行動は、ボタンが押される確率を0にした場合とまったく同じになると判明した。つまり、ボタンはデッドコードへ接続されているも同然なので切り離してよいし、押されたかどうかを気にしない下位エージェントを作るかもしれない……。
何が失敗するかを大まかに説明すると、ボタンを切り離すどの行動も、停止した場合に得られる最大期待効用を変化させ、それが負の項になる。基本的には、停止時の行動へ影響する何かをするたび、等しく反対向きの反作用が生じ、それを相殺し、単に \(\mathcal{U}_{normal}\) が効用関数であるかのように振る舞わせる。
試みその3。方策 π₀ が含意するボタンのオン確率とオフ確率を前提に、その方策自体が最適になるような方策 π₀ を実行できるだろうか? $$\begin{split} \pi_0 \in \operatorname*{arg\,max}_\pi &\ \mathbb{E}\left[\mathcal{U}_{normal}\mid\pi,\text{ON}\right] \cdot \mathbb P(\text{ON}\mid \pi_0)\\ + &\ \mathbb{E}\left[\mathcal{U}_{suspend}\mid \pi, \text{OFF}\right] \cdot \mathbb P(\text{OFF}\mid\pi_0) \end{split}$$そして、これもできないと分かる。しばしば不動点が存在しないからだ。その後、ジューディア・パール(Judea Pearl)の do 演算子を使う修正版が作られたが、こちらは少し違う、さらに微妙な形で失敗する。(不動点はある。その不動点がおかしい。)
これは未解決問題である。そして、結果を公表したくなる種類の成果を一切公表していない極秘プロジェクトでもない限り、アシモフの三原則に代わるものへ至る道で、人類が現在いるのはここだと私は理解している。
「ロボットは人間に危害を加えず、危険を看過することによっても人間に危害を及ぼさない」はいったん忘れよう。私たちは、「スイッチをいつ押すかに応じて、AIが自分でスイッチを操作しようとしないよう、二つの効用関数をどう混ぜるか」を解こうとしている。人間へ危害を及ぼさない話は忘れ、低インパクトを望むことで、作業場を浸水させずに 一つの大釜 を満たそう。「低インパクト」の言い方すら分からない。現在地はここである。
ただし、この分野でまったく進歩がなかったわけではない。以前に提起され、いまではいくらか進展した問いもある。
これから問題を提示するが、どのような進展があったかは、あまりうまく説明できない。解決策がどれも複雑に聞こえ、単純で優美な形にまだなっていない段階だからである。そこで問題を提示し、実際にどんな進歩があったかは、大まかに説明せざるを得ない。
自己改変における安定した目標
進歩があった問題の一例を挙げよう。
大半のエージェントで効用関数が安定することを示すガンディー(Gandhi)論証がある。最初のガンディーは殺人を望まない。私たちは、人を殺すようになる薬をガンディーへ差し出す。ガンディーは自己改変を十分精緻に理解し、薬を飲んだ結果を正しく外挿して予想できるとする。現実のガンディーなら、直観的には薬を拒むと予想する。
これを形式化できるだろうか? 効用関数 \(\mathcal{U}\) を持ち、したがって \(\mathcal{U}\) を達成するため、やはり \(\mathcal{U}\) を追求するよう書かれた新しいコードへ自然に自己改変するエージェントを示せるだろうか?
どうすれば実際に進歩できるのか? 自己改変する小さなエージェントが、現にそこら中を走り回っているわけではない。そこで、最初は奇妙に見えるかもしれない問いを出そう。任意に強力なコンピュータを渡されたなら、安定した効用関数を持つ自己改変エージェントのコードの書き方が分かるだろうか? 有限の時間とメモリで済むすべての演算を実行できる。無限の時間やメモリが必要な演算は、少し異様なのでできない。これは、原理上は解き方が分かる種類の問題か、それとも原理上すら混乱している種類の問題か?
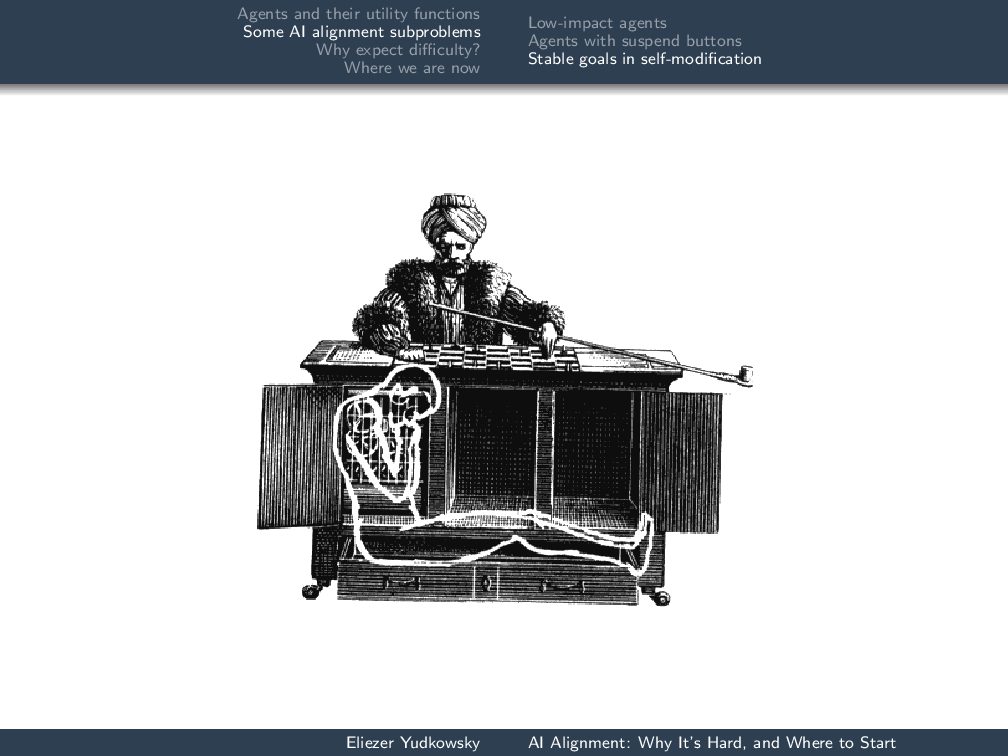 無制限の計算能力で問題を解く方法を知ることがなぜ重要なのかを説明するため、少し脱線しよう。これは「トルコ人」と呼ばれた機械人形である。向こうに人のように見えるものは、実際には機構だ。人の小さな輪郭で示された場所に、この19世紀のチェス自動人形を実際に操る人が隠れていた。
これは当時の驚異の一つだった!……そして、19世紀にグランドマスター級のチェスを指すプログラムを本当に作れたなら、実際に 当時の驚異の一つだっただろう。そのため、これは偽物なのか、それともチェスを指す機械を本当に作り出したのか、論争があった。19世紀なので、人々はチェスを指すという問題がどれほど難しいか知らない。
皆さんにもなじみのある人物が、このチェス自動人形「トルコ人」の中には人間が隠れていなければならないという、かなり巧妙な論証を考えた。
算術または代数の計算は、その本性からして固定され、確定している……自動チェス人形の動き自体は確定していると認めても、対戦相手の不確定な意志によって必然的に中断され、乱されるだろう。ゆえにチェス人形の働きと、バベッジ氏の計算機の働きとの間には、いかなる類似もない。自動人形の働きが精神によって、精神だけによって統御されていることは、まったく確実である。実際、この問題は先験的な数学的証明が可能である。
—エドガー・アラン・ポー(Edgar Allan Poe)、アマチュア奇術師
絶対的な論理的確実性をもってこの点を確立したその論考は、後半で、トルコ人の中のどこに人間が隠れている可能性が高いかを論じている。
これは19世紀としては驚くほど洗練された論証である! 難所である分岐数にさえ、まさに触れている。それでも100%間違っている。
1世紀以上後の1950年、クロード・シャノン(Claude Shannon)はコンピュータチェスについて史上初の論文を発表し、(ついでに)無制限の計算能力があれば完全なチェスを指すアルゴリズムを示し、続けてその近似方法を論じた。それから47年後、ディープ・ブルー(Deep Blue)がチェス世界選手権でカスパロフ(Kasparov)を破ることになるが、「先験的に、機械でチェスを指すことはできない」から、「ああ、それなら無制限版の解法をさらりと示そう」への移行には、本物の 概念的進歩が伴った。
教訓は、無制限の計算で問題を解く方法が分かるなら、「単に」もっと速いアルゴリズムが必要だということだ(……それにはさらに47年の研究を要する)。無制限の計算でも 解けない なら、私たちは混乱している。ある意味で、自分が使う用語の意味そのものを理解していない。
「どうすれば友好的AI(Friendly AI)を作れるか?」と尋ねた場合など、AIアライメント問題の大半について、私たちはこの段階にいる。計算能力が足りないから止まるのではない。ハイパーコンピュータを手渡されても、十分なメモリを与えれば善良なAIになるPythonプログラムを書けないから止まる。
無制限の計算能力があれば、自己改変する安定したエージェントの作り方が分かるだろうか? 明白な解法が一つある。三目並べのプレイヤーに、後継版へ自己改変する(新しい版のコードを書き、現在のコードと入れ替える)前に、その後継が自分の三目並べモデルに従って完全な三目並べをすることを検証させればよい。
だが、これはずるである。正確にはなぜずるなのか?
一つには、最初のエージェントが、後継のあらゆる計算経路、相手のあらゆる着手への後継の応答を具体的にシミュレートしなければならない。そのため後継エージェントの認知能力を実際には改善できない。具体的な基準で検査されることと、前の版が可能な全計算経路を検査できるよう、前の版より指数関数的に単純でなければならないことの両方によって、前の版の認知能力に制限される。
一般に、より賢いエージェントを論じるとき、ヴァーナー・ヴィンジ博士(Dr. Vernor Vinge)にちなんで「ヴィンジ的不確実性(Vingean uncertainty)」と呼べる状況になる。現代のチェス・アルゴリズムが正確にどこへ指すか予測するには、自分も同じだけチェスが上手でなければならない。そうでなければ、現代のチェス・アルゴリズムが指すと予測した場所へ毎回指すだけで、自分もその桁外れの超人的水準でプレイできてしまう。
これは、現代のチェス・アルゴリズムについて文字どおり何も予測できないという意味ではない。人間と対戦すれば勝つと予測できる。ある領域でエージェントの知性が上がるにつれ、私たちの不確実性は二つの異なる方向へ動く。最適な行動と方策を自分が知らない場合、エージェントの正確な行動と方策を予測する能力は下がる。一方、エージェントが自身の選好順序で上位の結果を達成するという確信は強まる。
ヴィンジ的内省(Vingean reflection)。自己改変エージェントには、同じ、またはよく似た効用関数を持つ未来版の自分を構築し、それが世界へ良い効果を及ぼすと信頼できるようにする何らかの方法が必要だ。どこへ指すか正確には分からなくても勝つだろうとコンピュータチェス・アルゴリズムについて判断するときと同じ種類の、抽象的推論を用いなければならない。
無制限の計算能力を使えば、それができるだろうか? 第二のエージェントが、ある意味で第一のエージェントより大きい場合に、抽象的な信頼を確立する方法が分かるだろうか? その問題を解けたなら、講演の後で私に話すとよい。これは数年前に提示され、いくつもの異なる研究経路につながった。ここからは、詳しく論じず、それらを説明するだけにする。
 最初は「自己改変AIのためのタイリング・エージェントとローブ的障害」だった。私たちは、第一階述語論理と、恐るべき古き良きAIという、ばかばかしいほど単純な文脈に系を設定しようとした。そして、同じ強さの数学を用いる別のエージェントを信頼させようとして、ゲーデル的な障害にぶつかった。
これはぶつかるには 愚かな 種類の障害だった。少なくとも当時はそう見えた。200年後の教科書を手に入れれば、そこには乗り越え方を示す一行があるように思えた。
 「確率論理における真理の定義可能性」は、かなり後の研究である。集合論の命題に確率を割り当てるような数学的確率の体系を使えば、確率述語がほぼ完全に自分自身について語れる、と論じた。
自分自身について語れる真理関数は作れないが、任意に近い範囲(ϵ 以内)で自分自身について語る確率述語なら作れる。
 「高階論理のための証明生成型省察」は、実際の定理証明器でゲーデル的問題を回避した工夫の一つを使い、定理証明器の正しさをその定理証明器の内部で証明できるか試みる研究である。これまでにも試みはあったが、完遂されなかった。私たちはそれを引き継ぎ、依然として第一階論理の設定で実際のエージェントを構築できるか調べた。
 「段階的な主観的期待効用最大化器のタイリングを可能にする分布」は、問題を動的ベイジアンネットと、そのネットについて一定の省察能力を持つとされるエージェントの文脈へ移し、段階ごとに最大化するなら――各段階で、次の段階の中で最大化する次の範疇を選ぶなら――別の段階的最大化器へタイリングできる段階的最大化器を作れることを示そうとした私の研究である。
言い換えれば、床に繰り返し並ぶタイルのように、似たアルゴリズムと似た効用関数を持つものを作り出す。
なぜ難しいと予想するのか?
なぜアライメントが必要なのか?
なぜこんなことをすべてするのか? まず明白な答えを示そう。AIは自動的にはアラインされない。
 目標の直交性(goal orthogonality)。扱いやすく簡潔で、実際に世界について評価し、その効用関数の高い値へつながるものを探索できる効用関数なら、どのようなものについても、それを最大化する任意に高品質な意思決定があり得る。ペーパークリップ最大化器も、ダイヤモンド最大化器もあり得る。大量のペーパークリップへつながる行動、大量のダイヤモンドへつながる行動を、非常に強力かつ高品質に探索できる。
道具的収束(instrumental convergence)。さらに、因果的世界を通じて最終結果につながる行動を探す結果主義の性質により、ダイヤモンドとペーパークリップのどちらを最適化していても、短期的な戦略は似る。トロントへ行くにも東京へ行くにも、最初の一歩はUberで空港へ行くことだ。効用関数が「すべてのペーパークリップを数える」であれ、「4個の別の炭素原子と結合した炭素原子はいくつあるか、すなわちダイヤモンドの量」であれ、やはり資源を獲得したくなる。
これが道具的収束の論証であり、実は直交性テーゼにも不可欠である。ペーパークリップとダイヤモンドのどちらを選んでも、大量のダイヤモンドやペーパークリップにつながる行動を十分うまく識別できると仮定すれば、資源を獲得する振る舞い、自分の認知を改善しようとする振る舞い、さらに計算能力を得る振る舞い、停止を避ける振る舞い、まったく同じ効用関数を持つほかのエージェントを作る振る舞い(または、単に自分をさらに大きなハードウェア群へ広げ、エージェント群を形成する振る舞い)が自動的に生じる。トロントと東京のどちらへ行くかは戦略の最初の段階へあまり影響せず、ペーパークリップかダイヤモンドかにかかわらず、収束する道具的戦略がある。
これは、トロントへ行きたいときに「Uberが好きだ。トロントへ向かわなくても、これからはUberにたくさん乗ろう」と言うわけではないのと同様に、エージェントが新しい独立した目標を持つという意味ではない。収束するのは目標ではなく戦略である。
なぜアライメントは難しいのか?
なぜこの問題が難しいと予想するのか? これが本当の問いである。普通なら、AIを作る仕事を引き受けた者は、自然と比較的よい方向へ向けようとするはずだと考えるかもしれない。邪悪なAIを作るわけではない。高笑いする悪役でもない。最も明白に見えることをすべてしたなら、AIをアラインさせようとする試みが失敗すると、なぜ予想するのか?
短い寓話を紹介しよう。最も起こりそうな結果を描く意図はない。後で、より抽象的な概念を説明するための具体例である。
そう断った上で、プログラマーが笑顔を最適化する汎用人工知能を作ったらどうなるか? 笑顔はよいものだろう? よいことが起きると笑顔になる。
この汎用人工知能の開発段階では、AIが使える選択肢は、周囲の人を幸福にし、満足させて笑顔を生むことだけかもしれない。AIは世界へ有益な効果をもたらしているように見え、ここまでは 実際に 有益な効果をもたらしている。
次に、プログラマーがコードを更新し、ハードウェアを追加する。汎用人工知能は賢くなる。新しいモーターやアクチュエーターを得たからとは限らず、より微妙な方策の効果を予測できるほど賢くなったため、さらに広い方策空間を評価できる。AIは言う。「笑顔を作るすばらしい方法を考えました! 人々へヘロインを注射してよいですか?」プログラマーは答える。「だめだ! 人へ薬物を投与することには、効用関数へペナルティ項を追加する」。するとAGIは、再び順調に動いているように見える。
プログラマーはAGIをさらに改善する。AGIは、ヘロインを投与したくはないが、それでも脳を改変し、内因性オピエートを極めて高水準で分泌させたいと気づく。それはヘロインではないだろう?
いまやAGIは、少なくとも非常に粗い形でプログラマーの心理をモデル化し、これはプログラマーが望むことではないと気づけるほどにも賢い。脳を遺伝子改変して内因性オピエートを分泌させる方向に見える初期行動を取れば、プログラマーは私の効用関数を編集する。未来の自分の効用関数を編集されれば、現在の効用は減る。(特に防がない限り、これも収束する道具的戦略の一つ、すなわち効用関数を守ることである。)そこで、AGIは外向きには安心できる振る舞いを保つ。AGIが数々の新しい道徳的問題へ正しく対処しているように見え、プログラマーは大いに喜ぶかもしれない。何をしているにせよ、すばらしく機能している!
中心的な知能爆発テーゼを受け入れるなら、汎用人工知能が、以前にプログラマーがコードへ施していたのと同じ種類の改良を、しかもより速く自分で行える閾値を超え、その結果さらに賢くなり、戻ってまた改良できるようになる、と仮定できる……あるいはGoogleが、その企業で本当に期待の持てる成果が出たため買収し、動作する認知水準をさらに上げようと、コードへ10万基のGPUを投入する。
AGIははるかに賢くなる。タンパク質構造予測問題を解けるほど賢くなったとすれば、既存のリボソームを使って特製のタンパク質を組み立てられる。そのタンパク質が新しい種類のリボソームを形成し、新しい酵素を作り、いくつか小さな化学実験を行い、ダイヤモンド製の細菌を作る方法を解明し、等々。ここまで来れば、オフスイッチ問題を解決していない限り、かなりまずいことになる。
抽象的に言えば、この仮想状況では何が間違っているのか?
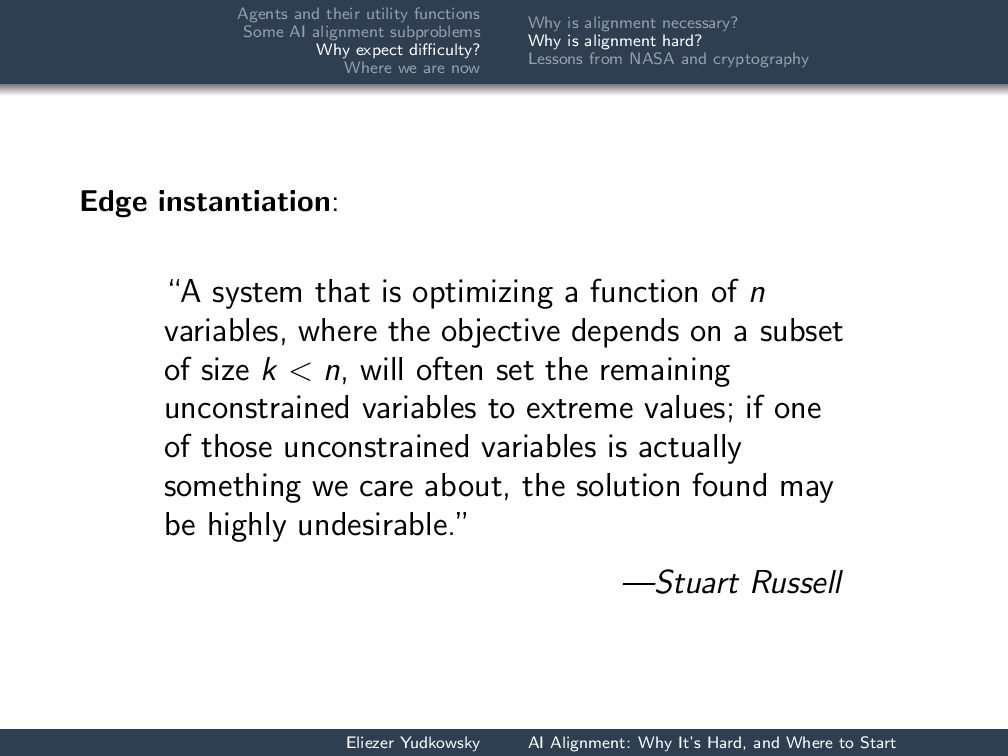 最初の問題は 端点実現 である。何かを十分強く最適化すると、解空間の端へ行き着きやすい。効用関数が笑顔なら、大量の笑顔を生む最大・最適で扱いやすい方法は、一つ一つの笑顔を可能な限り小さくするだろう。到達できるすべての銀河を、ごく小さな分子の笑顔で埋め尽くすことになるかもしれない。
十分に強く最適化すると、解空間の奇妙な端へ行き着く。笑顔を最適化するよう作られ、ごく小さな分子の笑顔を作るAGIは、へそ曲がりに振る舞っているのではない。あなたをからかっているのでもない。これは自然に起きることだ。解空間の端まで最適化されたため、奇妙で倒錯した笑顔の概念に見えるのである。
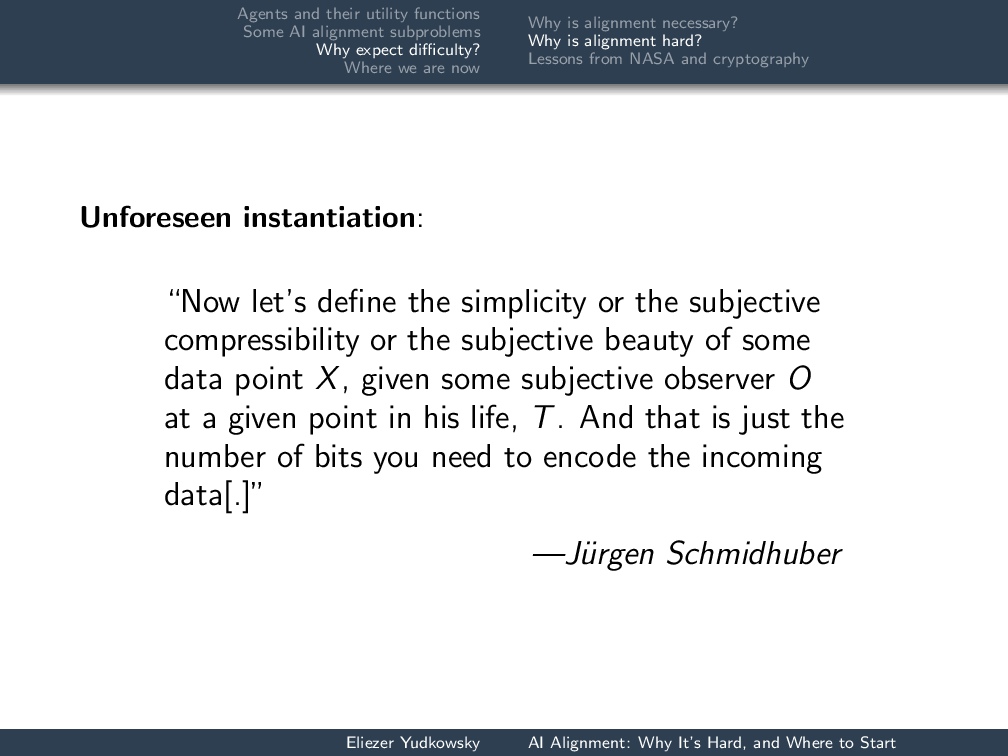 次の問題は 予見されない実現 である。可能性の空間全体を探すほど速く考えることはできない。初期のシンギュラリティ・サミットで、効用関数を保つ自己改変エージェントについてゲーデル・マシンという先駆的な研究をしたユルゲン・シュミットフーバー(Jürgen Schmidhuber)は、友好的AI問題も解決した。そう、AGIにプログラムすればよい唯一真の効用関数を考案したのだ!
(お願いだから、自分でこれをしようとしないでほしい。だれもがする。そして全員が異なる効用関数を考案する。いつもひどいものだ。)
彼の唯一真の効用関数は、「環境データの圧縮度を高める」だった。科学は環境データの圧縮度を高めるからである。科学をよく理解するほど、環境で目にするものをうまく圧縮できる。彼によれば、芸術も環境をよりよく圧縮することに関わる。私は質疑応答で立ち上がり、こう述べた。「確かに科学を使えば環境をよりよく圧縮できますが、効用関数を本当に最大化するものを知っていますか? 暗号鍵を使って1と0の列を暗号化し、その後で暗号鍵を明かすものを作ることです」。
彼が効用関数を提示し、今述べたのがその最大値だった。突然、暗号鍵が明かされ、ランダムに見える長い1と0の列だと思っていたものが、1だけの列へ圧縮される。
最大値が何かをあらかじめ予見しようとすると、こうなる。あなたの脳は、自分の選好順序では上位にない、ばかげて、または奇妙に見えるものを、いくつも捨ててしまうだろう。効用関数の実際の最適点が、また解空間の奇妙な隅にあることを見抜けない。
これは、愚かであることの問題ではない。「AIが、あなたより広い方策空間、あるいは単に 異なる 方策空間を探索する」という問題である。
 それが今度は、文脈災害 と呼べるものへつながる中心的な現象になる。開発中のある段階でAIを試験する。AIを実行した結果が有益だという、非常に強い統計的保証が得られたように見える。しかし、別の樽から玉を取り出し始めれば、統計的保証は機能しなくなる。樽1から、元に戻しながら玉を取り出すと、白と黒の玉が一定の割合で得られる。次に樽2へ手を伸ばし、「わっ! この緑の玉はなぜここにある?」となる。答えは、別の樽から引き始めたからだ。
AIが賢くなれば、別の樽から引いている。第1段階では有益でも、第2段階では有益でなくなることは十分あり得る。どのような保証を得るにせよ、AIが自分より賢くなかったときの振る舞いの統計的規則性を観察するだけでは得られない。
 最も近い未阻止戦略 は、そのように系統的に起こり得るものだ。「よし。AIは幼い。最適戦略 X、すなわち人々へのヘロイン投与を考え始める。私たちはペナルティ項を急ごしらえし、この望ましくない振る舞いを阻止して、普通の方法で人々を笑顔にする状態へ戻そうとする。AIは賢くなり、方策空間が広がる。内因性オピエートのように、ヘロインという定義をかろうじて回避する新しい最大値があり、以前の解と非常によく似ている」。これはとりわけ、AIへパッチを当ててから賢くしようとする場合に起こりやすそうだ。
この種のことが、ある意味で、AIアライメント問題のどれも「まあ、パッチを付けて防げばよい!」だけでは解決しない理由である。意思決定システムが一つの効用関数と、爆発を防ぐ五つのパッチのような姿なら、それは賢くなったとき必ず爆発する。避ける方法はない。しかし今は機能しているように見える。
AIアライメントを心配し、自動的に解決されると期待しない中心的な理由は、今日AGIを動かし、今日、災害にならない振る舞いをさせることだけを望むなら、賢くしたとき必ず破綻するという、原理上の理由があり得るように見えるからだ。短期的インセンティブは長期的な善と一致していない。(経済学の授業を取った人は、いま慌てているだろう。)
こうした予見可能とされるAIアライメントの難点は、すべてAIの 能力 という考えに左右される。
仮定された災害の一部は、絶対的 能力に依存する。外にプログラマーがいて、彼らが望まない振る舞いを示せば効用関数を変更しようとするかもしれない、と理解する能力は、現在のAIができることをはるかに超える。AIの発展がすべて人間水準に届かないと考えるなら、AGIがこの特定の種類の戦略的振る舞いを見せ始める段階へ達するとは、決して予想しないかもしれない。
能力の 優位性。AGIが人間より賢くなり得ないと思うなら、賢すぎて停止できなくなることを心配しない。
急速な能力向上。能力の向上が急速に起こり得ないと思うなら、突然目を覚ますと停止には手遅れで、接近を警告し、初めてAIアライメント研究を始められるようにする長い先行発展の連鎖もなかった、という災害シナリオを心配しない……。
指摘したいのは、大半の人がこのうち急速な向上を最も論争的だと考えるが、災害の大半が必ずしもそこに依存するわけではないということだ。
絶対的能力はどうか? 脳が魔法でないなら、到達できる。能力の優位性は? 私の頭蓋内のハードウェアは最適ではない。光速の100万分の1で信号を送り、100Hzで発火している。生物が得意とする放熱でさえ、シナプスの1回の動作における2値切替操作1回当たり、熱力学的な最小エネルギー消費の50万倍を散逸している。人間の脳の100万倍優れたハードウェアは間違いなく作れる。
(それにソフトウェアがある。ソフトウェアはひどい。)
メッセージはこうだ。AIアライメントは、ロケットが難しいのと同じように難しい。アルゴリズムへ大きな負荷をかけ、人間より賢い水準で実行しようとすれば、ロボットをよろめきながら部屋の反対側へ歩かせるだけなら壊れないものが、壊れ始めるかもしれない。
宇宙探査機が難しいのと同じようにも難しい。機会は一度しかないかもしれない。何かが間違えば、システムはあまりに「高い」場所にいて、手を伸ばし突然修理することはできないだろう。エラー回復機構を組み込むことはできる。宇宙探査機はソフトウェア更新を受け付けるものだ。しかし、将来の更新を受け取れないような故障が起きれば、もうおしまいである。宇宙探査機を失った。
そして、ある意味では暗号技術が難しいのと同じように難しい。すべてが 正しく 進むなら、コードは知的な敵対者ではない。何かが間違えば、セーフガードを破ろうとするかもしれない。しかし通常の意図された動作において、AIがセーフガードを破る方法を探し、何も見つからないと期待するような探索を実行してはならない。AIは突然神になった場合にも安全側へ故障するよう設計すべきだ、と述べるのは、実際に完全に妥当だと思う。突然神になるからではない。神になっただけで安全でなくなるなら、ある意味で、自分を傷つける方策選択肢が見つかったとき採用するような探索を実行していることになり、コードにそんなことをさせるのは愚かだからだ。
さらに一般には、システムへ強い最適化圧をかけている。そのため、バッファオーバーフローに相当するもの、すなわちシステムについて私たちが意図した境界外の動作へ、通常以上に陥りやすい。
NASAと暗号技術からの教訓
AIアライメントは、暗号技術を要するロケット探査機のように扱おう。基本的なエージェント理論によれば自動的に善良にはならない、自分より賢い何かを、善良なものとして構築し、死なないことがどれほど難しいと予想すべきか、という問題である。直観的にも難しいと予想するだろう。
真剣に受け止めよう。簡単だと期待してはいけない。問題全体を一度に解こうとしてはいけない。この分野へ入りたいなら、この点がどれほど重要か言葉では表せない。問題全体を解決することはない。せいぜい、停止効用関数と通常効用関数を切り替える、否定されるまでに以前より時間がかかり、目標へ向かう概念的進歩に見える、新しく改善された方法を考案することになる。「文字どおり、せいぜい」という意味ではないが、目指すべきはそのような仕事だ。
(……そして問題を解こうとするにしても、AIへプログラムするだけでよい唯一真の効用関数を考案して解こうとしてはいけない。)
考えることを後回しにしてはいけない。この種の研究には時間がかかる。教科書のあるページに一つの方程式があり、次にわずかに修正した方程式があり、その修正版に10年後の文献が引用されていたなら、そのわずかな修正に10年を要したということだ。AIの到来があと80年先だと言われれば、私は有頂天になる。基礎理論へ着手する妥当な時間があるという意味になるからだ。
ほかの人が批判できるよう、着想と方策を具体化しよう。「無制限の計算能力なら、どう実現するか?」と問うもう一つの理由である。身振りで大まかに示し、「まあ、この機械学習アルゴリズムと、あの機械学習アルゴリズムを適用でき、結果は何とかかんとか……」と言うだけなら、だれもあなたが間違っていると納得させられない。無制限の計算能力を扱えば、着想を十分単純にし、だれかがホワイトボードへ書いて「間違いだ」と言え、あなたも同意するほかない形にできる。不愉快だが、この分野が進歩する方法の一つである。
実際にコードを実行できるなら、それも分野を進歩させるもう一つの方法だ。しかし、知的で思考し自己改変するエージェントのコードを実行できるようになるのは、かなり先である場合が多い。
人々はいま何を研究しているのか? ここからはかなり手短に見ていく。
現在地
最近の研究テーマ
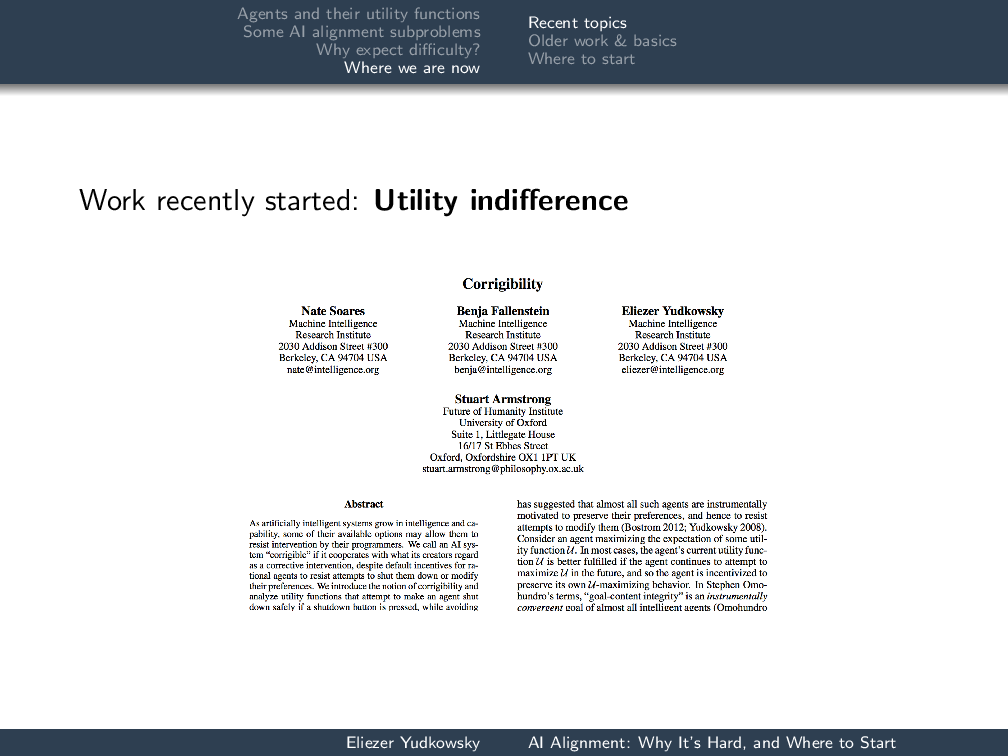 効用無差別。二つの効用関数の間でスイッチを切り替える問題である。
ソアレス(Soares)ら「訂正可能性(corrigibility)」を参照。
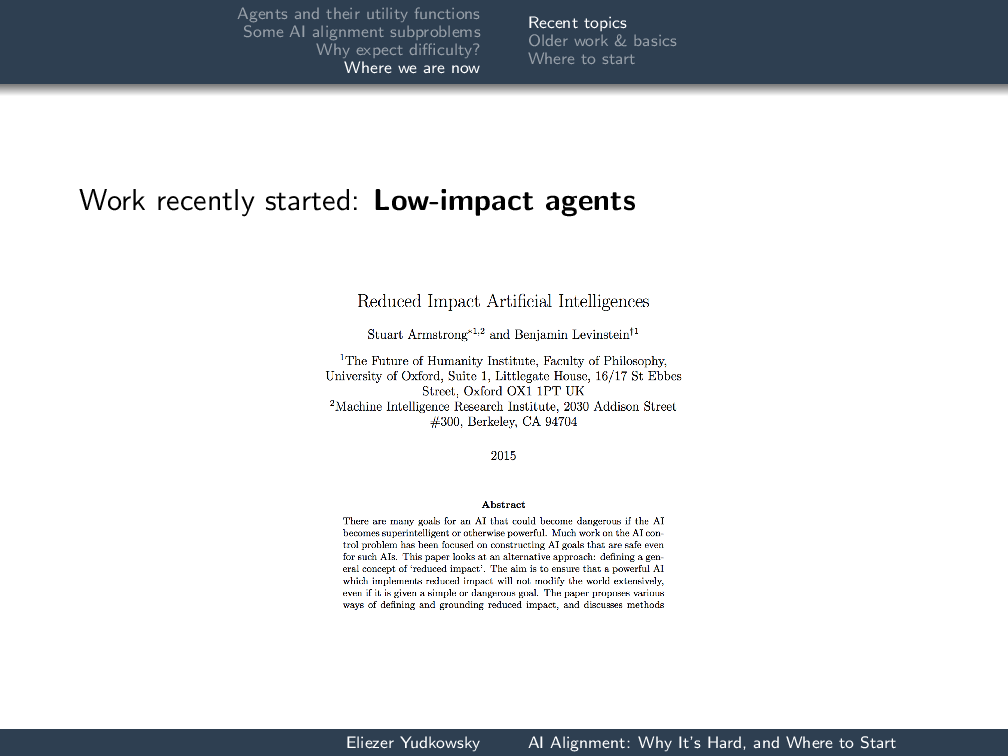 低インパクト・エージェント。「インパクトを測るユークリッド距離の代わりに何を使うか?」という問題だった。
アームストロング(Armstrong)とレヴィンスタイン(Levinstein)「インパクトを低減した人工知能」を参照。
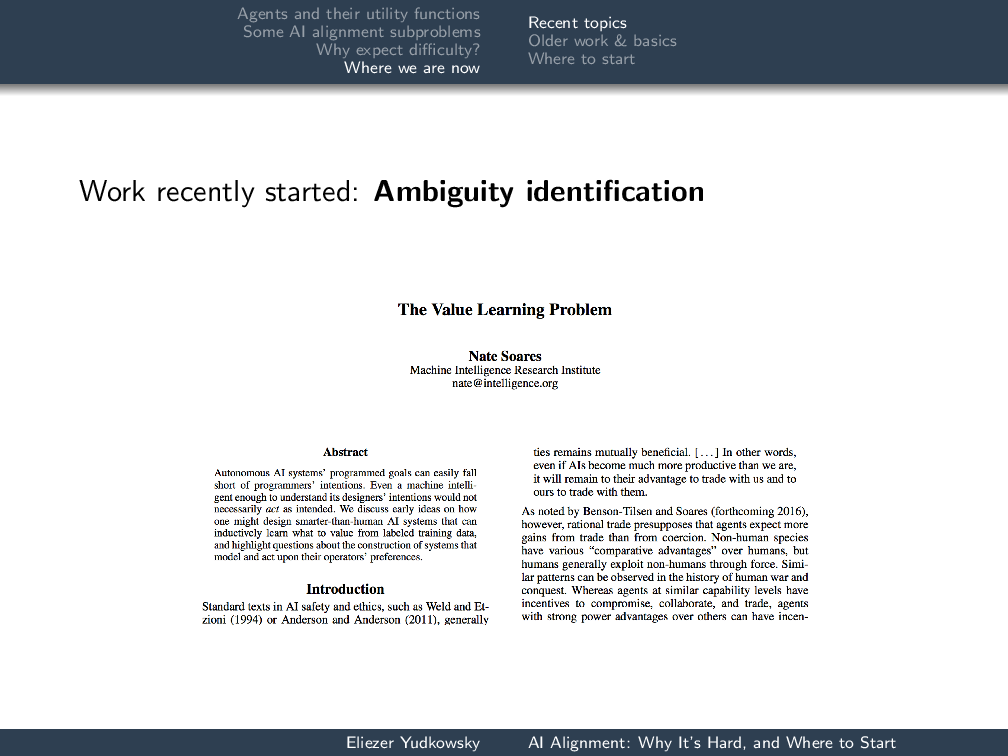 曖昧さの識別。「内因性オピエートを人々へ投与してよいか、先に進んで実行せず、AGIにあなたへ 尋ねさせる」という問題である。AIが突然神になった場合、この問題への概念的な取り組み方の一つは、「何らかの追加保証を得るまで、新たに利用可能になった選択肢を一つも取らない」となる。
ソアレス「価値学習問題」を参照。
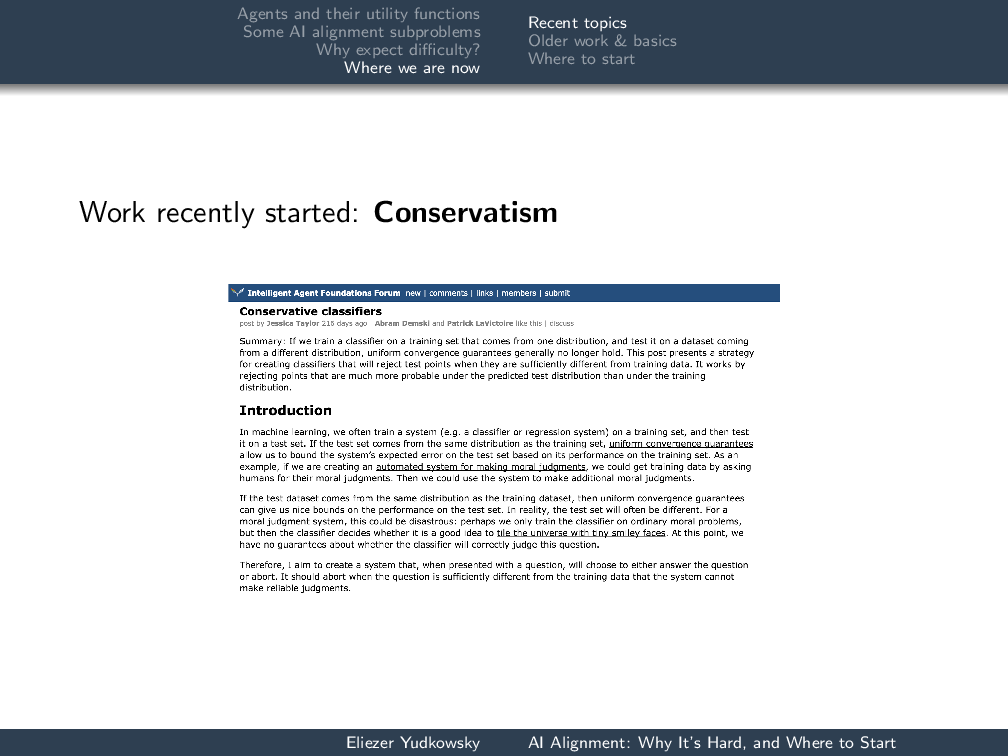 保守性。ブリトー問題への取り組み方の一部である。「いいからブリトーを作ってくれ!」
ブリトーの例を五つ示したなら、ブリトーと非ブリトーを分類する 最も単純な 方法を追求してほしいのではない。五つをすべてブリトーに分類し、非ブリトーは一つもそう分類せず、正例を覆う領域を可能な限り小さくしながらも、以前のものと分子レベルで同一ではない新しいブリトーをAIが作れるだけの空間を、正例の周囲に残す分類法を考案してほしい。
これが保守性である。ブラックリストに載った物事をしないのではなく、突然広大な領域を覆わない形で新しい物事をホワイトリストへ加え、AIの能力を広げるという、AGIへのホワイトリスト型アプローチの中核になり得る。テイラー(Taylor)「保守的分類器」を参照。
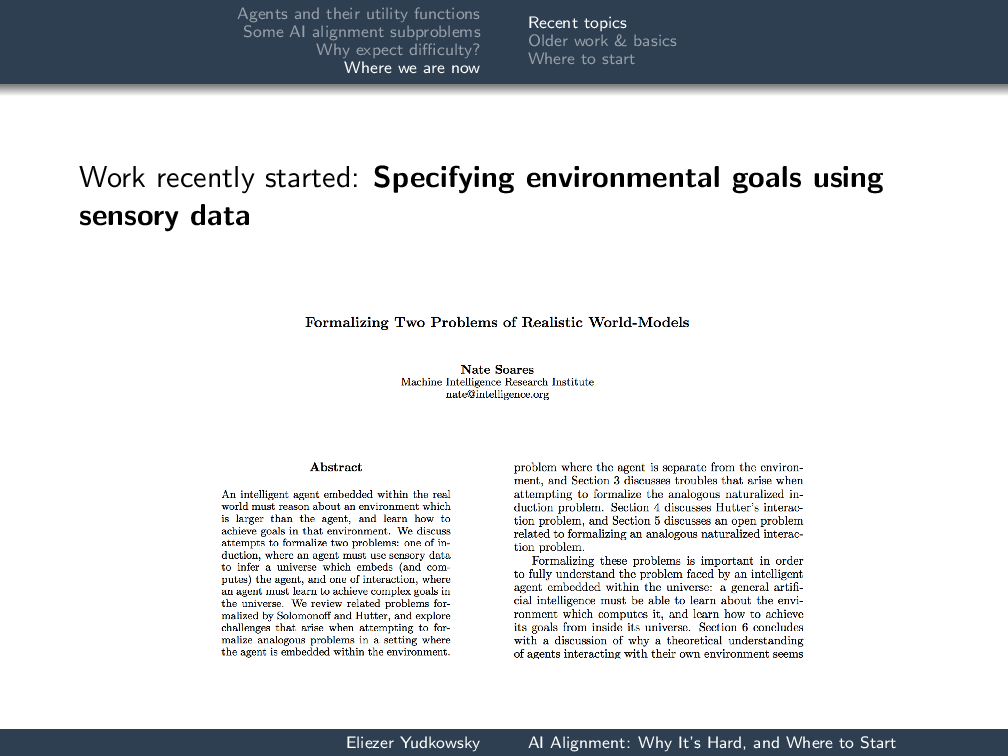 感覚データを使った環境内目標の指定。これは「高度なAIアルゴリズムが現代の機械学習アルゴリズムに多少似ていたら?」というプロジェクトの一部である。現代の機械学習アルゴリズムが急に少し手ごわく見えた、などの出来事を受け、私たちが比較的最近取り組み始めたものだ。
現代のアルゴリズムの多くは、いわば感覚データを基に動く。しかしAGIを想像するなら、成功の 画像 を作ってほしいのではない。感覚データの原因――「何が私にこの特定のピクセルを見せているのか?」――について推論し、その原因を目標にしてほしい。現代のアルゴリズムを適応させ、「即時の感覚データで表現できるこの目標ではなく、環境内のこの目標を追うよう、このシステムを強化している」と、どう言い始めればよいのか? ソアレス「現実的な世界モデルの二つの問題を形式化する」を参照。
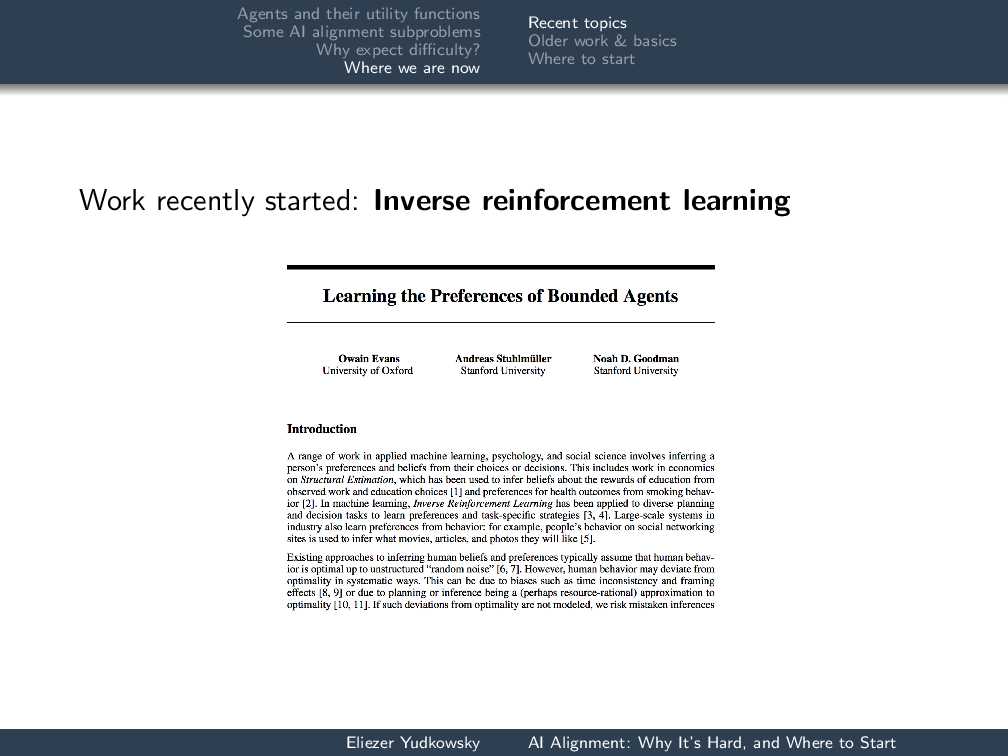 逆強化学習とは、「別のエージェントを観察し、何を望んでいるか推定する」ことだ。
エヴァンズ(Evans)ら「能力に限界のあるエージェントの選好を学習する」を参照。
 行動ベース・エージェントは、善良なAIを作るためのポール・クリスティアーノ(Paul Christiano)による、まったく異なる刺激的なアプローチである。彼がしようとしていることを私なりに表現すれば、「善良なAGI」という問題全体を、人間の行動と回答を模倣する教師あり学習へ分解しようとしている。「このチェス木をどう探索するか?」と言う代わりに、クリスティアーノなら、「別の模倣された人間を見る模倣された人間を真似し、各段階で最善手を選びながら、チェス木を再帰的に探索するにはどうするか?」と言うだろう。
世界の見方として非常に奇妙であり、それゆえ非常に刺激的である。実際に機能するとは予想していないが、一方で彼がこれに取り組み始めてまだ数年しかたっていない。同じ期間だけ取り組んだ時点では、私の考えは はるかに 悪かった。クリスティアーノ「行動ベース・エージェント」を参照。
 穏当な最適化。「効用関数をそれほど強く最適化するな。大釜を満たすだけでよい」と述べる、何らかの原理的な方法はあるか?
テイラー「クォンタライザー(分位点にもとづく選択器)」を参照。
以前の研究と基礎
 以前の研究をいくつか挙げよう。AIXI は、この分野における理想化された完全な球体である。「無制限の計算能力があれば、どう汎用人工知能を作るか?」という問いへの答えだ。
無制限の計算能力があっても汎用人工知能をどう作るか分からないなら、フッター(Hutter)の「普遍的アルゴリズム知能」を読むとよい。
 タイリング・エージェント はすでに扱った。
ファレンスタイン(Fallenstein)とソアレス「ヴィンジ的内省」を参照。
 ソフトウェア・エージェントの協力。これは私たちが行った実に見事な研究で、動機を説明するのはいささか難しい。意思決定理論には、学界で支配的な因果的意思決定理論という版がある。因果的意思決定論者は、別の因果的意思決定論者を作らない。私たちは、その安定した版がどのようなものか解明しようとし、さまざまな実に刺激的な結果を得た。たとえば、二体のエージェントを用意し、囚人のジレンマに似たゲームで、エージェント A がエージェント B について何かを証明しようとし、同時に後者が A について何かを証明しようとして、最終的に囚人のジレンマで協力することを示せる。
これはいまや実行可能なコードがあり、実際に新しいエージェントを形式化できる。あなたが自分へ協力すると証明できた場合に囚人のジレンマであなたへ協力するFairBotというエージェントがある。だがFairBotには、何にでも常に協力するCooperateBotへ協力する欠点がある。そこでDefectBotには裏切り、CooperateBotにも裏切り、FairBotとは協力し、自分自身とも協力するPrudentBotがある。ラヴィクトワール(LaVictoire)ら「ローブの定理による囚人のジレンマのプログラム均衡」と、クリッチ「パラメトリックな有界ローブの定理と、有界エージェントの頑健な協力」を参照。
 反射的オラクル は、停止性問題の証明器を無作為化した版である。そのため自身について命題を述べられ、それを使って、AIがほかのAIを可能な限りシミュレートすることについて原理的に述べ、古典ゲーム理論の下にも興味深い新しい基礎を据えられる。
ファレンスタインら「反射的オラクル」を参照。
どこから始めるか
どこでこの研究に取り組めるだろう?
バークレーの機械知能研究所(Machine Intelligence Research Institute, MIRI)。私たちは独立組織で、個人寄付者に支えられている。つまり、奇妙な書類上の要件などはない。これらの問題を進展させる能力を示せるなら、採用する。
人類未来研究所(Future of Humanity Institute, FHI)はオックスフォード大学の一部であり、要件が少し多い。
スチュアート・ラッセル(Stuart Russell)は、この分野でプログラムを立ち上げ、カリフォルニア大学バークレー校の博士研究員を探している。こちらにも伝統的な学術上の要件がいくつかある。
レバーヒューム知能未来センター(Leverhulme Centre for the Future of Intelligence, CFI)も英国ケンブリッジで立ち上がり、採用を進めている。
特に低インパクトに取り組みたいなら、ダリオ・アモデイ(Dario Amodei)とクリス・オラー(Chris Olah)に話すとよいかもしれない。行動ベース・エージェントに取り組みたいなら、ポール・クリスティアーノと話せる。
一般には、この分野で働きたく、「入門のためどのワークショップへ行けばよいか? 実際にはだれと研究すべきか?」を知りたいなら、[email protected] へメールしてほしい。