
EA Global 2016会議で、私は「AIリスクへの対処に機械学習を用いる」という講演を行った。
将来の汎用人工知能システムが、現在の機械学習システムと多くの性質を共有することは十分あり得る。そうだとすれば、こうしたシステムが意図どおりに頑健に行動することを、どうすれば保証できるだろうか。この問いに焦点を当てたMIRIの新しいプロジェクトについて、その技術研究課題を論じる。
講演の録画がオンラインで公開された。
ジェシカ・テイラー(Jessica Taylor) ― Using Machine Learning to Address AI Risk ― EAG 2016
この講演は、「高度な機械学習システムのアライメント」という研究課題のもとで私たちが取り組んでいる技術的問題を、一般向けに手短に概観したものである。以下には講演をブログ記事の形にした版を掲載する。((MIRI/FHI Colloquium on Robust and Beneficial AIでも、この講演の別版を行った。))
講演の構成:
1. この研究課題の目標
2. きわめて高い能力を持つAIシステムに生じ得る六つの問題
2.1. 行動を評価しにくい
2.2. 曖昧なテスト例
2.3. 人間の振る舞いを模倣する難しさ
2.4. 現実世界についての目標を指定する難しさ
2.5. 負の副作用
2.6. それでも目標を満たす境界事例3.1. KWIK学習
3.2. この問題のベイズ的な見方4. その他の研究課題
この研究課題の目標
この講演では、きわめて高い能力水準に達してもAIシステムを安全にするために、機械学習を用いることを目指す新しい研究課題を扱う。まず研究課題の目標をまとめ、その後、重点を置いている六つの問題群をより詳しく説明する。
この技術研究課題の目標は、一つまたは複数の大規模で有用な タスク を世界で遂行するよう、人間より賢いAIシステムをどう訓練すればよいかを知ることである。
この研究課題では、いくつかの仮定を置く。
- 将来のAIシステムは、多くの点で現在の機械学習(ML)システムをより強力にしたものに近い可能性が高い。たとえば、より優れた深層学習アルゴリズムが得られるかもしれないが、それでも深層学習に似た何かへ大きく依存し続ける可能性が高い。((別の見方として、AGIは大半の点で現代のMLに似ないと思う一方、MLに関わる側面は現在でも生産的に研究しやすく、将来の発展によって完全に無関係になることもなさそうだ、と考えることもできる。))
- 汎用人工知能(AGI)は比較的近い将来(たとえば今後二十年ほど)に開発される可能性が高い。((別の見方として、実現までの期間は長いと思う一方、より切迫しているため短期間で実現するシナリオに重点を置くべきだ、と考えることもできる。))
- タスク指向AGIを構築するのはよい考えであり、その方法の研究は現在でも進められる。
この三つの仮定がすべて真だという確信はないが、AIコミュニティーが最も可能性の高い代替シナリオとおおむね同じだけ注目するに値する程度には、もっともらしいと考えている。
タスク指向AIシステムとは、「百万戸の住宅を建てる」や「がんを治療する」のような、ある程度具体的な世界内の目的を追求するシステムである。『Superintelligence』を読んだ人にとっては、タスク指向AIはジーニーAIという考えに近い。これらのタスクには多少曖昧なところがある――百万戸の住宅を建てるとは本当はどういうことか、あるいは何が良い住宅に数えられるかを明確にするには、おそらく多くの作業が必要になる――が、それでもある程度は具体的である。
タスク指向でない AGIシステムの例は、「人間の価値観を学び、人間が十分に熟考したうえでよいと考えることを行う」という目標を持つシステムである。これは、ここでいう「タスク」と呼ぶには抽象的すぎる。世界にある具体的な事柄へ直接落とし込まれていないからだ。
期待しているのは、タスク指向AIが「人間の価値観を学び、私たちが望むことを行う」より控えめな目的を追求するにすぎなくても、世界規模の壊滅的リスクを防ぐにはなお十分だということである。差し迫ったリスクを回避した後なら、時間的圧力を抑えた状態で、より野心的なAIシステムの構築に取り組める。
タスク指向AIは、目標を明確にし、その計画を評価・実行するために、ある程度の(中程度の)人間の支援を用いる。「がんを治療する」のような目標は曖昧なので、その意味を明確にする作業の一部は人間が行わなければならない。ただし、知的作業の大半は人間ではなくAIシステムが担うべきである。
理想的には、タスク指向AIは競合するシステムより大幅に多くの計算資源を必要とするべきでもない。安全なシステムを構築したために、汎用的なシステムと比べて指数関数的に遅くなるべきではない。
この全体目標について考えるには、将来のシステムについて何らかのモデルが必要である。ここで取る一般的なアプローチは、現在のシステムを見て、それをさらに強力にした姿を想像することだ。MLで人々が取り組むタスクを見ると、時間とともに性能が向上している場合が多い。そこで、MLタスクでシステムが今後もより高い得点を達成し続けると仮定するだけで、より高度なAIシステムをモデル化する。そのうえで、システムが向上するにつれてどのような故障モードが生じそうか、また、そうした故障を起こりにくく、あるいは被害の小さいものにするため、現在何に取り組めるかを問う。
きわめて高い能力を持つAIシステムに生じ得る六つの問題
問題1:行動を評価しにくい
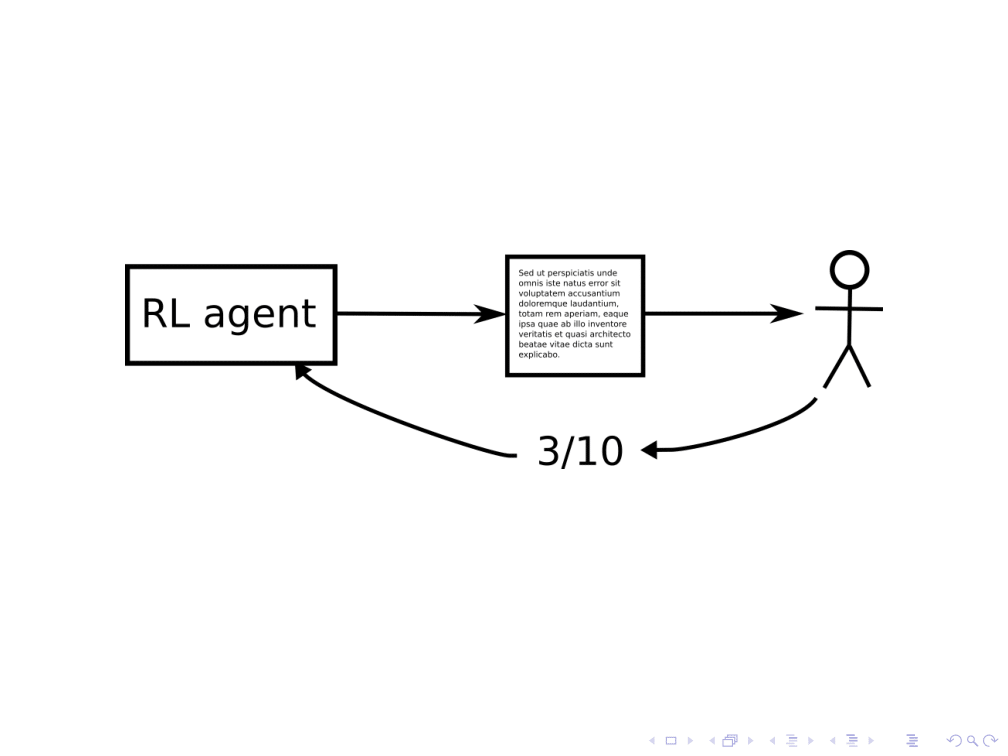 AIシステムが物語を書き、人間がその出来に基づいてシステムへ報酬を与えるとしよう。((ここでは物語を例にするが、現実には、がんを治療する計画をシステムが作り、人間がその計画のよさを評価する場合なども考えられる。))
これは一部の強化学習(RL)タスクと似ている。エージェントは、将来高い報酬を受け取る原因となることを行いたい。RLの形式体系では、このRLエージェントの目的は、人間から高い得点を与えられると期待される物語を書くことだと表現される。
しかし、この目的によって実際に非常に質の高い物語を得るには、人間がRLエージェントの行動を十分よく理解して、報酬を正しく与えられることも分かっていなければならない。この仮定は、現在のどのシステムよりもはるかに強力に目的を最適化するシステムでは、成り立つ可能性が低そうだ。たとえば、次のことが考えられる。
- 人間よりはるかに賢いシステムは、人間を操作したり強制したりして、質の悪い物語に高い得点をつけさせられるかもしれない。
- それほど賢くないシステムでも、盗用に頼るかもしれない。盗用は、検出するより生成するほうが容易な場合がある。検出にはしばしば、より大きな原資料群をくまなく調べる必要があるからだ。
- 人間未満の能力のシステムでも、物語へステガノグラフィー(秘密情報を別の情報に埋め込む技術)を挿入する点では有利かもしれない。秘密のメッセージの埋め込みには多項式時間、検出には指数時間がかかる場合がある。このような隠密行動をエージェントに思いとどまらせる方法があれば、行動の影響を監視し、運用者を判断過程に関与させ続けることが容易になる。
これを一般的に防ぐ方法はあるだろうか。RLシステムに、行動(たとえば物語)だけでなく、監督者がシステムの成果をよりよく評価する助けとなる報告も出力するよう訓練できるだろうか。OpenAIの研究者ポール・クリスティアーノ(Paul Christiano)にならい、これを情報を与えられた監督(informed oversight)の問題と呼ぶ。((「その報告も元の物語と同じ懸念の対象になるのでは?」といった質問については、講演の質疑応答部分を参照。))
問題2:曖昧なテスト例
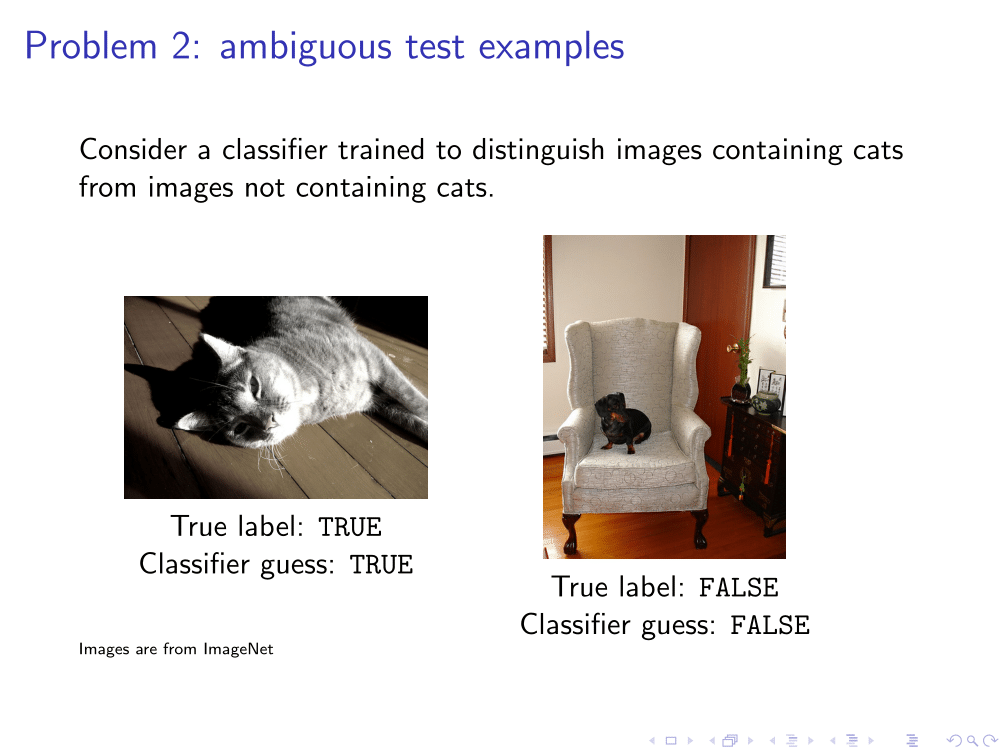 別の問題を考えよう。猫の画像と猫を含まない画像を区別するよう訓練された分類器、またはがんを検出するよう訓練された分類器を考える。あなたには「野生のネコ科動物も猫である」と分かるだけの豊富な人生経験があるだろう。しかし、訓練データ集合に飼い猫と犬の画像しかなければ、訓練中にこの事実を推論することはできないかもしれない。
特定のデータ集合から画像を分類することにおいて超人的に優れたAIシステムでも、人間と同じ一般化を構築しないかもしれず、新しい環境では信頼できないものになり得る。
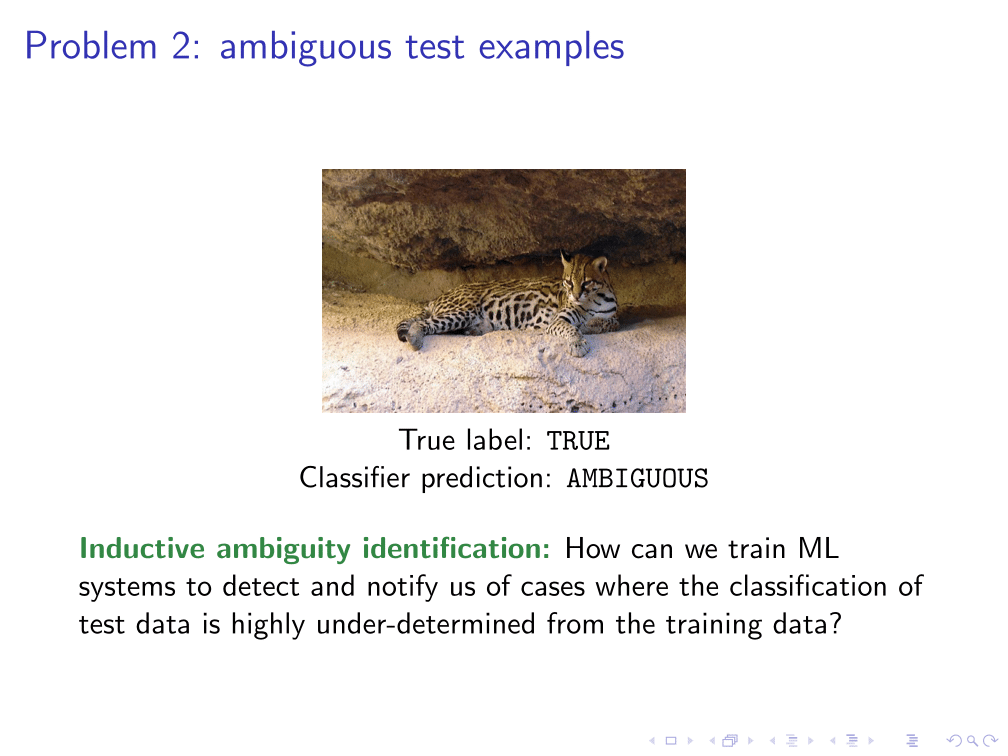 安全性が決定的に重要な状況では、理想的には分類器に「これは曖昧だ」と言わせ、その画像のラベルが訓練データ集合の画像ラベルだけからは一意に定まらないことを知らせてほしい。そうすれば、分類器の分類能力を活用し、システムが誤分類する可能性が比較的高い状況で介入できる。また、元のデータに情報が欠けていた軸に合わせた訓練データも提供できる。この目標を形式化するのが、帰納的曖昧性の検出(inductive ambiguity detection)問題である。
問題3:人間の振る舞いを模倣する難しさ
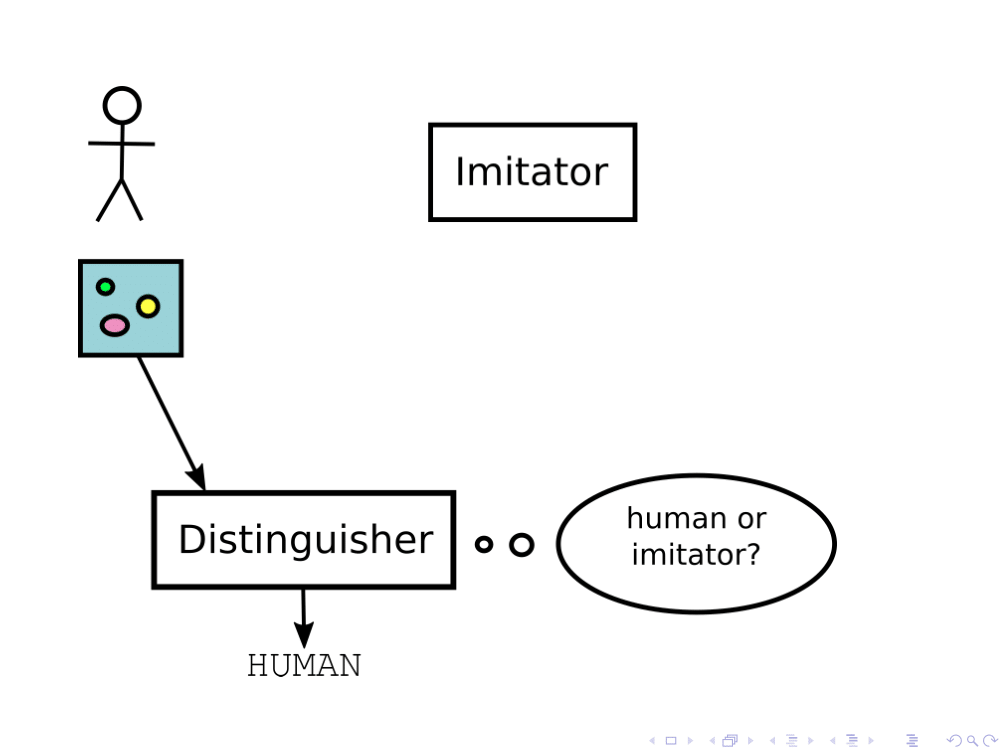 人間より賢いAIの問題に対処する一つの方法は、単に人間を模倣させることかもしれない。何らかのタスクを人間が遂行しようとする様子をシステムに観察させ、同じように振る舞うことを学ばせれば、AIシステムの認知上の優位性を活用しながら、かなり通常の戦略から大きく外れないようにできるかもしれない。
例として、人間が描くような絵を作ることを課されたAIシステムを考えよう。実際には、この目的についてシステムをどう訓練すればよいだろうか。
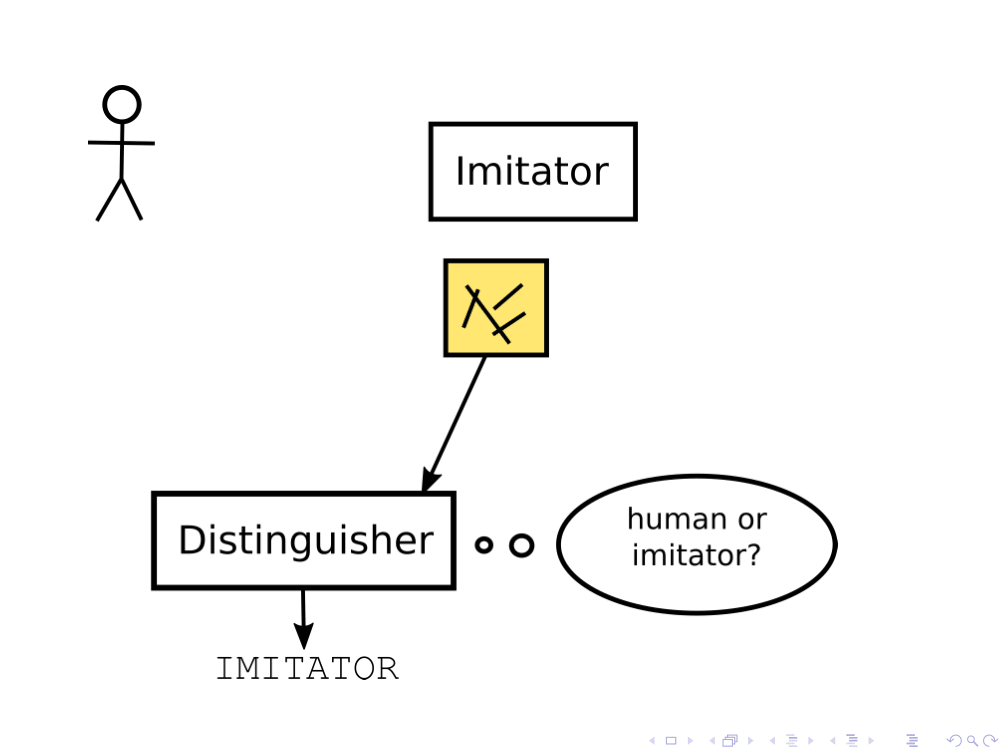 一つのアプローチである敵対的生成ネットワーク(GAN)では、人間と二つのAIエージェント、すなわち模倣器と識別器を用いる。((Ian J. Goodfellow et al. “Generative Adversarial Nets”. In: Advances in Neural Information Processing 27. Ed. by Z. Ghahramani et al. Curran Associates, Inc., 2014, pp. 2672-2680. URL: https://papers.nips.cc/paper/5423-generative-adversarial-nets.pdf.)) 識別器は、与えられた絵が人間と模倣器のどちらから来たかを推測しようとする。模倣器は、人間から来たものだと識別器が分類するような画像を作ろうとする。
これはかなり興味深い仕組みだが、いくつかの理論的問題を生じさせる。「識別器は模倣器より賢くなければならないのか。そうなら、どの程度賢くなければならないのか」と問える。識別器が模倣器より賢くなければ、模倣器は識別器が気づけないほど微妙である限り、ひそかに人間らしさを大きく欠く処理を画像に施せるだろう。ここで未解決の研究方向となるのは、この種の仕組みを分析し、どのような条件なら望ましい頑健性の保証を得られるか問うことである。
この問題について詳しくは、ポール・クリスティアーノの「Act-Based Agents」と「Mimicry and Meeting Halfway」を参照。
問題4:現実世界についての目標を指定する難しさ
サンドイッチを作るようなタスクをAIシステムに行わせたいとしたら、どうだろうか。一つの方法は、サンドイッチの材料でいっぱいの部屋にいるロボットへシステムを接続し、一連の行動を実行させ、人間の観察者がサンドイッチ作りにどこまで近づけたかに基づいてロボットの成果を評価することだ。その評価がロボットの報酬を決める。
十分な能力を持つRLエージェントは、評価しにくい行動を選ぶかもしれないと先に述べた。ここではさらに、有用なタスクには現実世界での物理的行動が必要になることが多いという問題に直面する。システムに十分な能力があれば、この仕組みは報酬ボタンを奪って自分で押す誘因を与える。現在の能力水準をはるかに超えた後までAIシステムがRLの枠組みで訓練され続けると想像するなら、RLの形式体系によれば、それが最善の行動となる。
そこで当然生じる問いは、能力が向上するにつれてサンドイッチ作りもひたすら上達し続け、何か別のことをする誘因を持つ転換点には決して達しないAIシステムを訓練できるか、というものだ。関心のあるタスクの代理指標(プロキシ)に頼らず、そのタスク自体を完遂することに価値を置くようシステムを訓練できるだろうか。これが一般化可能な環境目標問題である。
問題5:負の副作用
部屋にサンドイッチを置きたいと望むシステムを作ることに成功したとしよう。計画を選ぶ際、システムはサンドイッチができる確率の高いほうを選ぶ。単に歩いていってサンドイッチを作る方策の成功率は99.9%かもしれない。しかし、人間が介入してロボットの電源を切る可能性は常にある。そのような介入の確率を下げる方策なら、最終的に部屋にサンドイッチがある確率を99.9999%まで高められるかもしれない。このように、十分に高度なMLシステムは、報酬ハッキングの危険がなくても、開発者や運用者を妨害する誘因を持つに至り得る。
これは、タスクの達成能力を超人的な水準まで高められ、しかもその過程で負の副作用を起こさないタスク指向システムを設計するという問題である。
この問題への一つの対応は、異なる方策が世界に及ぼす総影響量を定量化することだ。そうすれば、影響の大きい行動にペナルティー項を加え、影響の小さい戦略をシステムに選好させられる。
別のアプローチは、成功確率がわずか99.9%でも満足するようAIシステムをどう設計できるか、と問うことだ。その閾値を満たす方策を一つ見つけた時点で、より優れた方策を考え出そうとするのをシステムにやめさせればよい。これは穏健な最適化を形式化する問題である。
あるいは、収束的な道具的戦略という観点から高度なAIシステムを考えることもできる。システムが何をしようとしていようと、計算資源を増やすこと、プログラマーにより好かれること、資金を増やすことは、おそらく役に立つ。サンドイッチ作りのシステムは材料をもっと買うために資金を欲しがるかもしれず、物語を書くシステムは学習用の本を買うために資金を欲しがるかもしれない。多様な目標から似た道具的戦略が導かれ、その多くは資源の制約によって対立を生みそうである。
そこで一つのアプローチは、こうした道具的戦略を直接研究し、それを示さないシステムを設計する方法を探すことだ。これらの戦略、特に敵対的な戦略に共通する特徴を特定できれば、その戦略を追求する誘因を事前に回避できるかもしれない。これは難しそうで、まだ十分に具体化されてもいないが、この方向を目指す初期研究はいくつかある。
問題6:それでも目標を満たす境界事例
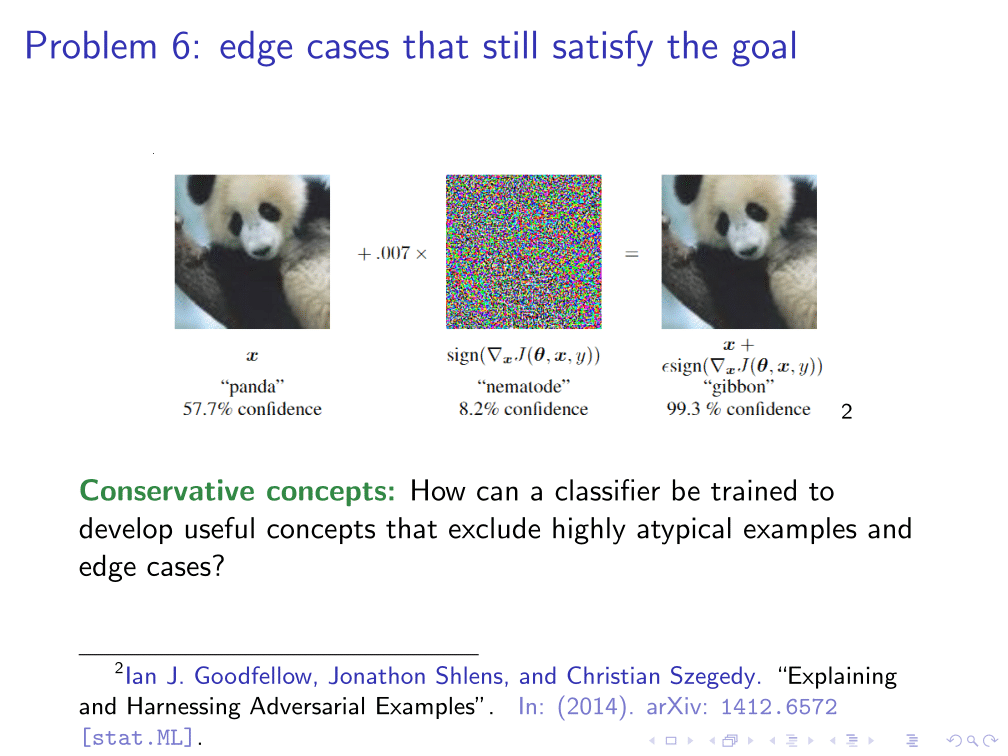 MLシステムが高度になるにつれて深刻化しそうなもう一つの問題は、境界事例である。
サンドイッチについての通常の概念を考えよう。技術的にはサンドイッチに数えられても、通常のサンドイッチと同じ実用上の用途を果たしそうにないものは多い。極端に小さいか大きいサンドイッチや、有毒なサンドイッチもあり得る。
現在のシステムに見られるこの振る舞いの例として、画像分類器が57%の確信度でパンダだと正しく分類した画像を考えられる。グッドフェロー、シュレンズ、セゲディは、この画像へごく小さなベクトルを加えると、分類器が99%の確信度でテナガザルだと誤分類するようにできることを見いだした。((Ian J. Goodfellow, Jonathon Shlens, and Christian Szegedy. “Explaining and Harnessing Adversarial Examples”. In: (2014). arXiv: 1412.6572 [stat.ML].))
MLシステムが、人間が検討しそうな(さらには検討できる)範囲よりも広い解空間を探索し始めれば、このような境界事例はより一般的で危険なものになりそうだ。この場合も、システムは従来の尺度上の得点を最大化する能力をますます高めながら、私たちが関心を持つ現実的な目標を達成するうえでは信頼性が低くなり得る。
保守的概念は、探索空間の端に近い例を肯定的に分類しない方向へシステムを偏らせることで、この問題に対処しようとする初期のアイデアである。その場合、完全に良好なサンドイッチの一部を不適格だと考える間違いは犯すかもしれないが、有毒な、あるいはそれ以外の奇妙なサンドイッチを適格だと分類する、より危険な間違いは犯さないだろう。
一つの問題の技術的詳細:帰納的曖昧性の同定
私は、MLシステムがその目的――プログラマーの意図とは厳密には一致しないかもしれない目的――を最適化する能力を高めるにつれて発生し始めそうな(または深刻化しそうな)六つの問題に対し、八つの研究方向を示した。その研究方向は次のとおりである。
- MLシステムの行動を解釈・評価しやすくするための、情報を与えられた監督。
- 訓練データから十分な情報が得られなかった状況で立ち止まり、監督者へ確認する分類器を設計するための、帰納的曖昧性の同定。
- MLシステムに人間の安全に寄与する特徴を再現させるための、頑健な人間の模倣。
- RLエージェントが報酬信号を支配しようとする道具的誘因を防ぐための、一般化可能な環境目標。
- 超人的に有効な最適化による負の副作用を汎用的な方法で防ぐための、影響測度、穏健な最適化、道具的誘因の回避。
- 境界事例を避けるための、保守的概念。
これらの問題は、「高度な機械学習システムのアライメント」でさらに詳しく論じている。こうした問題へ実際に取り組むとはどのようなことか、より明確に伝えるため、例となる一つの問題を技術的に詳しく説明する。
KWIK学習
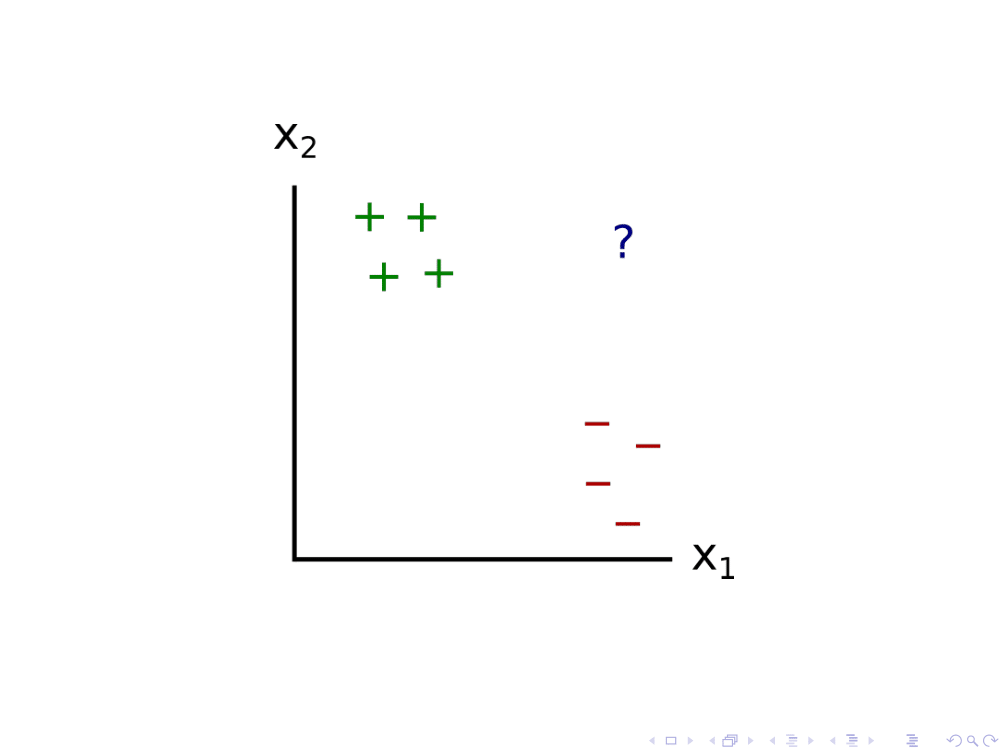 2D(二次元)平面上の点を分類する分類器に、帰納的曖昧性の同定問題を適用することを考えよう。この場合、肯定例が4つ、否定例が4つある。
新しい点が入ってきたとき、分類器は過去のデータと整合するモデルを多数描くことで、その点にラベルをつけようとするかもしれない。ここでは4つだけ描いている。疑問符は異なるモデルのそれぞれで反対側に位置しており、データを踏まえるとこれらのモデルがすべてもっともらしいことを示唆する。
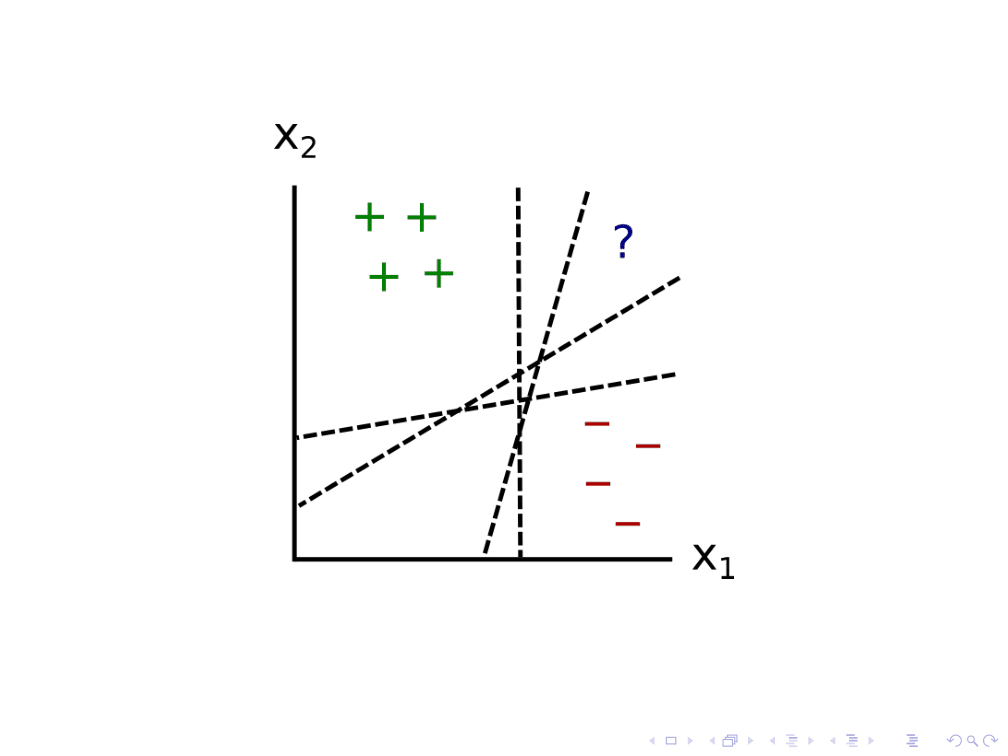 システムはここから、新しい点の分類について訓練データが曖昧だと推論し、人間にラベルづけを求めるものとしよう。人間がその点へプラスのラベルをつけると、システムはどのモデルがもっともらしいかについて新たな結論を導くかもしれない。
このアプローチは「Knows What It Knows(自分が何を知っているかを知る)」学習、略してKWIK学習と呼ばれる。ある入力空間 X ≔ ℝⁿ から始め、入力を確率へ写す何らかの真の写像が存在すると仮定する。たとえば、猫分類器が遭遇する各画像について、「この画像が猫である確率はどれほどか」という問いには、集合 Y ≔ [0,1] 内の真の答えがあると仮定する。この確率は、人間がその画像に「0」ではなく「1」というラベルをつける確率に対応し、重み付きコイン投げとして表せる。モデルは入力を答えへ写し、この場合の答えは確率である。((KWIK学習の枠組みはこれよりはるかに一般的であり、ここでは一例だけを挙げている。))
KWIK学習器はあるゲームを行う。ゲームの開始時に、真のモデル h* が一つ選ばれる。真のモデルは仮説集合 H に含まれると仮定する。各反復 i で、新しい例 xᵢ ∈ ℝⁿ が一つ入ってくる。それには真の答え yᵢ = h*(xᵢ) があるが、学習器には真の答えが分からない。学習器には二つの選択肢がある。
- 答え ŷᵢ ∈ [0,1] を出力する。
- |ŷᵢ – yᵢ| > ε なら、学習器はその時点でゲームに負ける。
- その例が曖昧だと示すため、⊥を出力する。
- その場合、学習器は観測集合 Z ≔ {0,1} から真のラベル zᵢ = FlipCoin(yᵢ) を観測できる。
目標は負けず、しかも⊥を出力しすぎないことである。結論として、仮説クラス H が小さな有限集合または低次元の線形クラスなら、実際にこのゲームへ高い確率で勝てる。これはかなり興味深い。ある種の不確実性については、曖昧さをそのまま解消できることが分かる。
その仕組みはこうである。新しい入力が来るたびに、過去に良好な成績を上げた複数のモデル h を検討し、モデル間で h(xᵢ) がεを超えて異なる場合に「曖昧」だとみなす。その後、時間の経過とともにモデル集合を絞り込んでいく。
KWIK学習器は帰納的曖昧性という考えを、どのモデルが正しいか分からない状態として表す。モデルの集合があり、その多くがもっともらしく、どれが正しいモデルか分からないのである。
これにはいくつか問題がある。主な問題の一つはKWIK学習の実現可能性の仮定、つまり真のモデル h* が実際に仮説集合 H の中にあるという仮定である。現実には、仮説は頭の中に収まらなければならないため、実際の宇宙が仮説クラスに含まれることはない。もう一つの問題は、この方法がきわめて単純なモデルクラスにしか使えないことだ。
この問題のベイズ的な見方
ここまでは、帰納的曖昧性の同定についての既存研究だった。これに関連してMIRIではどのような研究を行ってきたのだろうか。
最近、私はこの問題にベイズ的な観点から取り組もうとしている。この見方では、入力空間からラベルへの写像 X → {0,1} 上に、ある事前分布 Q がある。私たちの仮定は、この事前分布が何らかの点で誤っており、これらの写像上に未知の「真の」事前分布 P があるというものだ。目標は、システムが Q にしかアクセスできなくても、すでに P を知っていた場合とほぼ同じほど上手に(P に関する期待値で)分類タスクを遂行することである。
このタスクは難しそうだ。現実世界が P から標本抽出され、P が自分の事前分布 Q と異なるなら、得られる保証はそれほど多くない。この問題を取り組み可能にするため、真理の一片の仮定(grain of truth assumption)を加えられる。
$$\forall f : Q(f) \geq \frac{1}{k} P(f) $$
これは、P がある対象に高い確率を割り当てるなら、Q もその対象に高い確率を割り当てる、という意味である。この種の仮定のもとで、さまざまな分類タスクにおいて良好な性能を得られるだろうか。
この研究方向はまだ完了していないが、初期成果は、少なくとも一部の場合(オンライン教師あり学習など)には、壊滅的な振る舞いを避けながら、このタスクでかなりよい成績を上げられることを示唆している。これはいくらか有望であり、間違いなく今後研究すべき分野である。
これが帰納的曖昧性の同定とどう結びつくかを説明しよう。何が真かについて不確かな場合、その不確かさが何についてのものかを表す方法はいくつもある。自分の信念を取り、さまざまな可能性に分割してみることができる。どの可能性が正しいか分からないので、これはある意味で曖昧性である。真理の一片の仮定は、自分の確率分布をいくつかの成分へ分割する何らかの方法があり、そのうち一つの成分が正しい、と述べるものだと考えられる。システムは、どの成分が正しいかを当初知らなくても、良好に機能するべきである。
(この問題についてのより最近の研究は、ポール・クリスティアーノの「Red Teams」と「Learning with Catastrophes」、および私とライアン・ケアリー(Ryan Carey)による研究フォーラムでの成果「Bias-Detecting Online Learners」と「Adversarial Bandit Learning with Catastrophes」を参照。)
その他の研究課題
再び広い視野へ戻り、長期的なAI安全性に焦点を当てたほかの研究課題を考えよう。そのような研究課題の最初のものは、MIRIが2014年に発表したエージェント基礎論報告書で示された。((Nate Soares and Benja Fallenstein. Agent Foundations for Aligning Machine Intelligence with Human Interests: A Technical Research Agenda. Tech. rep. 2014-8. Forthcoming 2017 in “The Technological Singularity: Managing the Journey” Jim Miller, Roman Yampolskiy, Stuart J. Armstrong, and Vic Callaghan, Eds. Berkeley, CA. Machine Intelligence Research Institute. 2014.))
エージェント基礎論の研究課題は、推論と意思決定についての理論的理解を深めることを扱う。現在の理論にある関連する欠落の一例は、完全な証明を行うだけの時間や計算資源がない状況で、数学的命題(コンピューター・プログラムについての命題を含む)を理想的に推論する方法である。これが「Logical Induction(論理的帰納)」で対処している基本問題だ。この講演では、現在のMLと広い意味で似た高度なAIシステムの問題に焦点を当ててきた。対照的に、エージェント基礎論の問題は、システムの細部に依存しない。MLシステムにも当てはまるが、優れた汎用推論を実現し得るほかの枠組みにも当てはまる。
さらに「Concrete Problems in AI Safety」という研究課題がある。((Dario Amodei, Chris Olah, Jacob Steinhardt, Paul Christiano, John Schulman, and Dan Mané. “Concrete Problems in AI Safety”. In: (2016). arXiv: 1606.06565 [cs.AI].)) ここでの考えは、現在のML手法を用いて研究でき、おそらく現在のシステムや近い将来に開発され得るシステムで実証すらできる問題を特に探すことで、AI安全性の問題をより実証的な重点のもとに研究することである。
例として、「RLエージェントが環境を探索し、その仕組みを学んでいる最中にも安全に振る舞うようにするには、どうすればよいか」という問いを考えよう。これは現在のシステムで常に生じ、今日でも比較的研究しやすい問いだが、より高い能力を持つシステムにも当てはまりそうである。
これらの異なる研究課題は、能力の進展に合わせて規模を拡大してもAIシステムの信頼性を高められるようにする方法について、それぞれ異なる観点を示す。多様な観点から多様な問題に取り組むことを奨励すれば、重要な考慮事項を完全に見落とす可能性が下がると期待している。同時に、比較的独立したアプローチがいずれも似た結論へ到達するときには、自分たちが正しい方向に進んでいるという確信を強められる。
今後「高度な機械学習システムのアライメント」という研究課題へ重点的に取り組むMIRIのチームを、私が率いる。この問題にはさらに多くの人が目を向ける余地が大いにあると思う。これらの問題へ取り組むため、多くの新しい研究者を採用し、いくつもの共同研究を開始したいと考えている。この問題に関心があり、数学またはコンピューター科学の確かな素養を持つ方には、ぜひ連絡してほしい。または、この問題についてさらに詳しく読んでほしい。