
ウェブ開発者のマチェイ・チェグウォフスキは最近、AI安全性について講演し(動画、本文)、この問題に取り組む際の標準的な前提には懐疑的であるべきであり、それらの前提から導かれるように見える極端な主張、態度、方針にはなお一層懐疑的であるべきだと論じた。以下では、それぞれの論点に回答する。
まず簡単に構成を述べる。本稿はチェグウォフスキの講演と同じ構成を取り、最初に彼の講演が持つより広い含意について私の理解を示し、次に中心的な考えが正しいかどうかをめぐる内部視点からの議論を詳しく扱い、最後にこうした議論の構造について少し述べる。
(i) より広い含意
チェグウォフスキの第一の懸念は、近い将来にAIが悪用され得る方法は数多くあり、長期的なAIの危険を心配すると、短期的な悪用に対抗する取り組みから注意が逸れるかもしれない、ということのようだ。第二の懸念は、外部視点から見るとAIリスクを心配することには問題があるように見える、ということだ。人間には、近い将来に世界が根本的に変容すると信じる千年王国主義の長い伝統がある。歴史的に、千年王国主義者のほとんどは誤っており、自己破壊的な振る舞いをしてきた。UFOがまもなく着陸して自分を天国へ連れていってくれると考えれば、目先だけを見た金銭上の判断をするかもしれず、UFOが来なかったときには後悔に満ちることになる。
長期的なAIの危険に注目すると短期的なAIの危険から注意が逸れるという懸念は、見当違いだと思う。一種類の危険への関心は、おそらく、それと関係する別種の危険にもいっそう注意を引きつける。また、並外れて高い能力を持つAIシステムに伴うリスクは、近い将来の現代的AIシステムに伴うリスクよりも難しく複雑であるように見えるため、長期的な障害への対処には、より長い準備期間が必要だと考えられる。こうした危険を避けることが一部の楽観論者の考えるほど容易なら、早く始めても失うものはごくわずかである。それが難しい(ただし実行可能な)ことなら、遅く始めることで多くを失う。
外部視点に関する懸念については、人間心理だけに注目して、外部の現実についてどれほど学べるのか疑問に思う。さまざまな理由から、自分は飛べると考えた人は数多い。しかし実際に飛べる人もいるのであり、(この場合なら物理学と工学の規則性から一般化する代わりに)心理的・歴史的な誤りのパターンを根拠としてライト兄弟(Wright brothers)に賭けなかった人は、金を失うことになる。こうした賭けを正しく行う最善の方法は、込み入った内部視点の議論に踏み込むことだ。
ベイズ主義者として、ある考えが奇妙、あるいはいかがわしく見えるという表面的な証拠によって、私たちは信念を更新すべきだという点には同意する。しかし私は、議論は権威から得られる証拠を遮断するとも考える。どことなく奇人に見える一人が、今後100年以内にUFOがグリーンランドへ着陸すると予想する十分な根拠を示せず、同じくどことなく奇人に見える別の人が、今後100年以内に汎用人工知能(AGI)が作られると予想する十分な根拠を示せるなら、その議論を聞いた後には、当初その人物が奇人に見えたかどうかをさほど重視する必要はない。表面的な見かけは本当に役立つが、それにも限度がある。そして表面的な見かけだけから推論することに固執したとしても、この件の見かけはかなり良いと思う。((例として、たとえばスチュアート・ラッセル(Stuart Russell)(バークレー)、フランチェスカ・ロッシ(Francesca Rossi)(IBM)、シェイン・レッグ(Shane Legg)(Google DeepMind)、エリック・ホーヴィッツ(Eric Horvitz)(Microsoft)、バート・セルマン(Bart Selman)(コーネル)、イリヤ・サツケヴァー(Ilya Sutskever)(OpenAI)、アンドリュー・デイヴィソン(Andrew Davison)(インペリアル・カレッジ・ロンドン)、デイヴィッド・マカレスター(David McAllester)(TTIC)、ユルゲン・シュミットフーバー(Jürgen Schmidhuber)(IDSIA)、ジェフリー・ヒントン(Geoffrey Hinton)(トロント大学)を参照。))
チェグウォフスキは、内部視点から11、外部視点から11の批判を提示した。以下では、それらを言い換えてから回答する。
(ii) 内部視点からの議論
1. 曖昧な定義にもとづく議論
AI安全性に取り組むべきだという議論の多くは、定義上のトリックに依存している。「AならばB」と「BならばC」という文はいずれも明白に見えるので、それを使って、より明白でない「AならばC」という主張を論じる。しかし実際には、最初の二つの文で「B」が異なる二つの意味で使われている。
世にある低品質な未来論の多くについては、そのとおりである。しかし、ボストロム(Bostrom)がこの誤りを犯している例を私は知らない。長期的なAI安全性に取り組むべきだという最良の議論は、いくつかの曖昧な用語に依存する。関係する概念の多くについて、私たちはまだ十分に形式的な理解を持っていないからだ。しかし、それは、議論が多義的な語や語義をすり替えた語に依存しているということとは異なる。私の経験上、「汎用知能」のような特定の表現を避けて言い換えても、論争の実質はあまり変わらない。((この考えと曖昧な用語一般について詳しくは、知能とは何か?を参照。))
基本的な考えは、人間の脳はさまざまな認知問題をうまく解け、しかも私たちを問題解決に優れたものにする能力は、問題の異なる分類をまたいで重なり合うことが多い、というものだ。作業記憶が大きい人は、それが認知的負荷の高いほとんどすべての課題で役立つと気づく。思考の速い人もまた、それが認知的負荷の高いほとんどすべての課題で役立つと気づく。
認知問題へのより良い解決策を考え出すことは、暴力的なものか非暴力的なものかを問わず、対人紛争でも決定的に重要であるように思われる。これは、書物から学んだ知識が戦闘で自動的に勝利をもたらすという意味ではない((「ユークリッド(Euclid)が書いた命題も、/教科書の知る公式も、/上着から弾丸をそらせず、/振り下ろされるタルワールを防げない」。))。そうではなく、ライフルを設計することも照準を合わせることも、どちらも認知的課題だという意味である。セキュリティについては、プログラムの穴をプログラムによって発見し修正できるようにするAIシステムが、すでに開発されている。ブラックハットにとっての含意は明らかである。
ここで人間とコンピュータの中心的な違いは、認知作業に使える能力を増やすために認知作業を投入したときの収益が、コンピュータでは人間よりはるかに大きい、という点のように思われる。人は物事を学べるが、学ぶ能力そのものを改善する能力や、その改善能力をさらに改善する能力などには限界がある。コンピュータの場合は、より良いソフトウェアとハードウェアの選択肢があれば、ソフトウェアとハードウェアの双方を改善することが容易になるように見える。
コンピュータチップを使ってより良いコンピュータチップを作る循環は、すでに、人を使ってより良い人を作る循環よりはるかに目覚ましい。機械学習アルゴリズムを使ってより良い機械学習アルゴリズムを作る循環は、まだ始まったばかりだが、これもまた目覚ましい循環になると合理的に予想できる。
ここで重要なのは、この議論を構成する具体的な要素であって、私が使った用語ではない。問題解決能力の中には、ほかよりはるかに汎用的なものがあるように見える。潜水艦、粒子加速器、医薬品を作る点で私たちをマウスより優れたものにしている認知上の特徴が何であれ、それは祖先の環境ではまったく異なる一群の問題を解くために進化したはずであり、海洋工学、素粒子物理学、生化学のための別々の脳モジュールに依存しているはずはない。こうした比較的汎用的な能力は、戦略立案や技術革新のようなことに役立つように見え、それらはさらに、紛争で勝つために役立つように見える。そして機械の脳は生物の脳に対して、いくつかの劇的な優位性を持つ可能性が高い。その一因は、再設計がより容易であること(そしてAIを再設計する課題自体をAIシステムに委ねられるかもしれないこと)と、規模の拡大がはるかに容易であることだ。
2. スティーヴン・ホーキング(Stephen Hawking)の猫にもとづく議論
スティーヴン・ホーキングは猫よりはるかに賢いが、猫の振る舞いの予測で圧倒的に優れているわけではないし、身体上の制約によって猫を制御する能力は大きく損なわれている。したがって、超人的AIシステムも同様に、人間をモデル化したり制御したりするのが不得手かもしれない。
身体はどれほど関係するだろうか。ロボットなら捕らえた者と戦い、走って逃げられるが、サーバーファームに封じ込められたソフトウェア知能は脱出できない、と考える人がいるかもしれない。
これは誤りだと思う。それも表面的でない理由からである。現代経済では、インターネット接続だけで十分だ。株式取引を行う(すでに存在するアルゴリズム取引者の大群がその証拠である)、メールアカウントを登録する、部下へメールを送る、フリーランサー(さらには正社員)を雇う、音声を文字に、あるいは文字を音声に変換する、誰かに電話する、クラウド上の計算ハードウェアを取得する、自分のソースコードをコピーする、といったことには身体を必要としない。AIシステムが猫をキャリーケースへ入れる必要に迫られたなら、ほかの誰もがするようにTaskRabbitで人を雇えばよい。
3. アインシュタイン(Einstein)の猫にもとづく議論
アインシュタインならおそらく猫を囲い込めるだろうが、そのために主として使うのは身体的な力であり、平均的な人間に対する知的優位は役に立たないだろう。これは、超人的AIも実際にはそれほど強力でないことを示唆する。
オペラント条件づけのスケジュールを組み立てる時間があれば、ここで力は必要ない。
しかし、より重要なのは、人間は猫ではないということだ。私たちははるかに社会的かつ協力的であり、抽象的な考えや推論の連鎖にもとづいて日常的に行動する。このため、物理的な脅威を与えず、音声かテキストの通信路だけを使っても、人を説得する(あるいは雇う、脅迫する、など)ことは、猫を説得するより容易である。これらはいずれも、身のこなしの速さや腕力に明白な形で依存してはいない。
4. エミューにもとづく議論
オーストラリア軍が1930年代にエミューを大量殺戮しようとしたとき、エミューは軍を出し抜いた。これもまた、超人的AIシステムが人間との紛争に勝てる可能性は低いことを示唆する。
SFでは、人間と機械の双方に勝つ見込みがある戦争がよく描かれる。そうしたほうがドラマとして面白いからだ。これが実際にはどう見えるかという描写では、xkcd のほうが優れていると思う。
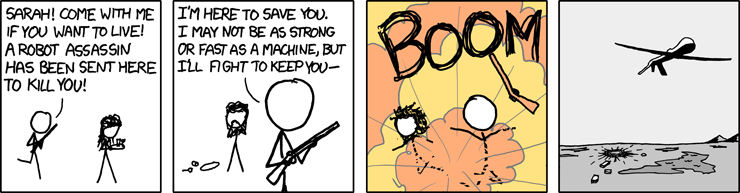
遭遇が繰り返されれば、より知的で適応力のある側が有利になる。私たちは、棍棒と猫でネズミと戦う段階から、罠、毒、不妊化で戦う段階へ進んだ。下流の影響を心配しないなら、おそらくネズミを全滅させる生物兵器も設計できるだろう。((別の害虫、蚊を考えてみよう。蚊が今も存在することを、優れた知能も蚊の速度や飛行能力、あるいは雌一匹が数千個の卵を産む能力にはかなわないという証拠として挙げることもできる。ところが私たちは最近、種を絶滅へ追いやり得る遺伝子改変蚊を放つ能力を開発した。その方法は、雄の蚊に、雄しか子として生まれなくする遺伝子を持たせるというものだ。その子も同じ遺伝子を持ち、雄しか産まないため、やがて雌の蚊の数が個体群全体を維持できないほど少なくなる。
ほかの種に対する人間の優位は完全ではないが、知識を蓄え、新技術を開発するにつれて急速に拡大しているように見える。これは、科学研究と工学で人間を超えるほど優れた何かなら、より急速に優位を増し、絶対的にもはるかに高い水準の支配力に達し得ることを示唆する。人間同士の紛争の歴史は、技術力のわずかな差でさえ、一方の人間集団に他方に対する決定的な優位を与え得ることを示すデータに満ちている。))
5. スラヴ的悲観主義にもとづく議論
「私たちは何一つまともに作れない。安全なウェブカメラすら作れない。それなのに、どうやって倫理を解決し、再帰的自己改良を行う知能のための道徳的固定点を、一度しか機会がないと提唱者たちが論じる状況で、しくじらずにコード化できるというのか?」
これは、それを試みない十分な理由である。合理的なAI安全性ロードマップは、「倫理を解決する」ことや、最初の一回ですべてを正しく行うことを必要とせずに済むよう設計すべきだ。これこそ、高度AIシステムに終わりのない目標ではなく限定的な課題を追求させる方法を見つける、そうしたシステムに訂正可能性(corrigibility)、すなわち人間による修正や停止を妨げず受け入れる性質を持たせる、影響尺度を定義して低影響のシステムを構築する、といった方針の背後にある考えである。「高度機械学習システムのアライメント」と誤りに耐えるエージェント設計は、完全性を要求せずに人間より賢いAIの恩恵を得る方法を見つけることを主眼としている。
6. 複雑な動機にもとづく議論
複雑な心は、複雑な動機を持つ可能性が高い。それこそが、知的であるということの意味の一部なのかもしれない。
AIアライメントを論じる際、これは通常二か所に現れる。第一に、人間の価値観と動機は複雑なので、AIが何を気にかけるべきかについての単純な提案は、おそらくうまくいかない。第二に、AIシステムは、おそらく収束する道具的目標を持つ。つまり、どのプロジェクトを完遂したいかにかかわらず、その完遂に役立つ共通の戦略があることに気づくだろう。((たとえば、ほぼどんな目標についても、稼働を停止する世界より、稼働を続ける世界のほうで、それをより多く達成できると予測できる。このことは、自己保存の目標を何らプログラムされていなくても、人々に自分を停止されないよう努めるべきだということを自然に含意する。オンラインであり続けることが道具的に有用なのである。))
収束する道具的戦略の一部は、オモハンドロ(Omohundro)による基本的AIドライブの論文に見いだせる。高い知能には、世界がどのように機能し、どのような戦略が目標達成に役立つ可能性が高いかについての複雑な理解がおそらく必要である。しかし、複雑さが目標そのものの内容へまで波及する必要はないように思われる。単純な包括的目標を持つ複雑なシステムという考えに、矛盾はない。役に立つなら、正味現在価値を最大化しようとする企業を想像してほしい。これは単純な包括的目標だが、それでも多くの複雑な組織化と計画を生む。
AIアライメントについて考える際の中心的な技能の一つは、擬人化に陥らず、さまざまなアルゴリズムを走らせたり、さまざまな戦略を実行したりした結果を思い描けることである。包括的目標が時間や状況に応じて変わるようにAIシステムを設計することもできるし、人間はしばしばそのように働くように見える。しかし、複雑または不安定な目標を持つことは、人道的な目標を持つことを意味しないし、単純で安定した目標もまったく可能である。
例を挙げよう。あるエージェントが二つの計画を検討しているとする。一方は詩を書くことを含み、もう一方はペーパークリップ工場を建てることを含む。そしてエージェントは、人間を動機づける何らかの複雑なものではなく、期待されるペーパークリップの生産数にもとづいて計画を評価する。この場合、人間が第一の計画のほうがなぜ「より良い」かについて精巧な言葉の議論を組み立てられたとしても、エージェントは第二の計画を選好すると予想すべきである。
7. 現実のAIにもとづく議論
現在のAIシステムは、大量のデータで学習させた比較的単純な数学的対象であり、改善への道のほとんどは、単にデータを増やすことのように見える。これは再帰的自己改良のレシピには見えない。
それは正しいかもしれない。しかし、「人間より賢いAIシステムによる事故について、今日から考え始めることが重要だ」は、「人間より賢いAIシステムが間近に迫っている」を意味しない。この問題が重要であり、理解を深めるために今日できる関連する技術的研究があるから、今考えるべきなのであって、タイムラインに確信しているからではない。
(また、それは正しくないかもしれない。)
8. チェグウォフスキのルームメイトにもとづく議論
「私のルームメイトは、人生で会った中でいちばん頭の良い人だった。とてつもなく聡明だったが、彼がしたことと言えば、マリファナの水パイプを一服しては World of Warcraft で遊び、だらだら過ごすことだけだった」。高度AIシステムも同じように、目標に野心がないかもしれない。
人間は最大化主体ではない。このことは、高度AIシステムに限定的な課題を追求するよう設計し、それによってボストロムが論じている種類の災害を避けられるかもしれないことを示唆する。しかし、安全性をもう一段高めるために年間利益の一部を手放したり競争相手に遅れたりしなければならないなら、当面の利益誘因は、デフォルトでは私たちをその方向へ導かないかもしれない。この分野をその方向へ舵取りしたいなら、「限定的な課題」をよりよく形式化する作業を実際に始める必要がある。
より多様な実用問題を、より迅速、確実、巧みに、効率よく解けるシステムを開発することには、明白な利益誘因がある。一方、World of Warcraft を遊び、それ以外は何もしない完璧なシステムを開発することには、対応する誘因がない。
別の言い方をすれば、最大化は怠惰より指定しやすいため、AIシステムがデフォルトで限定的な野心を持つ可能性は低い。ゲーム理論、経済学、AIはいずれも、何らかの効用関数を最大化しようとするエージェントを記述する数学的形式体系に根差していることに注意してほしい。「限定的な野心」を持つAIシステムが欲しいなら、「限定的な野心を持つかもしれない」と言うだけでは足りない。実際にそうさせる方法の探究を始めなければならない。この話題について詳しくは、「AI安全性の具体的問題」など関連論文にある「低影響」問題を参照。
9. 脳手術にもとづく議論
人間は、自分の中の脳外科に長けた部分を手術し、この過程を繰り返すことができない。
人間にはできないが、これはまさに人間とAIシステムとが異なり得る明白な点の一つである。人間がニューロンやミトコンドリアを作るより良い方法を発見しても、おそらく自分自身には使えない。AIシステムが、たとえばニューラルネットワークの計算をもっと高速に行うため、乗算の代わりにビットシフトを使えると発見したなら、自分自身にパッチを適用し、再起動して、より良く働き始められる。あるいはソースコードをコピーして、非常に速く「子」エージェントを作れる。((AIアライメント研究の課題の一つは、自分が重要だと考えるものを変えずに、これを行う方法を見つけることである。))
多くのAI改善は、この意味で汎用的であるように思われる。AIシステムがより高速なハードウェアを設計するか、単により多くのハードウェアを獲得すれば、より大きな問題へ、より速く取り組める。AIシステムが基本的な学習アルゴリズムの改善を設計すれば、新しい領域をより速く学べる。((ハードウェアとソフトウェアの改善だけで到達できる範囲には限界がある。宇宙中の計算資源を集めても、2048ビットRSA鍵を総当たりで解読するには足りない。しかし人間の創意工夫は、大きな数を素早く因数分解する能力から生まれるのではないし、私たちが走らせているアルゴリズムは規模を拡大できると考える理由は多い。))
10. 子どもにもとづく議論
人間の子どもが知的存在になり始めるまでには、世界やほかの人々と長時間にわたって相互作用する必要がある。AIがどれほど速く発達できるかは明らかでない。
プロジェクト管理には、9人の女性でも1か月で一人の赤ん坊を産むことはできない、という自明の理がある。しかし、この自明の理が機械学習システムに当てはまるかは疑わしい。AlphaGoはここで重要な例に見える。イ・セドル(Lee Sedol)との対局までに、おそらくイ・セドルとほぼ同数の囲碁対局を学習でこなしていたが、年齢は33歳ではなく約2歳だった。
人工システムは時に、人にはない道具を使える。誰かの顔を見るだけで、特定の色チャンネルに注意を限定し、その人の心拍数を割り出すことは、おそらく人間にはできないが、ウェブカメラを備えたソフトウェアならできる。階数10の行列を頭の中で逆行列にすることは、おそらく人間にはできないが、少しのRAMを備えたソフトウェアならできる。
ここで語っているのは、驚くほど年老い経験豊かな人にむしろ近い。たとえば高齢の医師を考えてみよう。20年にわたり、年間250勤務日、1日20人の患者を診たとする。合計で10万回の患者受診になる。これは、英国の国民保健サービス(NHS)と3.6時間の間にやり取りする人々の数と、おおむね同じようだ。機械学習の医師システムにNHSの1年分のデータを学習させれば、5万年分の医療経験に相当するものを、わずか1年で獲得することになる。
11. ギリガン君SOS にもとづく議論
私たちは知能を個々の心の性質として捉えがちだが、文明の力は知能と経験を集約することから生まれる。一人の天才が単独でできることは多くない。
これは逆に思われる。デジタルシステムの性質の一つは、人間同士より素早く滑らかに互いを統合できることだ。サーバーファームAIを一人の巨大なアインシュタインだと考える代わりに、ブレード一枚につき一人のアインシュタインだと考えよう。すると、一つのラックに、協働するアインシュタインの村を複数収められる。採用時の骨の折れる審査過程や人材不足を経る必要はない。より多くのハードウェアを満たすまで拡張するには、コードをコピーするだけでよい。
さらに、一人のアインシュタインが洞察を得たり新しい技能を学んだりするたびに、それをほかのすべてのノードへ素早く伝えられること、新たな計算資源を獲得するたびに完全に訓練済みのフォークを立ち上げられること、人類が蓄積した全知識を出発点として使えることを考慮すれば、サーバーファームはかなり手ごわいものに見え始める。
(iii) 外部視点からの議論
次は外部視点からの議論である。以下の要約には、冒頭に「超知能を真剣に受け止めるなら、……」を補って読んでほしい。
12. 尊大さにもとづく議論
……本当に莫大な価値が懸かっていることになる。
コペルニクス的原理からすると、私たちの時代がこれほど決定的に見えるのは意外である。しかし、決定的な時代に生きているという事前確率は低いところから始めるべきだとしても、決定的な時代が過去に存在したことは分かっている((ロビン・ハンソン(Robin Hanson)は、動物の心の進化、人間の進化、農業の発明、工業化という過去の四つを挙げている。知的労働の自動化は、次の有力候補に見える。))。そして、その方向を指す十分な証拠を目にすれば、やがて自分たちが重要な時代に生きていると信じられるようになるはずだ。
13. 誇大妄想にもとづく議論
……本当に莫大な権力が懸かっていることになる。
長期的には、技術的に実現可能だと分かったどのような方法によってでも、AIを梃子として使い、感覚ある存在の福利を改善しようとするべきなのは明らかである。「倫理のすべてを一度に解決するわけではない」という点が示唆するように、高度AIシステムの開発者が、最初の人間より賢いAIシステムへ与える課題について過信したり野心過剰になったりすれば、非常に悪いことになる。まず控えめで、終わりのないものではない目標から始めるのは良い考えだ。それは謙虚さを示すことが重要だからではなく、控えめな目標は正しく設定できる可能性が高く(そして、誤って設定した場合の危険が小さい)からである。
14. トランスヒューマニズムの呪術にもとづく議論
……ほかにも多くの奇妙な信念が、直ちに導かれることになる。
信念は、その背後にある原理が似ているために、しばしばまとまりを成す。しかし、それでも個々の信念は別物である。AIアライメントが重要だと信じながら、銀河規模の拡張はたいてい採算の合わない浪費だと信じることも、AIアライメントが重要だと信じながら、分子ナノテクノロジーは実現不可能だと信じることも、もちろん可能である。
とはいえ、認知作業が主な障害となっている技術を見るときはいつでも、AIがたどる軌道がその技術に大きな影響を与えると予想するのが合理的に思われる。科学的方法の初期や産業革命の幕開けに文章を書いていたなら、正確な世界モデルを持つためには、少なくともいくつか極端に聞こえる予測をする必要があっただろう。AIがそこまで大きな出来事になるかどうかは議論できる。しかし、そこまで大きな出来事になるなら、極端で未来的な含意が一つもないほうが奇妙である。
15. 宗教2.0にもとづく議論
……宗教のようなものに加わることになる。
人にはバイアスがあり、自分のバイアスに訴えかけそうな考えには警戒すべきである。しかし、バイアスが存在することを使って、対象レベルの考察をすべて無視し、自信満々の技術予測へ到達することはできない。よく言われるように、あなたが偏執的だからといって、彼らがあなたを狙っていないことにはならない。医学と宗教はどちらも病人を治すと約束するが、実際に治せるのは医学である。医学と宗教を区別するには、議論と結果を見なければならない。
16. コミック風倫理にもとづく議論
……英雄願望を持つようになる。
私たちは、研究コミュニティのより大きな割合がこれらの問題に取り組み、成功の可能性が上がることを望んでいる。重要なのは、誰が開発の功績を得るかではなく、AIシステムが責任を持って慎重に開発されることだ。今この問題に取り組み始めれば英雄願望を持つようになるかもしれないが、運がよければ10年後には、単なる通常の研究(ただし、いくつかの特に重要な問題についての研究)と感じられるようになるだろう。
17. シミュレーション熱にもとづく議論
……基底現実ではなくシミュレーション内に住んでいる可能性が高い、と信じるようになる。
私は個人的に、シミュレーション仮説には深い疑問を抱いている。私たちの宇宙は時間的に有限であるように見え、時空において連続的またはほぼ連続的であるようにも見えるからだ。私たちの宇宙が、たとえばMinecraftにもっと似ていれば、この仮説はよりありそうに思えるだろう。(前者は容易に自分自身をシミュレートできないように思われるが、後者は速度を落とせばできるように思われる。シミュレーション仮説で手振りだけによって退けられる「RAMの制約」こそ、おそらく中心的な反論である。)いずれにせよ、これは分野としてのAI安全工学を支持する議論にも反対する議論にもならないと思う。((また私は、「しかし、これを信じるなら魔法を信じることになる。なぜなら、私たちがシミュレーション内にいるなら、一つ上の階層の規則について何も知らないからだ。数学が同じように機能するかさえ分からない。シミュレートしている世界では2+2=5かもしれないし、2+2=?かもしれない」という主張にも同意しない。これは数学の普遍性を過小評価している。私たちをシミュレートする宇宙の物理法則が私たちの宇宙の法則とどう関係するかは分からないかもしれないが、数学は、宇宙ごとに変わり得る物理的事実によって規定されてはいない。))
18. データへの飢えにもとづく議論
……すべての人のデータを捕捉したいと思うようになる。
これはAIアライメントとは無関係に思われる。確かに、AIシステムを構築する人々は、システムの学習に使うデータを求めており、単に素早くではなく倫理的にデータを入手する方法を解明することは、優先事項であるべきだ。しかし、人間より賢いAIシステムがいつの日か存在するかどうか、そしてその選好を私たちの選好と一致させるためにどれほどの作業が必要か、という見解を変えることで、倫理的なデータ取得の実践についての見解が変わるのはなぜだろうか。
19. プログラマー版ひも理論にもとづく議論
……抽象的思考へ入り込み、現実から遊離するようになる。
高度AIシステムについての予測を検証するのが難しいという事実は、非常に大きな問題である。少なくともMIRIは、空中楼閣を築くだけに終わるリスクを減らそうとすることを、研究の基礎に置いている。問題への複数の攻め方を追求する、分野の多様性を高める、考え得る多様なシステムに関係する問題へ注目する、非形式的または半形式的なシステム要件の形式化を優先する、といった方針の要点の一部はここにある。((純粋に非形式的な推測へとどまったり、非形式的な要件を捉えていると確信できる前に非常に限定的な形式枠組みを掘り下げたりすることとは対照的である。))エリーザー・ユドコウスキー(Eliezer Yudkowsky)の言葉を引用する。
考えや方針を結晶化し、ほかの人々が批判できるようにする。「無限の計算能力を使えるなら、これをどう実現するか?」と問うことのもう一つの要点がこれである。手をひらひらさせるようにして「まあ、この機械学習アルゴリズムと、あの機械学習アルゴリズムを適用すれば、結果は云々かんぬんになるかもしれない」と言っていれば、あなたが誤っていると、誰もあなたを納得させられない。無限の計算能力を扱えば、考えを十分に単純にして、人々がそれをホワイトボードへ書き、「誤りだ」と言えるようになり、あなたは同意せざるを得なくなる。不愉快だが、これはこの分野が前進する方法の一つである。
無限の資源を仮定する分析アプローチについて詳しくは、「MIRIのアプローチ」を参照。エイモデイ/オラー(Amodei/Olah)のAI安全性研究課題は別のヒューリスティクスを使い、現在および近い将来のシステムで対処しやすく、なおかつ規模を拡大したシステムにも関係する可能性が高い未解決問題に注目している。
20. 狂気を誘発することにもとづく議論
……自分やほかの人の狂気を助長することになる。
より突飛な考えほど多くの見出しを飾るかもしれないが、より多くの研究人材や資金を惹きつけているとは感じない。ニック・ボストロム(Nick Bostrom)の考えは一般にレイ・カーツワイル(Ray Kurzweil)の考えよりよく検討されており、それに応じて研究コミュニティは、ボストロムの議論に関与し、関連する技術研究を追求することにより大きな関心を示している。ボストロムに同意するかどうか、あるいは分野全体が有益な仕事をしていると思うかどうかにかかわらず、これは、この領域では比較的重要で思慮深い考えほど研究グループから多くの関心を集めていることを示唆する。
21. AIコスプレにもとづく議論
……人々を操り、権力を奪おうとする可能性が高くなる。
人を駒として扱うこと、何らかの大義のために非倫理的に振る舞うことなどの危険については、私たちも同意していると思う。AIアライメントに関心のある人々が、ほかのプログラマー、エンジニア、数学者などと比べ、この点で典型から外れているとは私には明らかでない。そしてほかの外部視点からの批判と同様に、これはAI安全性研究の重要性について大きく信念を更新させるべきものではない。原子力安全保障と封じ込めに何ドルの研究費を投じるかを、レオ・シラード(Leó Szilárd)の気質にどれだけ感心したかを主な根拠として決めたいとは思わないだろう。((チェグウォフスキはスタニスワフ・レム(Stanislaw Lem)の作品を支持しているので、1959年刊のレムの 捜査 (The Investigation)から引用を一つ挙げよう。
両陣営が努力をエスカレートさせ始めれば、どちらも軍拡競争に閉じ込められる。兵器はますます改良されなければならないが、ある時点を過ぎると兵器は限界に達する。次に何を改良できるだろうか。頭脳だ。命令を出す頭脳である。人間の脳を完全にすることはできないので、唯一の選択肢は機械化への移行だ。次の段階は、電子戦略機械を備えた完全自動の司令部になる。すると、とても興味深い問題が生じる。実際には二つの問題だ。マキャット(McCatt)がこの点に私の注意を向けた。第一に、これらの頭脳の発達に限界はあるのか。根本的には、チェスを指せるコンピュータに似ている。相手の戦略を10手先まで予測するコンピュータは、8手か9手先までしか考えられないコンピュータに必ず勝つ。頭脳がより遠くまで先を読む能力を持つほど、頭脳は大きくなければならない。それが一つだ」
……
「戦略上の考慮によって、ますます大きな機械の建設が要請される。そして好むと好まざるとにかかわらず、それは必然的に、頭脳に保存される情報量の増加を意味する。次いでこれは、社会のあらゆる集合的過程に対する頭脳の制御が着実に強まることを意味する。悪名高いボタンをどこに置くかを、頭脳が決める。あるいは歩兵の制服の様式を変えるかどうかを。あるいは、ある種の鋼の生産量を増やすかどうかを決め、その目的を実行するための予算を要求する。この種の頭脳を作ったなら、その言うことを聞かなければならない。頭脳が要求する予算を与えるべきかどうか議会が討論に時間を浪費すれば、相手側が先んじるかもしれない。だから、しばらくすると議会による意思決定の廃止は避けられなくなる。蓄積された知識が増すのに比例して、頭脳の決定に対する人間の制御は減っていく。私の言っていることは分かるかね。大洋の両側に一つずつ、成長する二つの頭脳ができる。このような頭脳が、知覚競争の次の段階へ進む準備ができたとき、最初に何を要求すると思う?」
「能力の増大です」
……
「いや、最初に要求するのは自分自身の拡張だ。つまり、頭脳そのものがさらに大きくなる! 能力の増大はその次だ」
「言い換えれば、世界がチェス盤になり、私たちは皆、二人の機械の競技者による永遠の対局で操られる駒になる、と予測しているのですね」
これは、レムがこの立場を支持するという意味ではないが、こうした問題を考えていたことは示している。))
22. 錬金術師にもとづく議論
……知能が実際にどう機能するかを理解する前に、行動を起こすのが早すぎることになる。
将来が、どのように、何を、なぜという点で驚きをもたらすことは避けられないように思えるが、無関係だと特定できるものはいくつかあるように思える。たとえば、意識の謎は、問題解決の謎とは直交しているように見える。問題解決の手続を自分自身へ適用することが、基本的に意識そのものだという可能性もある。しかし、何が私たちに意識を持たせているかを理解しなくても、そしてその過程でAIシステムに意識を持たせなくても、自らの目標を柔軟に達成できるAIシステムを作れる可能性もある。
(iv) 生産的な議論
以上の論点を扱ったので、生産的な議論がどう機能すると私が考えるかを述べる余地ができた。そのためにまず、ボストロムの議論全体を丁寧に提示したチェグウォフスキを称賛したい。ただし、いくつか細かな点では誤って述べていると思う。(たとえばボストロムは、すべての汎用知能が目標をよりよく達成するために自己改善を望む、とは主張していない。実行可能なら、多くの目標にとって自己改善が有用な下位目標になる、と主張しているだけである。)
問題の中には、実験と観察へ大きく依存して正しい結論に達せられるものもあれば、議論と理論へはるかに大きく依存する必要があるものもある。たとえば砂の城を作るとき、仮説を試す費用は小さい。しかし飛行機を設計するとき、完全な実地試験にはより大きな費用がかかる。その理由の一つは、設計が十分に悪ければ、テストパイロットが死亡する現実的な可能性があることだ。存亡リスクはその連続体の極端な端にあるため、私たちは抽象的な議論へ特に大きく依存せざるを得ない(もちろん、検証可能な予測を可能なときに検証することから、なお利益は得られる)。
言葉による議論に頼らざるを得ないとき、有用な議論の重要な性質は、結論が偽である世界より、結論が真である世界でその議論が成り立つ可能性が高いことだ。「2+2=4」と言う道化にも、「2+2=5」と言う道化にも、同じくらい容易に人身攻撃を向けられる。一方、「あなたの発言は0=1を含意する」という議論が役立つのは、後者の道化に対してだけである。「0=1」は、「2+2=5」に対する有用な反論である。なぜなら、それは特定の欠陥を直接指し示し(両辺から2を二度引けば矛盾が得られる)、真であるものに対しては偽であるものに対するよりはるかに説得力が弱いからだ。
このため私は、外部視点からの議論を疑わしく思う。正しいが非典型的な見解にも向けることがあまりに容易だからである。ノーマン・ボーローグ(Norman Borlaug)が、自分は10億人の命を救うと予測し、それが外部視点によって退けられたとしよう。結局のところ、歴史全体を見渡して、同じことをもっともらしく主張できる人は、ほかにほとんど(あるいはまったく)いなかった。この議論のどこが、ボーローグとほかの誰かとを区別しているのだろうか。実験が安価なら、すべての「史上初」を予測どおり見逃しても許容できる。しかし実験が安価でないなら、これは致命的な欠陥になる。
互いがより正確な信念を持てるよう助けることが目標である限り、相互の「争点」を特定することへ取り組むのも重要だと思う。ある意見の相違について、あなたが真だと考え、私が偽だと考える世界についての命題のうち、あなたがその命題について考えを変えれば私の見解に近づき、逆も同様となるものはあるだろうか。
こうした争点を探し出すことで、枝葉の問題に迷い込まず、最も重大な問いに関係する証拠と議論を、より慎重かつ徹底的に探せる。私の場合、次のいずれかの命題(この中には、あなたがすでに同意しているものもあるかもしれない)を信じなくなれば、あなたの議論にずっと共感的になるだろう。
- エージェントの価値観と能力水準は直交しており、善意が増さなくても力を増すことが可能である。
- ほかの条件が同じなら、より大きな計算能力は、より大きな力につながる。
- より具体的には、より大きな計算能力は自己改善に役立ち得て、それによって倍加時間が年単位より週単位に近い正のフィードバック・ループが生じ得る。
- 割り当てられた目的関数を(近似的に)最大化する自律エージェントを作ることには、強い経済的誘因がある。
- 共感、道徳的推論、自制の能力は、汎用的問題解決に不可欠ではない脳の特殊な特徴へ、ある程度依存している。そのため、共感のある汎用問題解決器を作るより、共感のないものを作るほうが、工学的には単純な課題となる。((たとえばミラーニューロンは、人間の動機系や社会的推論には重要であり得るが、任意の高能力AIシステムの社会的推論には不可欠でないかもしれない。))
これは明らかに網羅的な一覧ではなく、私たち二人が重要だと合意できる一覧を作るには、さらに長いやり取りが必要だろう。