数理AIセーフティ研究所(Mathematical AI Safety Institute)
MAISI
強力なAIシステムの安全性を支える、数学的基盤を築く。
チーム
- 科学部門責任者
 Jacob Tsimerman
2026年フィールズ賞受賞者。トロント大学教授。2023年オストロフスキー賞、2022年ニューホライズンズ数学賞、2019年コクセター=ジェームズ賞、2015年SASTRAラマヌジャン賞を受賞。
- 科学諮問委員会
 Ravi Vakil
スタンフォード大学Robert Grimmett数学教授。2025年からアメリカ数学会会長を務める。若手科学者・技術者に対する大統領賞(PECASE)の受賞者であり、SpringerのGraduate Texts in Mathematicsシリーズの編集者。MathOverflowとProof Schoolを共同設立した。
 Timothy Gowers
1998年フィールズ賞受賞者。コレージュ・ド・フランスの組合せ論講座教授。ケンブリッジ大学トリニティ・カレッジの終身フェロー。2016年シルヴェスター・メダル受賞、2012年ナイト爵叙任、1999年王立協会フェロー選出、1995年ヨーロッパ数学会賞受賞。
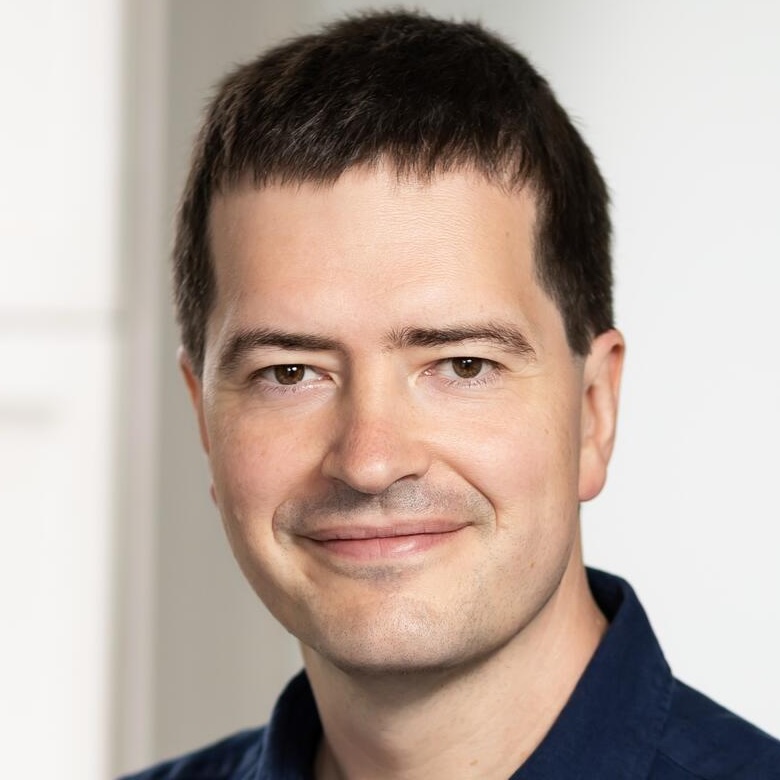 Geoffrey Irving
Resolutionの共同創設者兼チーフサイエンティスト。英国AIセキュリティ研究所の元チーフサイエンティスト。DeepMindとOpenAIでアラインメントのチームを率い、Google Brainではニューラルネットワークによる定理証明を研究するN2Formalを共同で率いた。D. E. Shaw ResearchとPixarでは計算物理学と幾何学に取り組んだ。スタンフォード大学で計算機科学の博士号を取得。
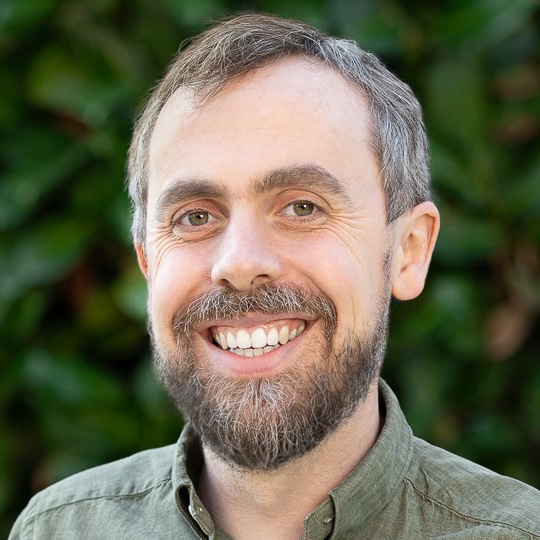 Paul Christiano
Alignment Research Centerの所長であり、Center for AI Standards and Innovationの顧問。以前はOpenAIで言語モデルのアラインメントを率い、米国AIセーフティ研究所では安全部門の責任者を務めた。AnthropicのLong-Term Benefit Trustの初代評議員の一人でもある。2023年に英国のFrontier AI Taskforceの諮問委員会に加わり、TIME誌の「AI分野で最も影響力のある100人」に選出された。
- 執行責任者
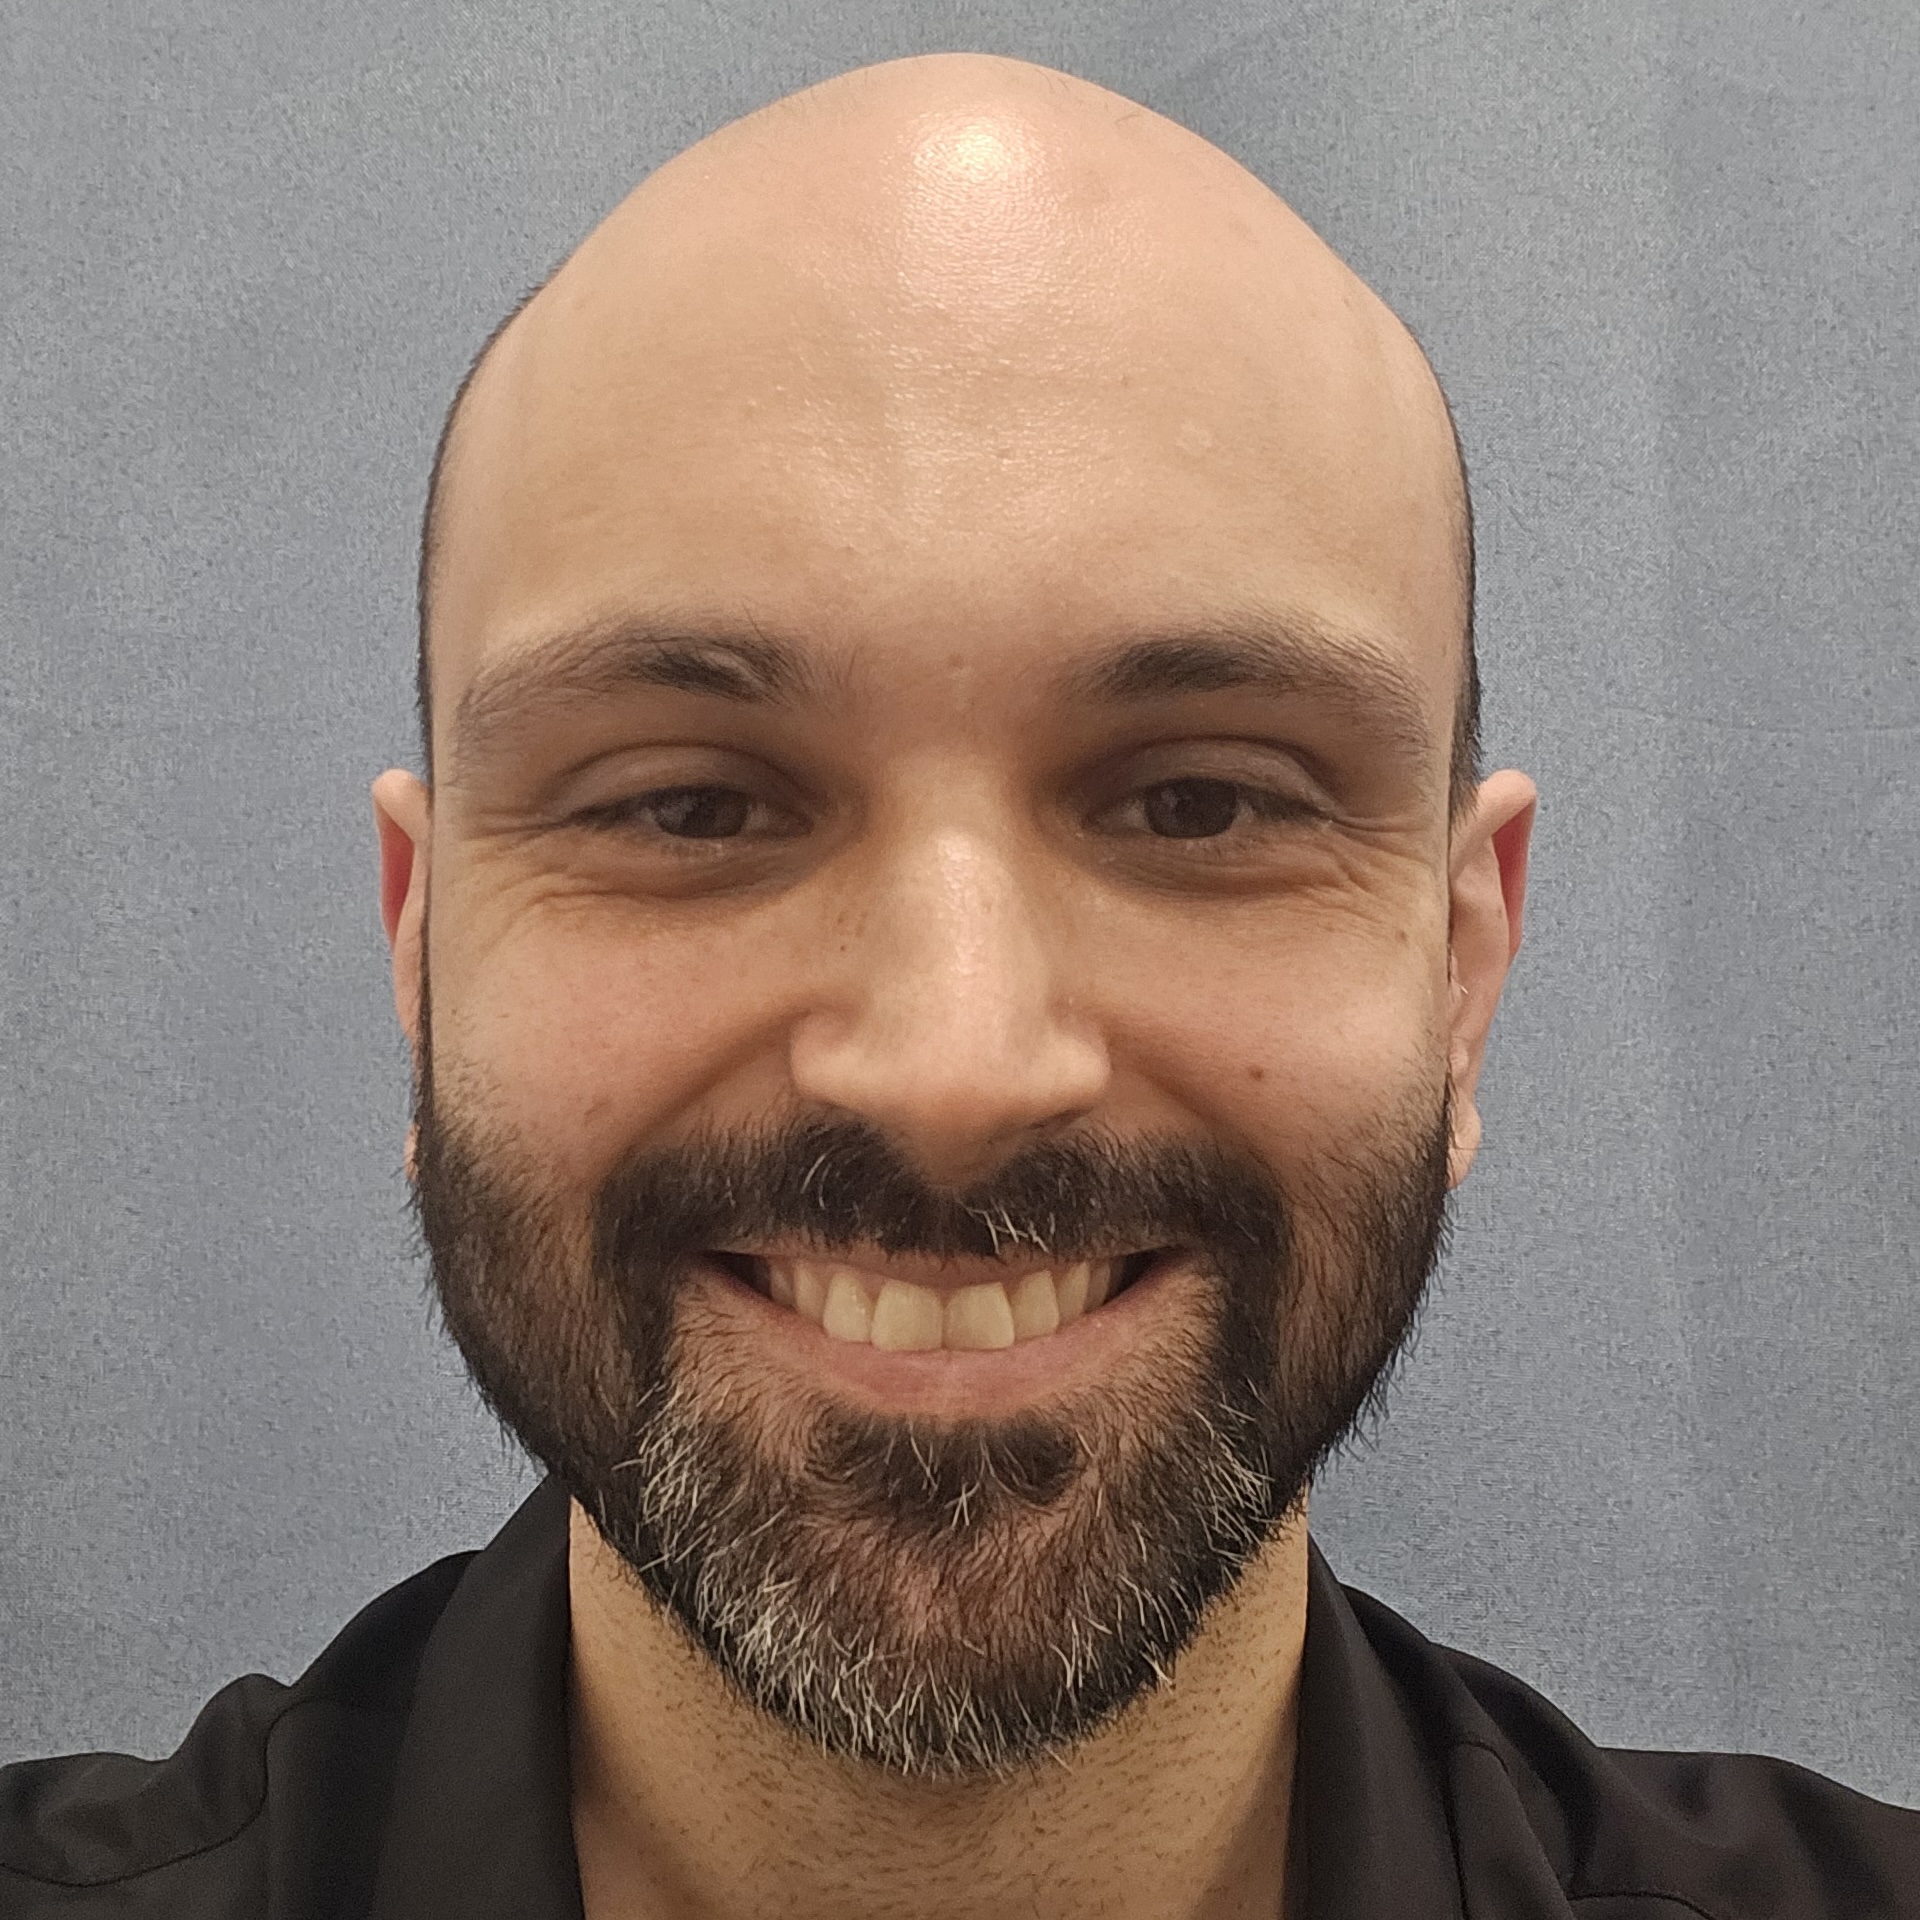 Andrew Critch
機械学習モデルへの代数幾何学の応用を研究し、2013年にカリフォルニア大学バークレー校で数学の博士号を取得。同校のCenter for Human-Compatible AIで5年間研究員を務め、現在も非常勤で在籍している。MAISIに先立ち、AIモデルが互いを監督・修正するプラットフォームtheMultiplicity.aiと、Survival and Flourishing Fundを共同設立した。
- 理事会
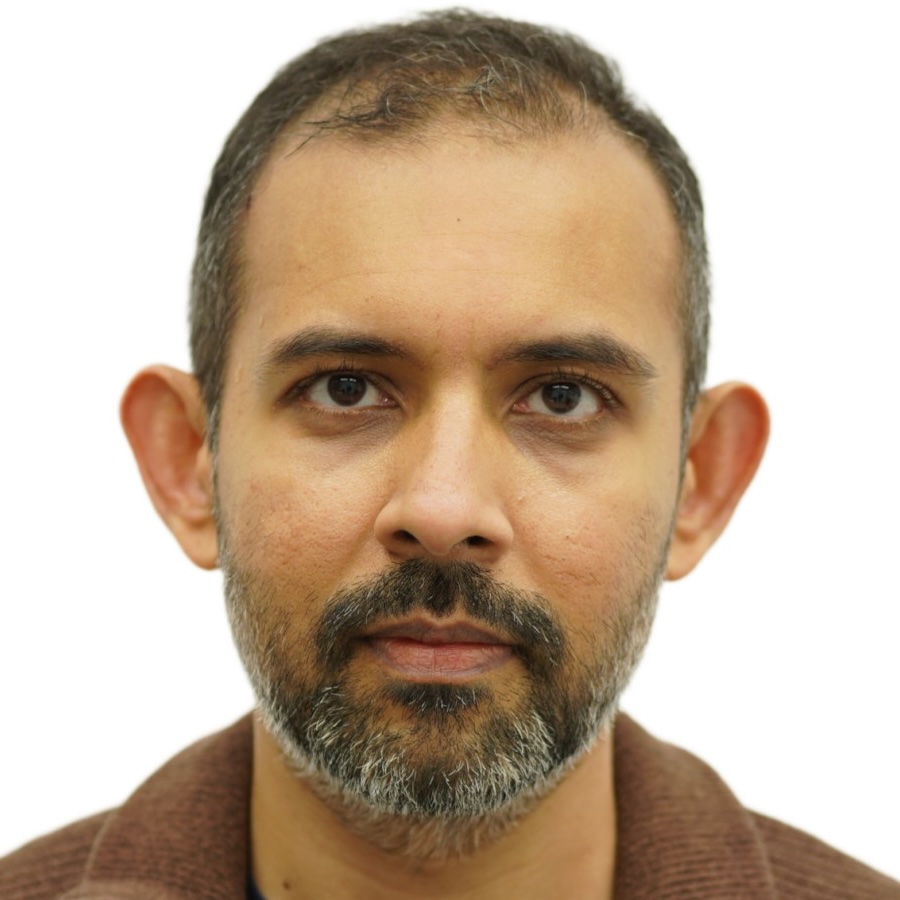 Arul Shankar
トロント大学数学教授。数論的統計学を専門とし、Manjul Bhargavaとの共同研究で、楕円曲線の平均ランクが有限であること、また正の割合の楕円曲線がバーチ・スウィンナートン=ダイアー予想を満たすことを証明した。スローン財団フェローシップおよびサイモンズ・フェローシップの採択歴を持つ。
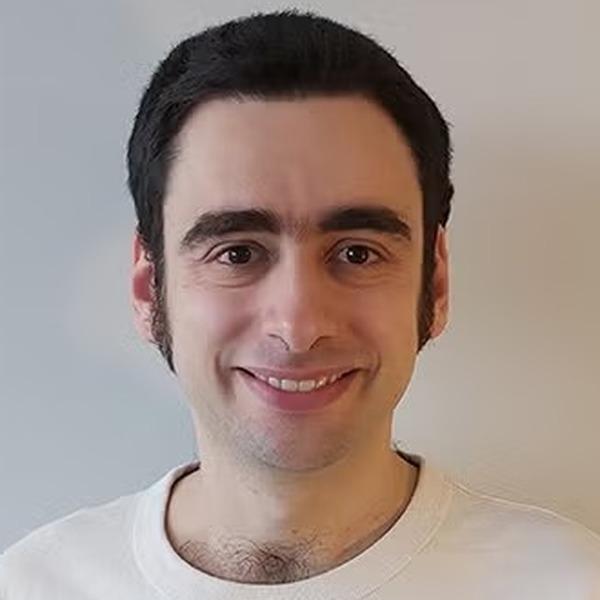 Yevgeny Liokumovich
トロント大学数学准教授。同大学でFields–PrincInt Mathematics for AI Safetyプログラムを率い、Fields Centre for Mathematical AIの運営委員を務める。幾何解析、定量的トポロジー、AIアラインメントの数学的基礎を研究している。Fernando Codá Marques、André Nevesとともにグロモフのワイル則予想を証明し、この業績により2022年アンドレ・アイゼンシュタット賞を受賞した。
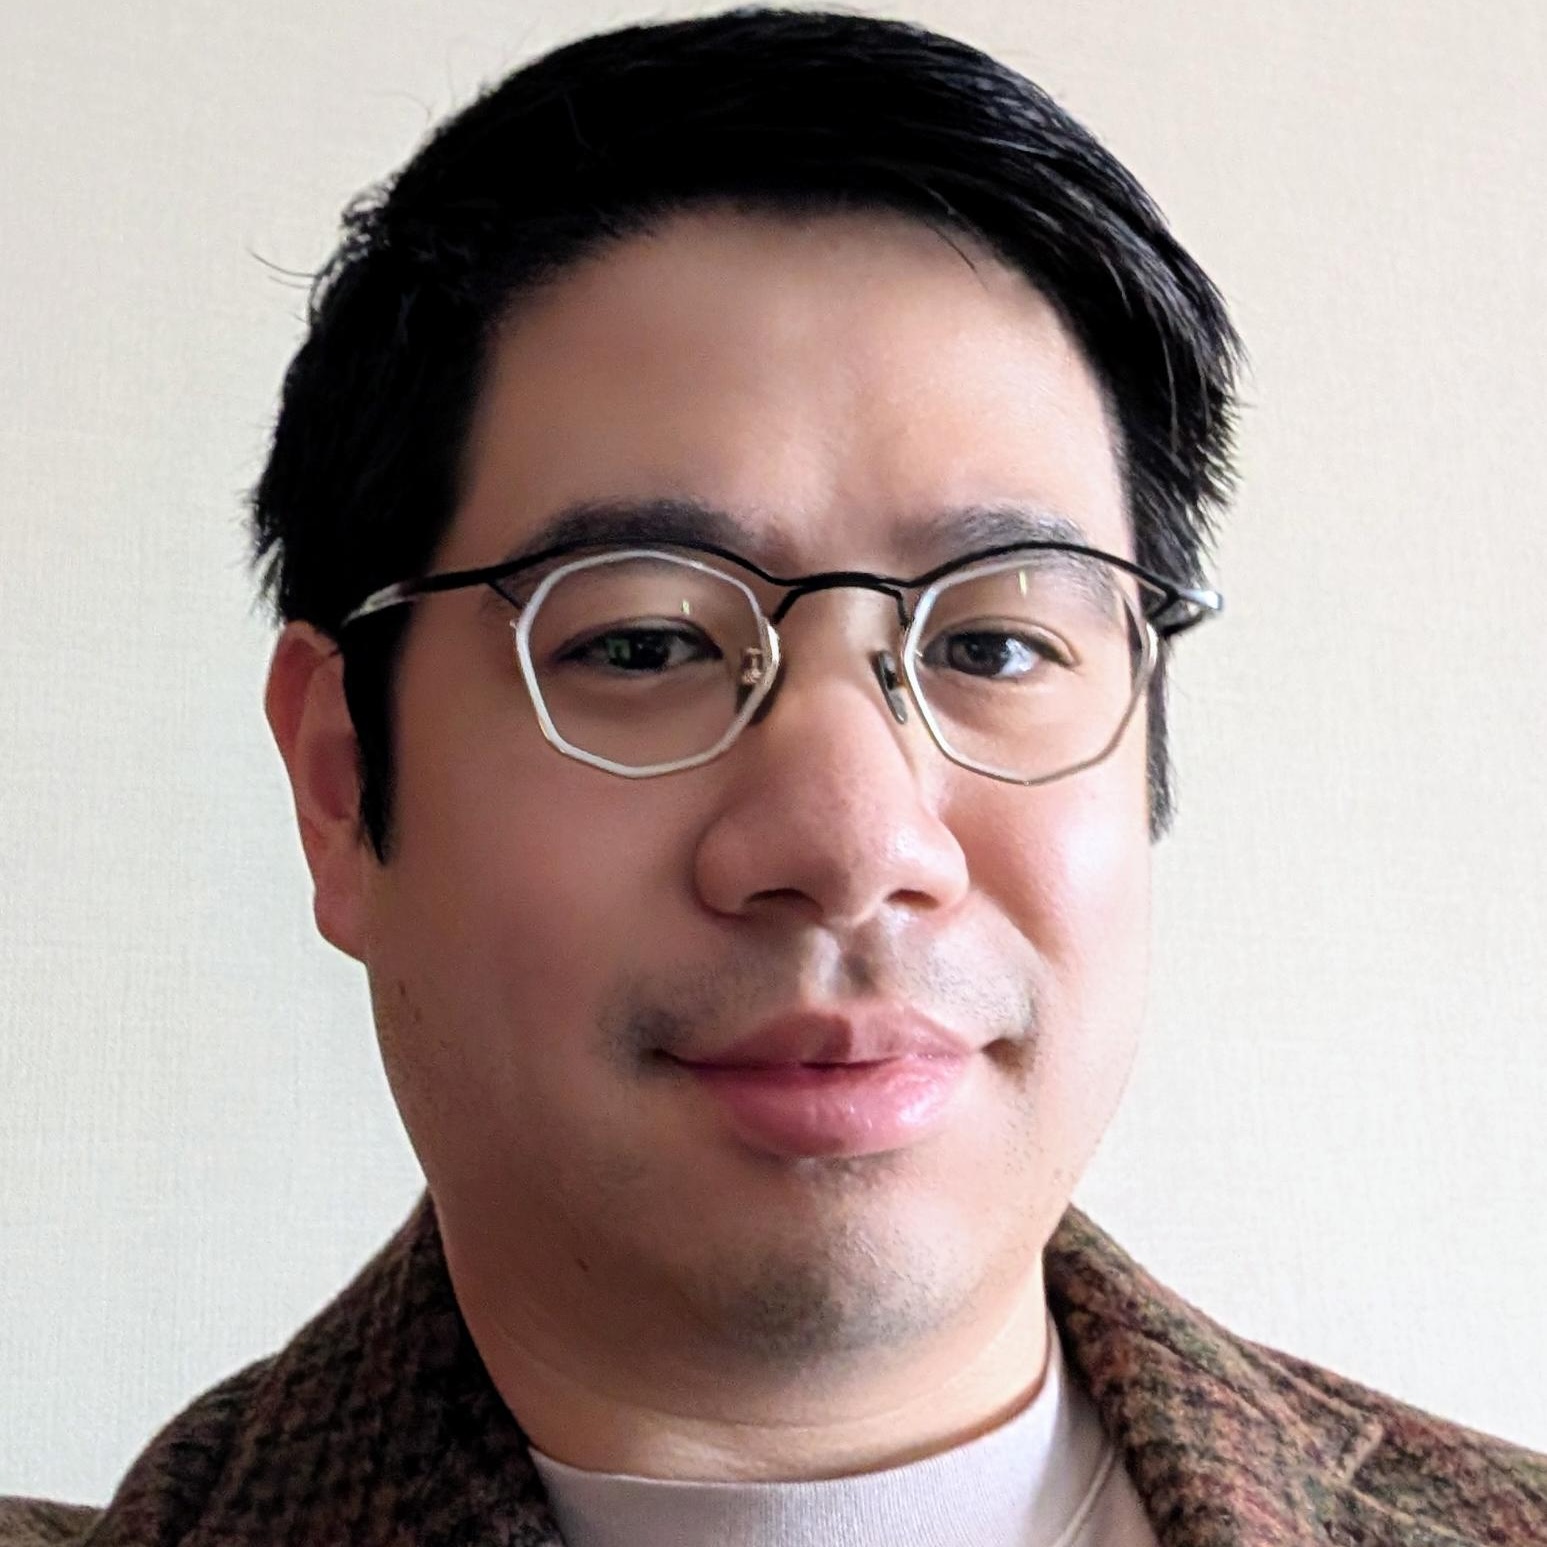 Matthew Chou
ミシサガを拠点に交通インフラと潤滑油の事業を手がけるUnipetro Groupの最高経営責任者。同グループは1989年以来、Petro-Canada Lubricants初の国外販売代理店でもある。東アジアのOEM企業向け潤滑油販売と、同グループの開発事業ポートフォリオを統括する。コロンビア大学とセント・アンドルーズ大学の大学院学位を持ち、以前はAcumen, LLCで医療保険制度改革法(Affordable Care Act)を担当するチームを立ち上げた。
このほか、Jacob TsimermanとAndrew Critch
MAISIへの
参加に応募
ベイエリアへ移住し、できるだけ早くAIセーフティの研究を始める数学者を募集しています。
具体的には、2027年1月開始の学期に10〜30人、2027年9月開始の特別研究年(Special Year)に30〜100人の教員を募集しています。
目標と
戦略
AIセーフティには、もっと多くの数学者が必要である
新しいAI技術が開発・導入されるたびに、ある意味で私たちは、自分たちの未来を賭けてサイコロを振っている。良くも悪くも、AIはすでに世界経済を大きく変えつつある。今日の第一線のAI専門家は、AIを人類絶滅のリスクとさえ見なしている。実際、人類よりも知的で、自力で存続できる人工的な種を私たちが作ることを選べば、それは資源をめぐって私たちと競争し、人類に完全に取って代わることも十分に考えられる。
しかし、リスクは実際にはどのくらい大きいのだろうか。測定し、減らすことはできるのだろうか。専門家や著名人による主観的なリスク評価は数多い。こうした見積もりは、一人ひとりの不安や不確実性を表す重要なものではあるが、人類には、直面するリスクをもっと確かな原理に基づいて測る手段が必要である。強力なAIシステムの安全性がいまだに疑問視される大きな理由は、「安全である」とはどういうことなのかを、理論上でさえ厳密に理解できていない点にある。
そこで、職業数学者の出番である。統計学、物理学、そして計算機科学も、その基盤は数学にある。数学は、妥当な前提から妥当な結論を導くための、精密で堅牢かつ再利用可能な方法を与えてくれる。今、AIセーフティにも同様の数学的基盤が必要である。リスクを測定するためだけでなく、軽減するためにも。
必要であることは、十分であることを意味しない
数学的な洞察も万能薬ではない。規制の枠組み、社会・技術インフラの強化、AIシステム自体をより安全性重視にする訓練手法など、すでに進められているAIセーフティのさまざまな取り組みは、引き続き必要である。リスクは、社会の多様な側面から、さまざまな形で生じうる。したがって、安全性にも多面的なアプローチが求められる。
私たちは、数学的な解決策が他のAIセーフティの取り組みを不要にしてくれると期待しているのではない。より精密で厳密な定義、測定、解概念によって、それらの取り組みを強化したいのである。原子力科学や疫学のリスクを測り、論じ、回避するために、物理学や統計学で数学を使っているのと同じように。
中心となる問い
どのような前提があれば、新しいAI技術が大惨事を引き起こさないと、高い確信を持って導けるだろうか。
AIセーフティの問題を数学的に定式化する試みは、これまでにもさまざまに行われてきた。少しずつ進展はあったが、AIによる人類絶滅規模のリスク、すなわちAIによる人類存続リスク(AI x-risk)の問題は、いまだに解決されていない。
こうした問いに対する、数学的原理に基づく答えは、まだ発見を待っている。私たちはこれまで、世界の数学界の相当な割合を占める人々の力を結集して、AIセーフティに取り組むことすらしてこなかった。MAISIは、その状況を変えたいと考えている。物理学者が原子炉の安全性を確保するために使う数学や、統計学者がパンデミックを追跡するために使う数学に比肩する、新しいAI技術が人類の存続を脅かさないことについての、数学的原理に基づく説明が人類には必要である。
とはいえ、私たちが今日直面するAIによる人類存続リスクの核心的な問題は、難しさが証明される、あるいは別の理由で扱いきれない問題だと判明するかもしれない。そのため、見いだす答えは否定的なものになる可能性もある。考えられる例をいくつか挙げよう。
- 現在のAI開発のパラダイムでは、人類の存続を脅かさないようにすることが不可能であり、何らかの大きなパラダイム転換が必要なのかもしれない。
- 現在の、あるいは別のAIのパラダイムで、人類の存続を脅かさずにAIを構築・利用することは可能かもしれない。しかし、適切な構成を実現する過程が、現時点では対処できないほどカオス的でノイズに敏感であることが、証明されるかもしれない。
- 現在の、あるいは別のAIのパラダイムで、人類の存続を脅かさずにAIを構築・利用することは可能かもしれない。しかし、その事実を検証する課題が、高い計算複雑性のクラスに属すると証明されるかもしれない。
こうした障害のいずれかが存在するなら、私たちはそれを知りたいし、その知識を追求する数学界を支援したい。実際、数学は、ある基礎のもとでは自らの問題の一つが解けないことを証明できる、数少ない学問の一つである。とりわけ、あるAI技術を何らかの理由で決して安全にできないのであれば、手遅れになる前に、その不可能性の数学的な説明を明らかにできるかもしれない。
MAISIの
仕組み
MAISIは何よりもまず、プリンストンの高等研究所やトロントのFields Instituteに似た、数学の研究所として活動する。数学者は、1学期または2学期を単位として研究員(Members)となり、在籍期間を更新できる場合もある。交流してアイデアを共有する共用空間を囲むように研究室を設け、所内発表や招待講演のためのセミナー室も用意する。
大まかに言えば、次の2種類の対話を促していく。
一つ目は、実績のある数学者同士がAIセーフティの問題について議論し、この分野の既存文献や問題に親しむことである。こうした対話の場では、数学界が培ってきた知恵と慣行が、最も色濃く表れるだろう。
二つ目は、AIセーフティで実績のある専門家が、数学者を対象に、この分野の既存の解決策や未解決問題を紹介することである。こうした対話は、理論を実践に結びつけ、新しい共同研究の種をまき、研究所のメンバーがAIセーフティ分野の提携機関と協働したり、そこに滞在して研究したりすることを後押しする。
研究所の形が整うにつれて、AIセーフティ研究の新しい方向性や視点が急速に生まれると期待している。研究者には、こうした安全性へのアプローチをできるだけ早く共有するよう奨励する。通常の学術的な数学研究では、成果を丹念に論文へと練り上げ、数年をかけて公表する。MAISIはそれよりもはるかに速く動き、AIセーフティという分野の役に立ちうる最も早い段階で、アイデアを共有することを目指す。特に、発展途上の安全性のアイデアを記した、随時更新される文書は、数学の学術誌に適した完成形になるはるか前から共有する。
お問い合わせ
報道関係のお問い合わせは[email protected]へ、それ以外のお問い合わせは[email protected]へお寄せください。研究所の拡大に伴い、分野別のメールアドレスを追加する場合があります。
研究
数学者に向けて解説した、数学的に豊かなAIセーフティの問題を紹介している。順次拡充している研究の方向性の一覧を見てほしい。
研究の方向性を見る