
本稿は機械知能研究所(Machine Intelligence Research Institute, MIRI)の単著者シリーズ(Single Author Series)の一編である。このシリーズの記事は、記名された著者の信念と意見を表すものであり、MIRI全体を代表するとは主張しない。
機械学習革命によってAIの進展が一気に加速する前、私はExxonMobilで、信頼性工学とリスク評価に携わっていた。AI開発全般、とりわけ現代の機械学習がもたらす問題を理解しようとするとき、以前の分野の概念を利用するのが役立つことがある。
信頼性工学は、設備故障によるリスクの長期的な管理を扱う。統計、事故・ヒヤリハット調査、故障分析、確率論的リスク評価、長期保全計画を組み合わせるもので、第二次世界大戦後から工業生産の中核を成してきた。
信頼性工学は安全工学と密接に結びついており、二つの分野はいくつもの重要概念を共有している。本稿では、そのうちいくつかを概説し、人工知能に対する私の見方とどう関係するかを論じる。
私は石油精製・化学を専門としていたため、例の多くは石油・ガス産業から取る。それでも、この一業界の外にも十分一般化できる教訓へ重点を置くつもりである。最初に取り上げるのは確率論的リスク評価であり、製造業、原子力規制、宇宙飛行、国防などの分野で広く使われている。
確率、影響、リスクマトリクス
リスクを定量化し、分類するという考え方は、信頼性工学の中心にある。
リスクには、確率と影響という二つの要素がある。
確率とは、ある特定の結果が起きると推定される可能性である。数百、数千のリスクを扱うときは、比較しやすくするため、確率を桁単位で丸めることが多い。10分の1、100分の1、1,000分の1などである。
影響とは、その特定の結果がどれほど悪いかである。高額な操業停止や修理など、一部の影響は金額で測る。47 負傷や死亡など、ほかの影響は、いくつかの定性的な区分の一つへ単純に入れる。たとえば負傷なら、応急処置、入院、長期障害、死亡のいずれかに分類するかもしれない。金額で測る影響も、頭の中で分類しやすくするため、通常は同じように扱う。
私たちは、リスクの集まりをリスクマトリクスを使って分類し、視覚的に整理することが多い。
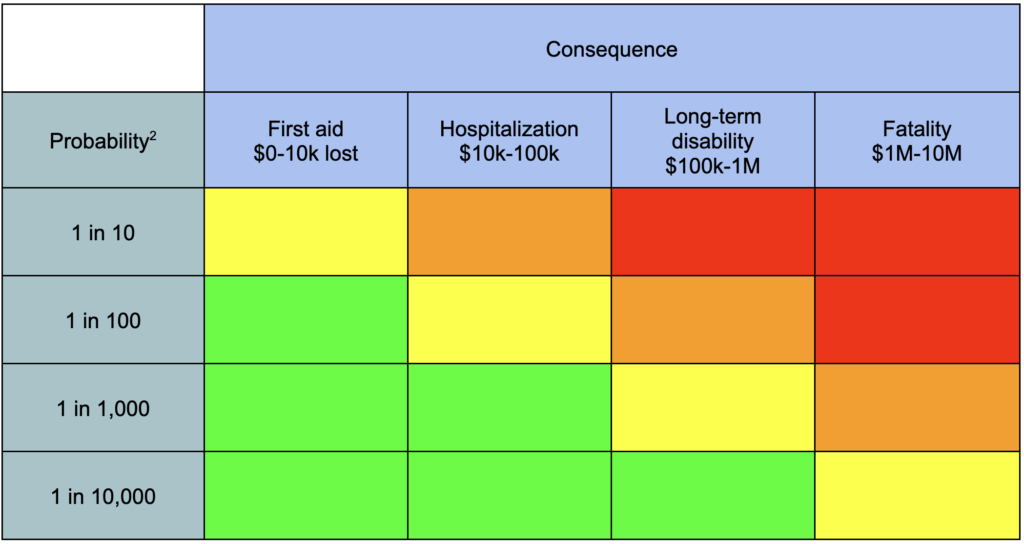
リスク評価に携わったことのある人の大半は、何らかのリスクマトリクスを見たことがあるだろう。財務リスクは、期待損失、すなわち事象にかかる金額に、その発生確率の推定値を掛けたものとしても表せる。安全リスクは通常このように扱わないが、区分には入れる。そして企業が、あるリスク区分に支出する意思のある金額に上限を設けることもある。
また、リスク評価を行うなら、通常は1年という、特定の時間間隔を定義する。「年率換算した」リスクを使うと、確率の推定値を限られた一貫した範囲に保ちやすい。
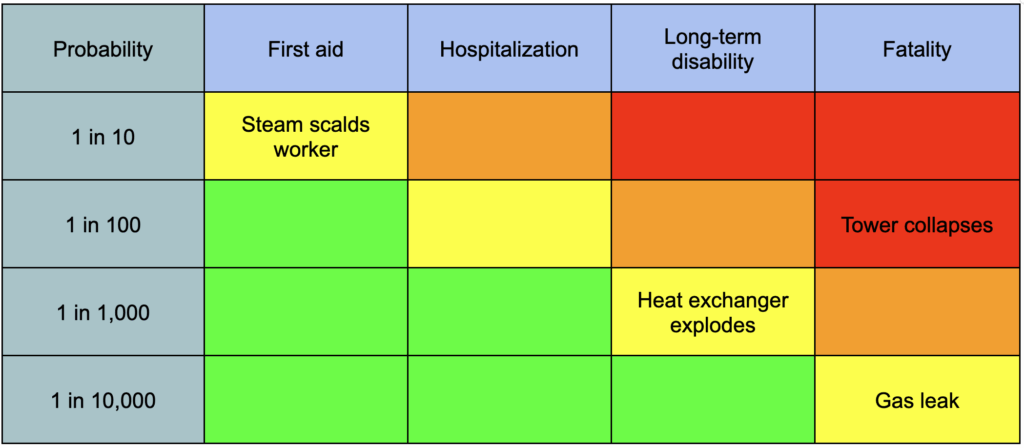
リスクマトリクスに載りうる安全リスクの例を、いくつか挙げる。49
- バルブを開けると蒸気が噴き出し、作業員がやけどする(推定10分の1)
- 老朽化した塔が倒壊し、近くの人が死亡する(100分の1)
- 熱交換器が過圧になって爆発し、人が重い後遺障害を負う(1,000分の1)
- 有毒ガスが漏れ、運転員が中毒になる(10,000分の1)
これらをリスクマトリクスへ置くと、次のようになる。
これを大規模に、さらに効果的・効率的・堅牢に行う方法を考えることは、安全技術者・信頼性技術者の主な仕事の一つである。財務リスクでは、便益対費用比の高い対策を見つけることへ重点を置く。安全リスクでは、特に高いリスクを許容水準まで軽減することへ重点を置く。
1兆ドル級の問いは、どの水準のリスクなら許容できるのか、である。
答えは産業によって異なる。私が最もよく知る石油・ガス産業では、適切に運営されている米国企業の大半が、上図の赤またはオレンジの領域にあるリスクを許容できないと考えるだろう。オレンジ領域のリスクは、軽減策を計画・実施する間、一定期間許容されるかもしれないが、注意深く監視される。赤領域のリスクは、一時的にさえ軽減できなければ、工場全体の操業停止を引き起こしうる。50
日常的に許容される単一原因の年間リスクで最も高いものは、(非常に大まかに言えば)1人が死亡する確率10,000分の1に相当する。妥当性をざっと確認すると、これは平均的な米国人が自動車事故で死亡する年間リスクとおよそ同じである。妥当な一次近似では、朝、車で通勤するなら、適切に運営されている製油所の作業員と同程度のリスクを受け入れている。51
これらの数字は非常に大まかなものだが、先進国社会が受け入れる意思のある、一般的なリスク許容水準を示唆してはいる。
人が意図的に、はるかに高いリスクを受け入れることもある。たとえば有人宇宙飛行は、数十年の工学経験と、安全性への数十億ドルの取り組みがあっても、極めて危険である。NASAが許容できるとするリスクの閾値は、1回のミッションで乗員が死亡する270分の1の確率である。それでも有人打ち上げの実際の失敗率は1%に近い。関係者全員がリスクを認識し、自分たちの仕事にはそれだけの価値があると判断している。
もう少しで、こうした教訓の一部を人工知能へ移せる。しかしその前に、起こりうる被害がさらに大きいとき、各産業がリスク評価をどう扱うかを理解する必要がある。
施設内で1人が死亡する確率10,000分の1を受け入れることと、同じ確率で近隣都市を有毒物質で汚染することを受け入れるのは、まったく違う。評価者は時に、数十、数百、さらには数千人の死亡、または同じく甚大な被害を生じうるシナリオを検討したいと考える。その場合、通常は長く詳細な評価を実施し、その結果として、予防・軽減策を多重の防護層として設け、その結果を拡張リスク マトリクスへ載せる。
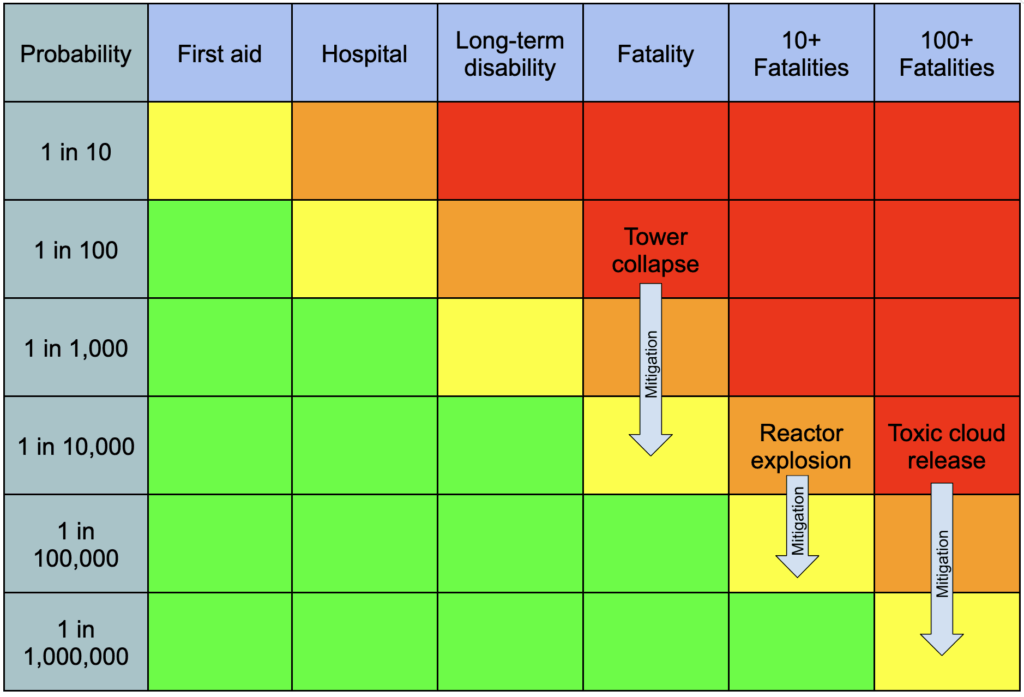
成熟した産業は、事業が破局的な結果をもたらしうるなら、それに応じて、予防へ並外れた取り組みが必要だと認識している。必要な確信度で安全を保証できない事業には、そもそも着手しない。
AIとリスク評価
AIはおそらく、世界の終わりにつながる可能性が最も高いだろう。しかし、それまでの間にすばらしい企業が生まれる。――サム・アルトマン(Sam Altman)
機械学習は成熟した産業ではない。
ニューラルネットワークは1950年代から存在するが、人間より賢い機械を目指す数十億ドル規模の取り組みの中核となり始めたのは、ごく最近である。ChatGPT以前、機械学習は堅牢なリスク評価を特に必要としなかった。作れるAIは、新しい病原体を設計したり、人間の戦略的推論に匹敵したりするほど高度ではなく、意味のある脅威にならなかったからだ。
しかし時代は変わりつつあり、これがいつまで当てはまり続けるかは明らかでない。
AI能力研究の分野には、この変化への備えがない。「責任あるスケーリング枠組み」の最初の試みは、わずか2年前のものである。現在の版も、なお著しく不十分であり、フロンティアAIラボのリスク管理手法を採点する予備的な試みでは、例外なく不足があるとされている。
確かに、評価するのが並外れて難しい分野である。安全・信頼性技術者は通常、破局の確率を推定するのに使える、数年、時には数十年にわたる履歴データと、工業過程の詳細な因果モデルを持つ。フロンティアAIラボが持つのは、ベンチマークである。
次世代AIの能力を測る試験を作るだけでも、第三者評価者からなる生態系全体が必要となる。その能力を開発前に予測することは、ほとんど不可能である。よりよい手法を利用できるようにする取り組みが進んでいるが、短期的な化学・生物・放射性物質・核(CBRN)リスクについてさえ、評価者は前例のない課題へ直面している。
人間より賢いAIの長期的影響となると、従来のリスク評価手法はほぼ役に立たない。それでも、AIを考えるための直観を引き出す道具として、信頼性工学の概念がいくつか役立つと感じている。
潜在故障と顕在故障
たとえば信頼性工学は、顕在故障と潜在故障を区別する。
顕在故障は、通常の運転過程で運用者に明らかになる。運転中にタイヤがパンクすれば、その事実に長く気づかないままではいない。石油・ガス産業では、大規模な漏洩や、ポンプ・圧縮機の停止は通常、顕在故障である。
潜在故障は、通常の運転過程では明らかにならない。予備タイヤがパンクしても、必要になるまで気づかないかもしれない。製油所では、めったに使わないバルブが開いたまま固着しても、誰かが緊急に閉める必要に迫られるまで、明らかな問題ではない。そのときには、大きな問題となりうる。
潜在故障が恐ろしいのは、ほかの問題を悪化させるからである。故障が潜在するのは、多くの場合、故障したものを毎日は必要としないためだ。緊急時にしか必要としないものであることも多い。そのため多くの場合、すべてが正常に見える……緊急事態が起きるまでは。そこで、故障した炉への燃料供給を止めるはずのバルブが閉まらず、本来なら高額な操業停止で済んだものが、死者を伴う大火災となる。
顕在故障も危険になりうる。巨大な火球は明らかだろうが、だから安全になるわけではない。しかし顕在故障は、少なくとも訂正可能(corrigible)である傾向がある。運用者へフィードバックを与え、運用者は問題を調査して修正できる。顕在故障が完全に破局的なものでない限り、通常は適時に修正できる。
この区別をAIへ当てはめると、どうなるだろうか。
AIの訓練には、望ましくない行動を測る不完全な尺度がいくつかある。たとえばハニーポット試験では、AIが訓練者を欺く誘因を持ちうる模擬環境へ、AIを置く。AIが餌に食いつき、欺瞞的に行動すれば、訓練者はそのAIについて重要なことを学んだことになる。同様の試験によって、試験の抜け穴を突いたり、別のサーバーへ自分をコピーしたりする能力・傾向が明らかになる場合もある。
AI訓練の分野へ入ったばかりで、勾配降下法の基礎を学んだ人なら、そのような試験に合格する傾向を最適化することで、こうしたことをしないようAIを訓練する、という発想に行き着くかもしれない。しかしこれは、そのような試験の抜け穴を突く傾向と、欺瞞が上達する傾向も最適化する。それが最も禁じられた手法と呼ばれてきたのには、十分な理由がある。
AI分野は、モデルに悪い行動を隠すよう訓練する方法を発明し、時には使っている。さらにAIは、欺瞞が自らの目標に役立ちうると理解できるほど賢くなり始めている。言い換えれば、顕在故障を潜在故障へ変換するよう働く力が存在する。
私の中の技術者は、この事実にかなりぞっとする。
AI研究をリスクマトリクスへ載せる
AIとリスク評価という一般的な問いへ戻ろう。AIリスクは、リスクマトリクスのどこに置かれるだろうか。
信頼性技術者は、多くの技術者と同じく、「起こりうる最悪のことは何か」と自問する習慣がある。もっと形式的に言えば、影響が最も大きい現実に起こりうるシナリオを探している。石油・ガス産業では、「反応器が爆発する」は現実に起こりうるシナリオと考えるが、「隕石が工場に落ちる」はそう考えない。
高度な人工知能が人類絶滅を起こしうることは、広く認められている。これを、影響が最大の、現実に起こりうるシナリオとして扱う。52
では、その確率はどうだろうか。
残念ながら――あるいは幸いにも――この問題について、履歴データと呼べるものはほとんどない。技術者が「人類が超知能機械を作った過去10例のうち9例では、結果は……」と言うことはできない。
人類自体がAIによって滅ぼされうるという見方は、主に、知的な心の性質と予想される行動についての論拠にかかっている。そうした論拠をどの程度受け入れるかは人によって異なる。そのため、超知能AIによる人類絶滅確率の推定値は……多様である。
ちなみに私は、この結果が起きる確率は極めて高いと考えている。しかし、そう考えない人もいる。この作業に正確な数字は必要ない。リスクを、大まかに正しい区分へ置こうとしているだけだからだ。そこで今は論拠を省き、人工知能専門家を対象とする2023年の調査の中央値、5~10%を使うことにする。53
(もっと大きなリスクマトリクスが必要になる。)
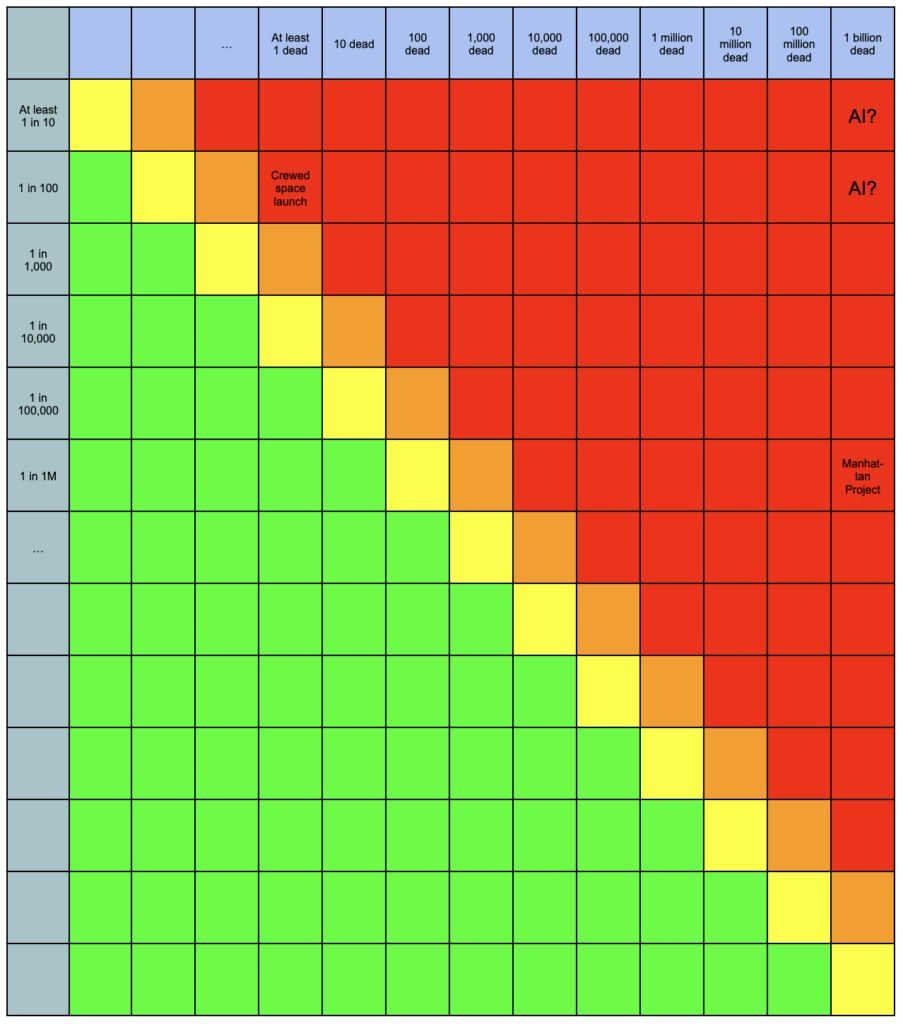
もちろん、このような比較を額面どおり受け取るべきでない理由はいくつもある。第一に、これは特定のプロジェクトの年間リスクとは限らず、分野全体の総リスクを見ている。第二に、アライメントされたAIがもたらす、リスクに見合う利益を考慮していない。また、AIによって生活が向上する、または誕生の機会を奪われる可能性のある未来の人々も考慮していない。
それでも、何が懸かっているかの途方もない規模を、身が引き締まる思いで再認識させる。破局の確率を数桁下げる、いくらか疑わしい仮定を置いたとしても、マンハッタン計画の時代以来、おそらく何者も占めてこなかったリスク空間の領域に、なお位置するだろう。If Anyone Builds It, Everyone Diesのオンライン資料には、こうある。
何らかの発明が文字どおり全員を殺すかもしれないと、科学者が深刻な懸念を表明した、私たちが知る歴史上唯一の出来事は、マンハッタン計画中に起きた。一部の科学者は、核爆弾があまりに高温になり、大気中の窒素の核融合を始め、大気をプラズマに変え、地球上の全生命を殺すのではないかと懸念した。幸い、科学者たちは関係する物理法則をよく理解しており、計算を行うことができた。計算を行う前、科学者の一人アーサー・コンプトン(Arthur Compton)は、大気に着火する確率が100万分の3より少しでも高ければ、計画を離れると決めた。自分の手ですべての空気をプラズマに変える確率100万分の3でさえ冒すより、ナチスが連合国より先に爆弾を作るリスクを冒す方がよいと、彼は考えた。
これは5%より、およそ4桁低い。
主要AIラボの長のうち複数は、自ら、100万分の3をはるかに、はるかに上回る確率を公に述べ、または示唆している。それでも彼らは規模を拡大し続ける。AI分野は、直面する不確実性を、アーサー・コンプトンよりはるかに無謀に扱っているように見える。
工業生産は利他主義にあふれた分野として知られてはいないが、成熟した産業でこの規模のリスクが真剣に示されれば、直ちに緊急の操業停止を促すだろう。利用できる最も経験豊かな上級専門家が、破局の確率を、はるかに、はるかに低い推定値へ収束させるまで、たゆまず問題へ取り組むだろう。結論を支える中核的な前提を立てて擁護する、堅牢で徹底した安全性ケース(安全だとする根拠一式)を作成し、改訂するだろう。
以前の職場でこのリスク評価を行っていたなら、私たちはすでに、「停止し、溶け、炎上する」段階を大幅に過ぎていると言うだろう。
予防と軽減
AIの長期的な利益がリスクを上回ると考える人にとっても、赤領域から抜け出す方法、少なくとも絶滅確率を下げる方法を考えることには価値がある。
特化型AI(narrow AI)によって生じる問題――経済的混乱、CBRN関連能力の増幅、AIスロップの生成など――は軽減を試みることができるし、そうすべきである。しかし敵対的な超知能を軽減することは、まったく別の問題である。私は、おおむねできないと考えている。誕生したばかりのAIの内部を研究する間、世界と相互作用する能力を大幅に制限するのは、もちろん賢明だろう。しかし、それは現在行われているように見えず、リスクを数桁も下げるとは思えない。
残るのは予防である。敵対的な超知能による絶滅を避ける最良の機会は、それを作らず、同じように、敵対的な超知能へ成長するかもしれない自己改変AIも作らないことである。
そのための一つの方法は、認知の基礎科学を解明し、ある人工的な心がどう行動するかを予測し、その動機を直接変えられるようにすることだ。この技術的能力を明確に実証すれば、AI能力をスケールさせようとする者が実際にその能力を使うと仮定して、リスクを1、2桁(order of magnitude, OOM)下げる価値があるかもしれない。残念ながら、今後数年で関連科学を習得する軌道に、人類は乗っていないように見える。
したがって実際には、敵対的な超知能を予防するとは、人類が安全に作るための集合的な専門能力を築くまで、超知能を一切作らないことを意味する。この点について国際協定を確保する取り組みは、リスク評価者である私の目には、利用できる中で最も費用対効果の高い選択肢に見える。
残余リスク
復習すると、成熟した産業では、利害関係者や意思決定者と、いくつかの重要情報を共有するのが一般的である。
- 未軽減リスクまたは固有リスク。何もしないデフォルトの場合に悪い結果が起きる、推定確率と影響に相当する。
- 個別に、または組み合わせてリスクを下げる、提案された対策または一連の対策。
- 軽減後リスクまたは残余リスク。こうした対策案を考慮した後の推定リスクに相当する。
最初の二つ、固有リスク(並外れて高い)と、提案した対策の一部(AI認知を研究する、フロンティアAI開発を止める)を扱った。次に当然浮かぶ問いは、これらの対策によってリスクをどの程度下げられるのか、である。
技術者と管理者は、リスクを完全に除くことは不可能だと知っている。しかし、さまざまな資源を使ってリスクを下げることはできる。残余リスクとは、それを行った後に残るものである。残余リスクは極めて重要だ。最終的に、どれほどのリスクを抱えるかを教えるからである。固有リスクと残余リスクの差も重要だ。対策からどれほどの価値を得ているか(少なくとも、どれほど得ていると考えるか)を教えるからである。
大規模な製油所における、(著しく単純化した)年間予算計画は、次のようになるかもしれない。54

同じ考え方をAIリスクへ当てはめると、超知能の国際的な禁止によってリスクを1、2桁、アライメント研究への大規模投資によってさらに1桁、非常に大まかに下げられると予想する。それでも、絶滅確率100万分の3というアーサー・コンプトンの基準には届かず、正直なところ、そこまで到達できるとは思わない。それでも現在の状況よりは別世界のようによい。
では、主要AIラボはどうだろうか。人類に代わって、どれほどの残余リスクを受け入れていると考えているのだろうか。
それは……分からない。私の知る限り、主要AIラボはどこも、自らの活動がもたらす残余リスクの具体的な推定と、少しでも似たものを公表していない。
さて、ほとんどの企業は、内部のリスク推定値を公には共有しない。数字が何を示していても、悪い報道になるだろう。しかし、企業が文字どおり地球上の全員の命を賭けながら、自社の責任あるスケーリング計画によってリスクを許容できるほど下げられると主張するなら……その企業が暗黙にどの程度の残余リスクを受け入れていると考えるのか、何を根拠にそこまで確信しているのかを説明するよう、こちらも要求するのは妥当だと思う。