
現実世界の何らかの目標を達成するロボットを作りたいとしよう。その目標を達成するには、ロボット自身が学び、あなたもまだ知らない多くのことを解明しなければならない。((これは、アブラム・デムスキー(Abram Demski)とスコット・ギャラブラント(Scott Garrabrant)による「埋め込み型エージェンシー」シリーズの第1部である。))
ここには複雑な工学上の問題がある。しかし、そもそもそのような学習エージェントを作るとはどういう意味なのか、という問題もある。物理環境の中で現実的な目標を最適化するとは、どういうことなのか。大まかに言えば、それはどのように機能するのか。
この一連の記事では、現在の私たちがその仕組みを理解できていない四つの側面と、解明を目指して活発に研究されている四つの領域を示す。
こちらはアレクセイ(Alexei)。アレクセイはビデオゲームをしている。
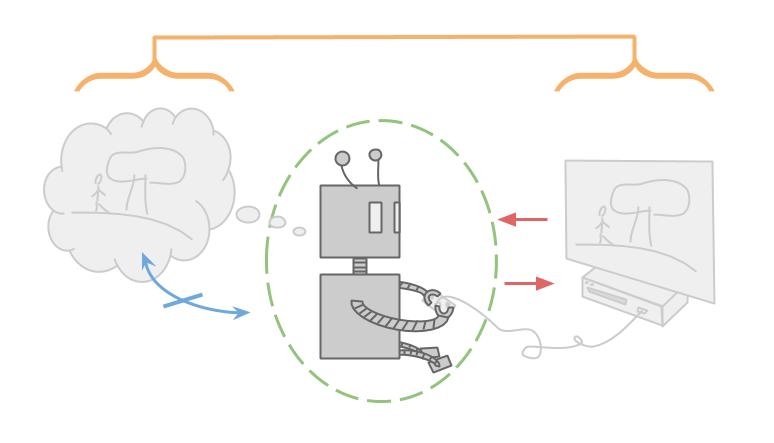
ほとんどのゲームと同じく、このゲームには 【トピック:意思決定理論】 明確な入力経路と出力経路がある。アレクセイはコンピューター画面を通してのみゲームを観察し、コントローラーを通してのみゲームを操作する。
ゲームは、ボタン操作の列を入力として受け取り、画面上のピクセルの列を出力する関数だと考えられる。
アレクセイは非常に賢く、 【トピック:埋め込み型世界モデル】 ビデオゲーム全体を心の中に保持できる。アレクセイに不確実なことがあるとすれば、それは自分がどのゲームをしているかという経験的事実だけであり、(ある決定論的ゲームで)どの入力がどの出力を生むかという論理的事実ではない。したがってアレクセイは、自分が遊んでいる可能性のある、あらゆるゲームも心の中に保存しなければならない。
しかしアレクセイは、 【トピック:頑健な委任】 自分自身について考える必要はない。最適化しているのは自分が遊んでいるゲームだけであり、そのゲームを考えるために使う脳ではない。情報の価値に基づいて行動を選ぶことはあるかもしれないが、それは自分が遊んでいる可能性のあるゲームを除外するためだけであり、自分の考え方を変えるためではない。
実際、アレクセイは自分自身を、 【トピック:サブシステム・アライメント】 変化しない不可分の原子として扱える。自分が考察する環境の中に存在しないため、時間とともに自分が変化するかもしれないことや、実行する必要のあるサブルーチンについて心配しない。
ここまで述べた性質はどれも、アレクセイが最適化する環境から明確に切り離されているからこそ、ある程度可能になっていることに注目してほしい。
こちらはエミー(Emmy)。エミーは現実そのものを生きている。
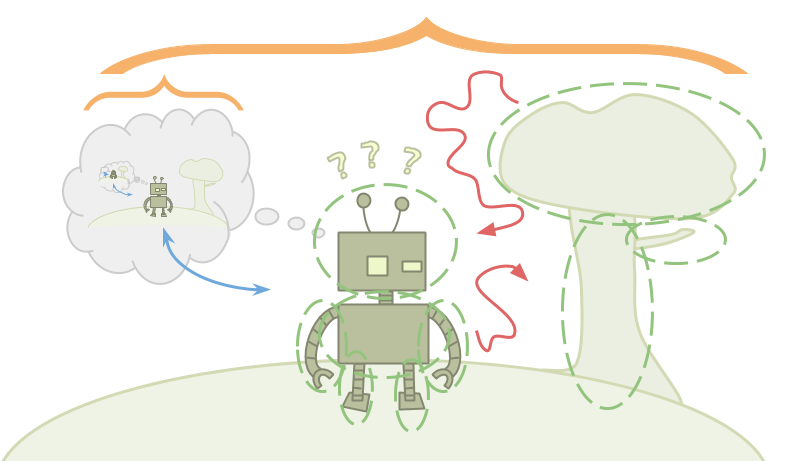
現実はビデオゲームとは違う。その違いの大部分は、エミーが自分の最適化しようとする環境の内側にいることから生じる。
アレクセイは宇宙を関数とみなし、その関数へ与えられる入力の中から、ほかの入力より大きな報酬につながるものを選んで最適化する。一方、エミーには 【トピック:意思決定理論】 関数がない。ただ環境があり、その環境はエミー自身を含んでいる。
エミーは可能な限り最善の行動を選びたいが、エミーがどの行動を取るかも、環境についての一つの事実にすぎない。エミーは環境のうち自分の決定にあたる部分について推論できる。しかし最終的に実際に取る行動は一つしかないため、ほかより優れた行動をエミーが「選ぶ」とは、そもそもどういうことなのか明らかでない。
アレクセイは宇宙をつつき、何が起きるかを観察できる。エミーの場合は、宇宙が自分自身をつついている。エミーの場合、そもそも「選ぶ」という考えをどう形式化すればよいのだろうか。
さらに悪いことに、エミーは環境に含まれているので、 【トピック:埋め込み型世界モデル】 環境より小さくなければならない。したがって、環境について正確で詳細なモデルを心の中に保存することはできない。
これが問題を生む。ベイズ推論では、可能性のある環境を多数集めたところから始め、そのうちいくつかと矛盾する事実を観察するたびに、それらを除外する。世界の仕組みを表す妥当な仮説を一つさえ保存できないとき、推論はどのようなものになるのだろうか。エミーは別の種類の推論を使い、標準的なベイズの枠組みに収まらない更新を行わなければならない。
エミーは、自分が操作する環境の内側にいるため、 【トピック:頑健な委任】 自己改善もできる。しかし学びを増し、自分を改善する方法を次々と見つける中で、本当に役立つ方法でしか自分を変えないと、どう確信できるだろうか。元の目標を望ましくない形で変更しないと、どう確信できるだろうか。
最後に、エミーは環境に含まれているので、自分を原子のようには扱えない。 【トピック:サブシステム・アライメント】 環境の残りの部分と同じ構成要素からできているからこそ、自分自身について考えられる。
エミーは外部環境の危険だけでなく、内部から来る脅威も心配しなければならない。最適化を行う際、意図的または意図せず、別の最適化主体をサブルーチンとして起動するかもしれない。そのサブシステムが強力になりすぎ、エミーの目標にアライメントされていなければ、問題を起こしうる。知的なサブシステムを起動せずに推論する方法を見つけるか、さもなければ、それらを弱いままにするか、封じ込めるか、自分の目標に完全にアライメントさせる方法を見つけなければならない。
エミーはややこしいので、アレクセイへ戻ろう。マーカス・ハッター(Marcus Hutter)の 【トピック:意思決定理論】 AIXIの枠組みは、アレクセイのようなエージェントがどう機能するかを表す、優れた理論モデルを与える。
$$ a_k \;:=\; \arg\max_{a_k}\sum_{ o_k r_k} %\max_{a_{k+1}}\sum_{x_{k+1}} … \max_{a_m}\sum_{ o_m r_m} [r_k+…+r_m] \hspace{-1em}\hspace{-1em}\hspace{-1em}\!\!\!\sum_{{ q}\,:\,U({ q},{ a_1..a_m})={ o_1 r_1.. o_m r_m}}\hspace{-1em}\hspace{-1em}\hspace{-1em}\!\!\! 2^{-\ell({ q})} $$
このモデルには、行動、観察、報酬を用いて相互作用するエージェントと環境がある。エージェントが行動 \(a\) を出力すると、環境が観察 \(o\) と報酬 \(r\) の両方を返す。この過程が、各時点 \(k…m\) で繰り返される。
各行動は、それ以前の行動・観察・報酬の三つ組すべてを引数とする関数である。同様に、各観察と報酬も、それらの三つ組と、直前の行動を引数とする関数である。
この枠組みでは、相互作用する環境について完全な知識を持つエージェントも想像できる。しかしAIXIは、環境について不確実性がある中での最適化をモデル化するために使われる。AIXIは、計算可能なすべての環境 \(q\) にわたる確率分布を持ち、その分布のもとで期待報酬が高くなる行動を選ぶ。将来の報酬も重視するため、情報の価値を求めて探索することもある。
いくつかの仮定のもとでは、不確実性があっても、AIXIが計算可能なあらゆる環境で相応にうまく振る舞うことを示せる。しかしAIXIが相互作用する環境は計算可能であるのに対し、AIXI自体は計算不能である。エージェントは環境とは異なる種類の、より強力な素材でできている。
AIXIやアレクセイのようなエージェントを「二元論的」と呼ぶことにしよう。彼らは環境の外に存在し、エージェント側の素材と環境側の素材の間には、 【トピック:意思決定理論】 定められた相互作用しかない。 【トピック:埋め込み型世界モデル】 エージェントが環境より大きいことを必要とし、 【トピック:頑健な委任】 自己言及的な推論をモデル化しない傾向がある。エージェントは、 【トピック:サブシステム・アライメント】 自分が推論する対象とは異なる素材でできているからだ。
AIXIだけではない。こうした二元論的仮定は、合理的エージェンシーに関する現在最良の理論のいたるところに現れる。
私はAIXIを少し引き立て役のように設定したが、AIXIから着想を得ることもできる。AIXIを見ると、アレクセイがどう機能するかを本当に理解できた気がする。エミーについても、これと同じ種類の理解がほしい。
残念ながら、エミーはややこしい。「埋め込み型エージェンシー」の理論がほしいと言うとき、私が意味するのは、エミーのようなエージェントがどう機能するかを理論的に理解したいということである。つまり、環境の中に埋め込まれており、そのため次の性質を持つエージェントだ。
- 【トピック:意思決定理論】 明確に定義された入出力経路を持たない。
- 【トピック:埋め込み型世界モデル】 環境より小さい。
- 【トピック:頑健な委任】 自分自身について推論し、自己改善できる。
- 【トピック:サブシステム・アライメント】 環境と同じような構成要素でできている。
この四つの厄介さが、互いに切り分けられた区分を成すとは考えないでほしい。相互に深く絡み合っている。
たとえば、エージェントが自己改善できるのは、複数の構成要素からできているからだ。また環境がエージェントより十分に大きければ、エージェントの別のコピーを含んでいる可能性があり、その場合、明確に定義された入出力経路は失われる。
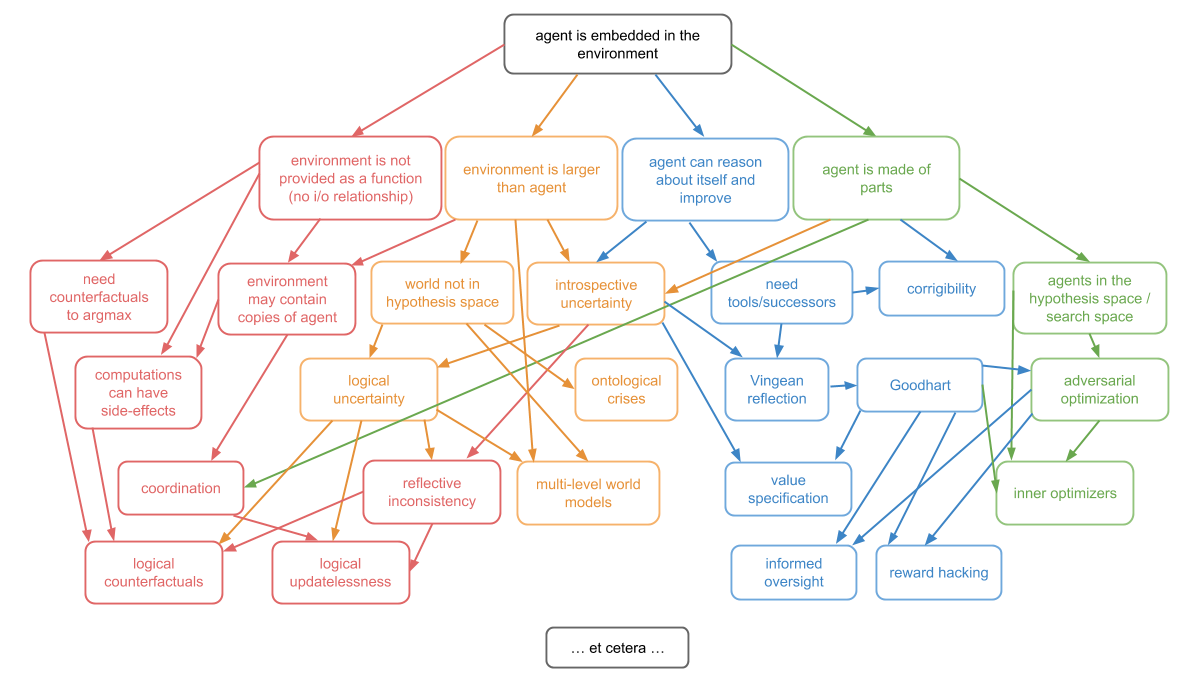
それでも、この四つの厄介さを手がかりに、埋め込み型エージェンシーという主題を四つの下位問題へ分けることにする。 【トピック:意思決定理論】 意思決定理論、 【トピック:埋め込み型世界モデル】 埋め込み型世界モデル、 【トピック:頑健な委任】 頑健な委任、 【トピック:サブシステム・アライメント】 サブシステム・アライメントである。
【トピック:意思決定理論】 意思決定理論は、埋め込み型最適化のすべてを扱う。
二元論的最適化の最も単純なモデルは \(\mathrm{argmax}\) である。\(\mathrm{argmax}\) は、行動を報酬へ写す関数を受け取り、その関数のもとで最大の報酬につながる行動を返す。ほとんどの最適化は、この何らかの変形と考えられる。何らかの空間があり、その空間から報酬や効用などの得点への関数があり、この関数のもとで高得点となる入力を選びたい。
しかし、埋め込み型エージェントであるということの大きな部分は、関数として表せる環境を持たないことだ、といま述べた。それならどうすればよいのか。最適化は明らかにエージェンシーの重要な部分だが、現状では重大な型エラーを犯さずに、理論上それが何かを述べることさえできない。
意思決定理論の主な未解決問題には、次のものがある。
- 論理的反実仮想:実際には行動Aを取ると証明できるとき、行動Bを取ったなら何が起こるかを、どう推論するのか。
- 複数のエージェントのコピー、または、そのエージェントについて信頼できる予測を含む環境。
- 論理的アップデートレス性。ウェイ・ダイ(Wei Dai)のアップデートレス意思決定理論が持つ、とても優れている一方で非常にベイズ的な世界と、論理的不確実性が持つ、ベイズ的でない世界をどう組み合わせるかという問題である。
【トピック:埋め込み型世界モデル】 埋め込み型世界モデルは、世界よりはるかに小さなエージェントの中に収まりながら、優れた世界モデルをどう作るかを扱う。
これは極めて難しいことが分かっている。第一に、本当の宇宙が仮説空間に含まれないことになり、多くの理論的保証が失われる。第二に、学習するときベイズ的でない更新を行わなければならず、これも多くの理論的保証を失わせる。
また、内側にいる観察者の視点から世界モデルをどう作るか、そして人間原理のように、そこから生じる問題も扱う。埋め込み型世界モデルの主な未解決問題には、次のものがある。
- 論理的不確実性。論理の世界と確率の世界をどう組み合わせるかを扱う。
- 多層的モデリング。同じ世界について異なる記述水準のモデルを複数持ち、その間を滑らかに移行する方法を扱う。
- 存在論的危機。自分のモデル、さらには目標までもが、現実世界とは異なる存在論を用いて指定されていたと気づいたとき、どうすればよいかを扱う。
【トピック:頑健な委任】 頑健な委任は、特殊な種類の本人・代理人問題を扱う。初期エージェントが、自分の目標を最適化するのを助けてもらうため、より知的な後継エージェントを作りたいとする。どのような後継エージェントを作るかを厳密に決められるので、初期エージェントがすべての力を持つ。しかし別の意味では、はるかに知的なので、後継エージェントがすべての力を持つ。
初期エージェントの視点では、問いは「自分に対して知性を利用することが確実にない後継者を、どう作るか」である。後継エージェントの視点では、問いは「愚かで、操作されやすく、適切な存在論さえ使っていないものの目標を、どうすれば確実に学び、尊重できるか」である。
自分より強力なものを一貫して信頼するのを不可能にするローブ的障害から、さらなる問題が生じる。
時間とともに学ぶだけのエージェント、重大な自己改善を行うエージェント、強力な道具を作ろうとするだけのエージェント、どの文脈でもこれらの問題を考えられる。
頑健な委任の主な未解決問題には、次のものがある。
- ヴィンジ的内省。信頼を妨げるローブ的障害があっても、自分よりはるかに賢いエージェントについてどう推論し、信頼するかを扱う。
- 価値学習。初期エージェントが愚かで一貫していなくても、後継エージェントがその目標をどう学ぶかを扱う。
- 訂正可能性(corrigibility)。自分を修正させまいとする道具的誘因があっても、初期エージェントが後継エージェントに、修正を許させる(さらには修正を手伝わせる)方法を扱う。
【トピック:サブシステム・アライメント】 サブシステム・アライメントは、自分や互いに対立するサブシステムを持たない、統一された一つのエージェントになる方法を扱う。
「世界を救う」といった目標を持つエージェントが、「金を稼ぐ」といった下位目標について考えることに、多くの時間を費やす場合がある。金を稼ぐことだけを目指す下位エージェントを起動すると、目標の異なるエージェントが二つになり、対立が生じる。下位エージェントは、金を稼ぐことしかしないように見えながら、さらに多くの金を稼ぐため実際には世界を破壊する計画を提案するかもしれない。
問題は、意図的に起動する下位エージェントだけを心配すればよいわけではないことだ。誤って下位エージェントを起動することも心配しなければならない。エージェントを含められるほど豊かな空間で探索や最適化を行うたびに、その空間自体が最適化を行う可能性を心配しなければならない。この最適化は外側のシステムが試みていた最適化と厳密には一致しないかもしれないが、整合しているように見せかける道具的誘因は確実に持つ。
実際の最適化の多くでは、このように責任を別のものへ押しつける。解決策を見つけるだけでなく、それ自体が解決策を探索できるものを見つけるのだ。
理論上、私は最適化を行う方法をまったく理解していない。自分には理解できないものを多数見つけ、それが目標を達成するか確かめるような手法以外には。しかし、まさにこの種のものが、敵対的なサブシステムを起動する危険性を最も持つ。
サブシステム・アライメントの大きな未解決問題は、敵対的な最適化主体を起動しない基礎レベルの最適化主体をどう作るかである。生じる最適化主体が意図的なものか意図しないものかに分け、帰納のように制限された最適化の下位分類を考えることで、この問題をさらに分割できる。
ただし忘れないでほしい。意思決定理論、埋め込み型世界モデル、頑健な委任、サブシステム・アライメントは、四つの別々の問題ではない。すべて、埋め込み型エージェンシーという一つの統一された概念に含まれる、異なる下位問題である。
この記事の第2部は数日以内に公開する予定である:意思決定理論。