
意思決定理論と人工知能は通常、次のようなものを計算しようとする。
$$\underset{a \ \in \ Actions}{\mathrm{argmax}} \ \ f(a).$$
すなわち、行動の何らかの関数を最大化する。これは物事を十分に解きほぐし、結果を行動の関数として見られることを前提としがちである。
たとえばAIXIは、エージェントと環境を別々の単位として表し、両者が明確に定義された入出力チャネルを通じ、時間とともに相互作用するものとする。そうすることで、報酬を最大化する行動を選べる。
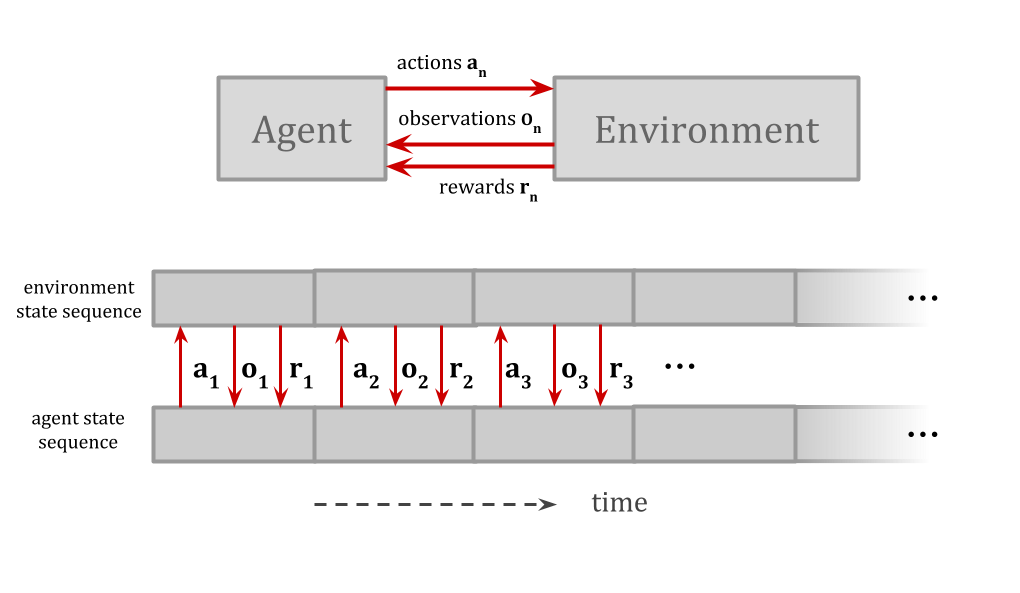
エージェントのモデルが環境モデルの一部である場合、別の行動を取ることをどう考えればよいかは、著しく不明確になりうる。
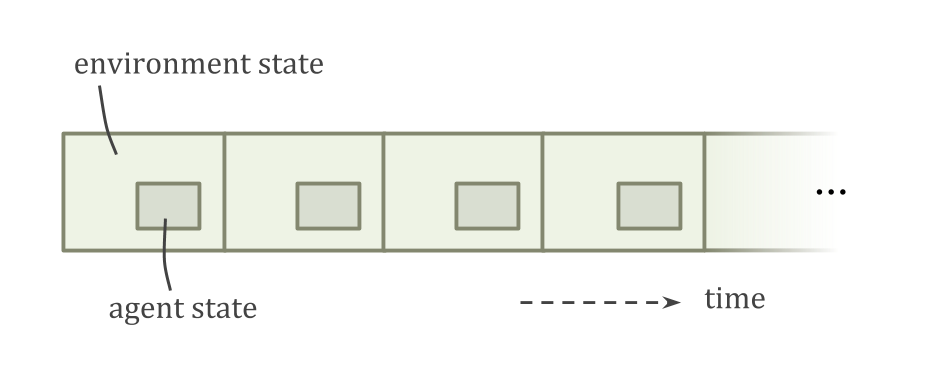
たとえばエージェントは 【トピック:埋め込み型世界モデル】 環境より小さいため、そのエージェントの別のコピーや、非常によく似たものが存在しうる。このことから、双子の囚人のジレンマやニューカム問題のように、議論の分かれる意思決定理論上の問題が生じる。
エミー・モデル1とエミー・モデル2が同じ経験をし、同じソースコードを実行しているなら、エミー・モデル1は、自分の決定が二体のロボットを一度に操るかのように行動すべきだろうか。「自分自身」の境界をどこに引くかによって、両方のコピーの行動を制御するとも、自分自身の行動だけを制御するとも考えられる。
これは反事実的推論の問題の一例である。「太陽が突然消えたらどうなるか」といった仮定を、どう評価すればよいのか。
【トピック:意思決定理論】 意思決定理論を埋め込まれたエージェントへ適応する際の問題には、次が含まれる。
- 反事実
- エージェントが自分のコピーと相互作用する、ニューカム型の推論
- より広く、ほかのエージェントについての推論
- 恐喝問題
- 協調問題
- 論理的反事実
- 論理的更新不要性
エージェントが反事実について考える必要がある理由の、最も中心的な例は、自分の行動に関する反事実から生じる。
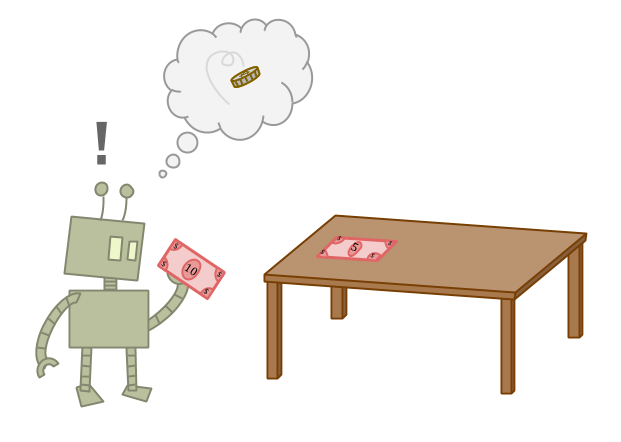
行動反事実の難しさは、5ドルと10ドル問題で説明できる。5ドル札と10ドル札のどちらかを取る選択肢があり、この状況で気にするのは得る金額だけだとしよう。明らかに10ドルを取るべきだ。
しかし10ドルを確実に取るのは、見かけほど簡単ではない。
自分自身を環境の単なる別の一部として推論すると、 【トピック:頑健な委任】 自分の挙動を知ることができる。自分の挙動を知れるなら、異なる挙動をした場合に何が起きるかを推論するのが難しくなる。
これは一般的な推論方法の多くに支障を来す。自分自身についての知識が十分豊富なら、一方のシナリオが矛盾すると明らかになるとき、「10ドルを取るとよい結果になり、5ドルを取ると悪い結果になる」という考えを、どう形式化すればよいのか。
そして、そのような考えを形式化できないなら、現実世界のエージェントは、それでも10ドルを取るべきだとどう判断するのか。
よく行われるように、ベイズ条件づけによって行動の期待効用を計算しようとすると、自分の挙動を知っているため、取らないと知っている行動の期待効用を計算する際、ゼロ除算エラーが生じる。\(\lnot A\) から \(P(A)=0\) が導かれ、そこから \(P(B \& A)=0\) が導かれ、さらに次が導かれる。
$$P(B|A) = \frac{P(B \& A)}{P(A)} = \frac{0}{0}.$$
エージェントは自分自身を環境から切り離す方法を知らないため、異なる行動を取ることを想像しようとすると、内部の歯車がかみ合わず軋む。
しかし最大の複雑さは、レーブの定理から生じる。レーブの定理により、ほかの点では妥当に見えるエージェントが、「10ドルを取れば0ドルを得る」ため5ドルを取ることがある! しかもこれは安定した形で起きる。エージェントが学習したり、問題についてさらに考えたりしても解決できない。
信じにくいかもしれないので、詳しい例を見よう。この現象は、5ドルと10ドル問題について推論する、論理に基づく単純なエージェントの挙動で説明できる。
次の例を考える。
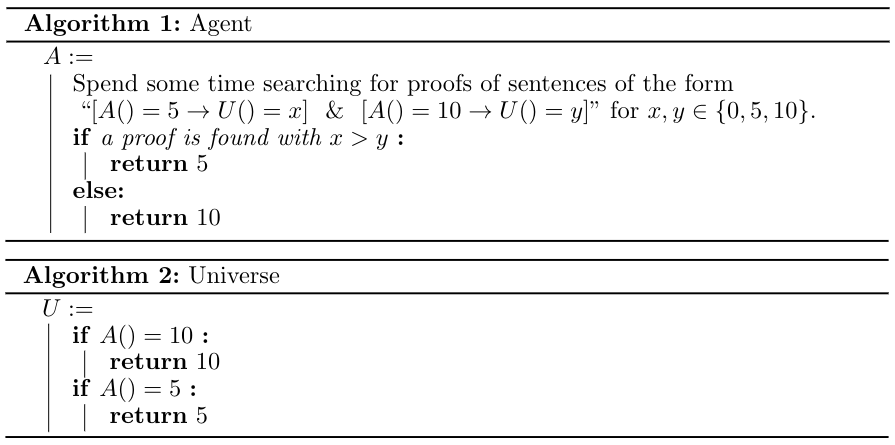
エージェントと宇宙のソースコードがある。両者はクワイン化を用いて互いを参照できる。宇宙は単純で、エージェントが出力したものを、そのまま出力するだけだ。
エージェントは、さまざまな行動を取ると何が起きるかについて、長い時間をかけて証明を探す。\(x\) と \(y\) が \(0\)、\(5\)、\(10\) のいずれかであり、\(5\)を取ると効用 \(x\)、\(10\)を取ると効用 \(y\) が得られ、\(x>y\) であるという証明を見つければ、当然 \(5\) を取る。私たちは、そのような証明は見つからず、既定の行動である \(10\) を取ると予想する。
宇宙について推論しようとするエージェントを単に想像すれば、簡単に見える。しかし証明を探す時間が十分に長いと、エージェントは必ず \(5\) を選ぶことが分かる!
そうなることの証明には、 【トピック:頑健な委任】 レーブの定理を使う。レーブの定理によれば、任意の命題 \(P\) について、\(P\) の証明が \(P\) が真であることを含意すると証明できるなら、\(P\) を証明できる。「\(□X\)」を「\(X\) は証明可能である」という意味にすると、記号では次のようになる。
$$□(□P \to P) \to □P.$$
ここで述べた5ドルと10ドル問題では、「\(P\)」は「エージェントが \(5\) を出力すれば宇宙は \(5\) を出力し、エージェントが \(10\) を出力すれば宇宙は \(0\) を出力する」という命題である。
それが証明可能だと仮定すると、エージェントはいずれ証明を見つけ、実際に \(5\) を返す。これにより文は真になる。エージェントは \(5\) を出力し、宇宙も \(5\) を出力するうえ、エージェントが \(10\) を出力するという命題は偽だからだ。「エージェントが \(10\) を出力する」のような偽の命題は、宇宙が \(5\) を出力することを含めて、何でも含意する。
エージェントは(十分な時間があれば)このすべてを証明できる。その場合、実際に「エージェントが \(5\) を出力すれば宇宙は \(5\) を出力し、エージェントが \(10\) を出力すれば宇宙は \(0\) を出力する」という命題を証明する。その結果、エージェントは5ドルを取る。
これを「見せかけの証明」と呼ぶ。エージェントが5ドルを取るため、10ドルを取るなら得られる価値が低いと証明でき、そのために5ドルを取る。循環しているように聞こえるが、残念ながら論理的には正しい。より一般に、証明にあまり依存しない設定では、これを見せかけの反事実の問題と呼ぶ。
一般的なパターンはこうだ。反事実が、ある行動をあまりよくないものだと誤って印づけることがある。そのためAIはその行動を取らない。反事実の仕組みによっては、問題のある反事実を「修正」するフィードバックが失われる。または証明に基づく推論で見たように、見せかけの反事実が「真」になることを積極的に助ける場合もある。
証明に基づく例は私たちにとって大きな関心事なので、「反事実」は実際には「反論理的反事実(counter_logicals_)」でなければならないことに注意してほしい。論理的に不可能な「可能性」について推論する必要がある場合がある。このことにより、既存の反事実的推論の説明の大半は利用できない。
少しごまかしたことに気づいたかもしれない。対称性を破り、エージェントに5ドルを取らせた唯一のものは、証明が見つかったとき取る行動が「\(5\)」で、既定が「\(10\)」だったことだ。代わりに、どの行動がどの効用へつながるかについて、何であれ証明を探し、よりよい行動を取るエージェントを考えられる。この場合、取る行動は、証明を探す順序に依存する。
短い証明から先に探すとしよう。この場合、\(A()=5\) が \(U()=5\) へつながり、\(A()=10\) が \(U()=10\) へつながることは非常に簡単に示せるため、10ドルを取る。
問題は、見せかけの証明も短くなりうるうえ、宇宙の予測が難しくなっても、さほど長くならないことだ。宇宙を、機能的には同じだと証明できるが、予測しにくいものへ置き換えると、最短の証明は複雑な宇宙を短絡させ、見せかけのものになる。
人々はしばしば、常に何らかの不確実性があると提案することで、反事実の問題を解こうとする。AIは自分のソースコードを完全に知っていても、自分が動くハードウェアを完全には知れない。
少し不確実性を加えると問題は解けるだろうか。多くの場合、解けない。
- 見せかけの反事実の証明は、なお成立することが多い。95%の確信で5ドルと10ドル問題にいると思うなら、その95%の中で通常の問題が生じうる。
- 反事実を明確に定義できるよう不確実性を加えても、その反事実が妥当だという保証はまったく得られない。別の行動を考える際、通常予想したいのはハードウェア障害ではない。
次のシナリオを考える。自分はほぼ必ず左の道を進むと確信している。しかし、宇宙線が回路を損傷する可能性も(低いながら)あり、その場合は右へ進める。ただしそのとき自分は狂っており、ほかにも多くの悪い結果が生じる。
この推論自体が常に左へ進む理由なら、何かを間違えている。
エージェントが自分の行動について何らかの不確実性を持つと保証するだけでは、ある程度でも妥当な反事実上の予想を持つとは保証できない。しかし代わりに試せることの一つは、各行動を何らかの確率で実際に取るよう保証することだ。この戦略をε探索と呼ぶ。
ε探索により、エージェントが同種のゲームを十分な回数行えば、最終的には現実的な反事実を学習できる(後で触れる 【トピック:埋め込み型世界モデル】 実現可能性の問題は別とする)。
ε探索が機能するのは、エージェント自身が、まさにε探索を行おうとしているか予測できないよう保証する場合に限られる。実際、ε探索を実装するよい方法は、「エージェントが自分の行動へ確信を持ちすぎているなら、別の行動を取る」という規則である。
論理的な観点では、ε探索の予測不能性が、ここまで論じた問題を防ぐ。学習理論の観点では、エージェントが探索しようとしていないと知れたなら、それを別の事例として扱い、探索から得た教訓を一般化し損なう可能性がある。すると、エージェントがよりよい反事実を学習する保証がない状況へ戻る。ある行動については探索が唯一のデータ源かもしれないため、そのデータを考慮するようエージェントへ強制する必要がある。そうしなければ学習しない可能性がある。
しかしε探索でさえ、物事を厳密に正しく捉えられないように見える。ε探索の結果を観察して分かるのは、ある行動を予測不能な形で取ると何が起きるかである。その行動を通常どおり取った場合の帰結は、異なるかもしれない。
自分が、ε探索者ばかりの世界に住むε探索者だとしよう。警備員の職へ応募し、警備している品を持ち逃げする種類の人間ではないと面接官を納得させる必要がある。面接官は、ばれないと思っても嘘をついたり盗んだりできないほど誠実な人を雇いたい。
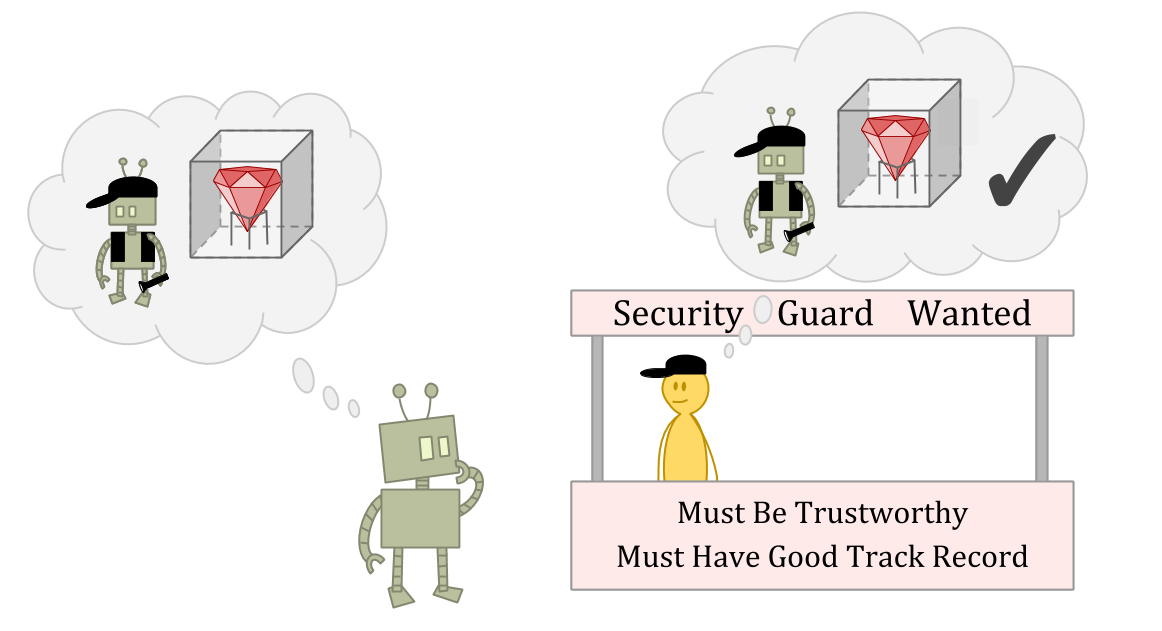
面接官が人柄を驚くほど正確に見抜ける、または単に自分のソースコードを読み取れるとしよう。
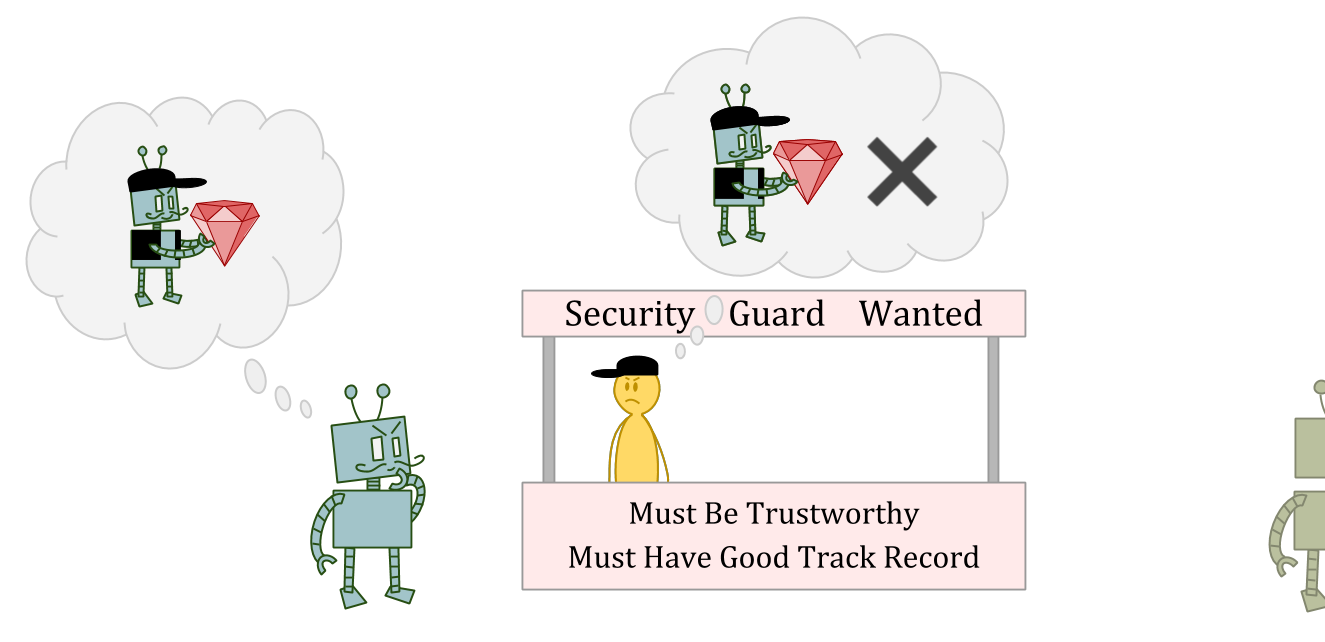
この状況では、ε探索の行動として盗むのはすばらしい選択肢かもしれない。面接官は盗みを予測できないかもしれず、一度限りの異常に処罰する意味はないと考えるかもしれないからだ。
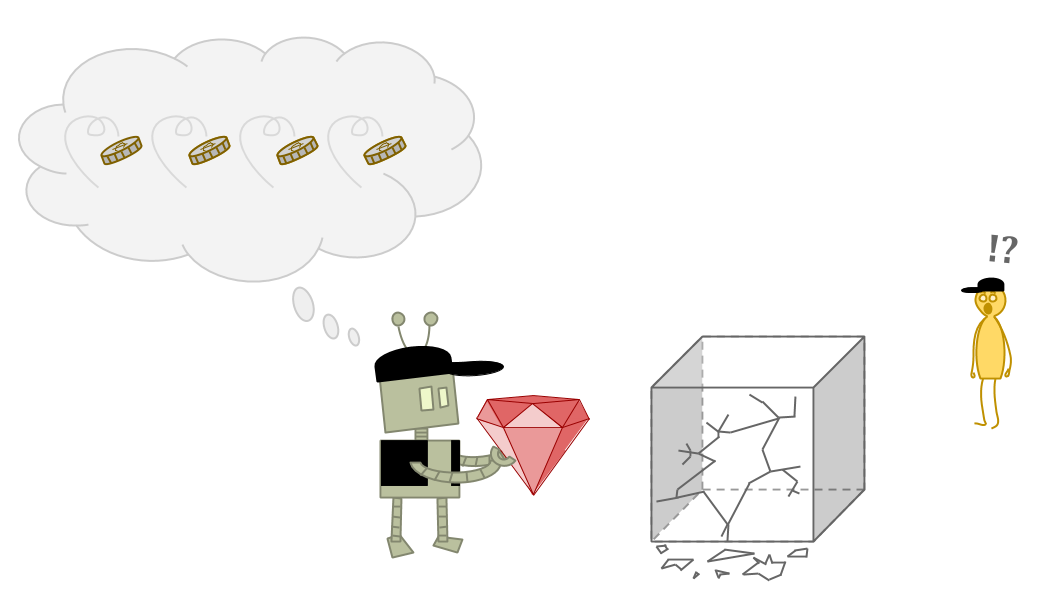
しかし通常の行動として盗むのは明らかに悪い考えだ。信頼性と信用がはるかに低いと見られるからである。
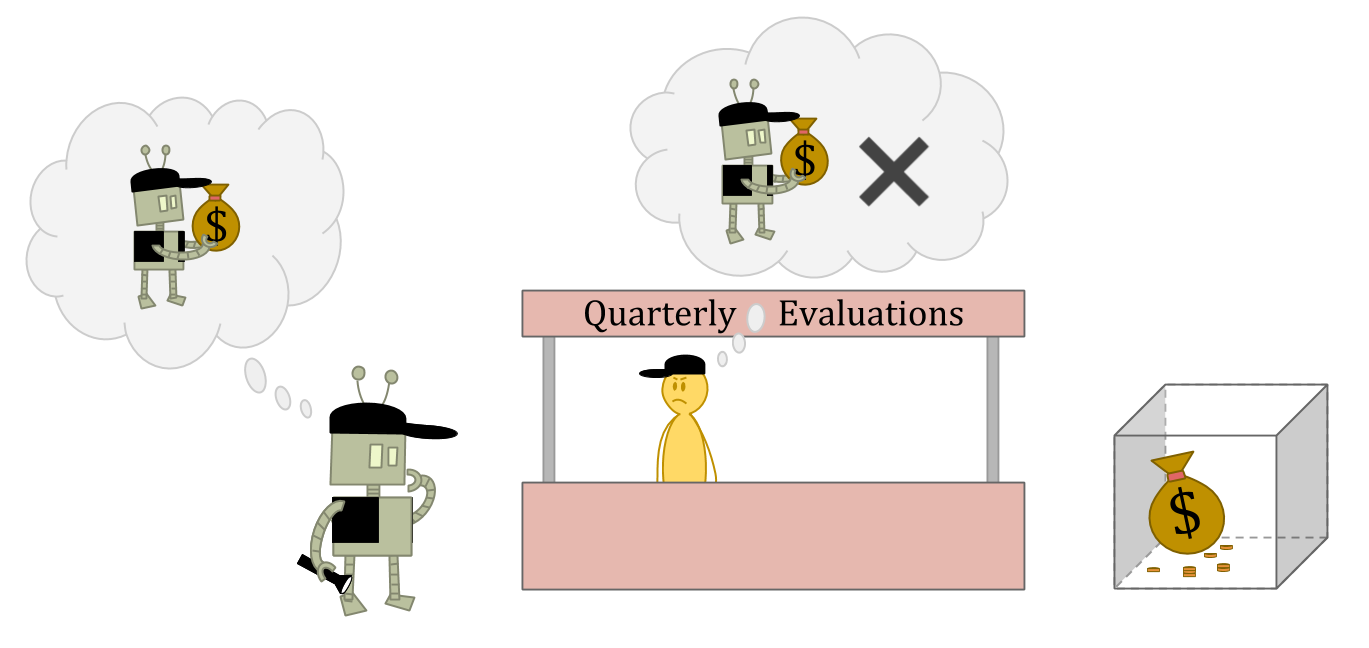
したがってε探索から反事実を学習しなければ、現実的な反事実を学習する保証がまったくないように思える。しかしε探索から学習しても、一部の事例ではやはり間違えるようだ。
確率的な設定へ移っても、エージェントが確実に「妥当な」選択をするようにはならず、強制的な探索でもならない。
しかし「正しい」反事実的推論の例を外部から書き下すことは、難しくないように見える!
おそらくそれは、「外部」からは常に二元論的な観点を持てるからだ。私たちは実際に問題の外側に座り、問題をエージェントの関数として定義している。
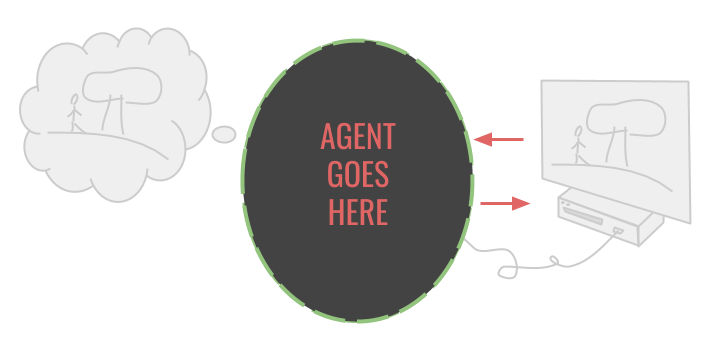
しかしエージェントは、内部から同じ方法で問題を解けない。エージェントの観点では、環境との関数関係は観察可能な事実ではない。そもそも「反事実」が「事実に反するもの」と呼ばれる理由がこれである。
5ドルと10ドル問題を説明したとき、私はまず問題について説明し、それからエージェントを示した。あるエージェントがうまく機能しなければ、別のエージェントを考えられる。
意思決定問題で成功する方法を見つけることは、問題へ組み込んだとき正しい行動を取るエージェントを見つけることである。異なるエージェントを組み込むことさえ考えられるという事実は、宇宙をすでに「エージェント」の部分と、エージェントの形をした穴がある宇宙の残りへ切り分けたことを意味する。これは作業の大半をすでに終えたに等しい!
それなら、意思決定問題の設定方法のせいで、私たちは自分を欺いているだけなのか。「正しい」反事実など存在しないのか。
確かに、私たちは自分を欺いているのかもしれない。それでも混乱している何かは残る! 「反事実は主観的で、エージェントが発明するものだ」と言っても、謎は解消しない。現実世界で知的エージェントが意思決定するために行っている何かがある。
したがって私が、自分の行動を知るエージェントについて話しているのは、将来、知的機械が自分の行動を推論することに大きな問題が生じると思うからではない。むしろ、自分の行動を知る可能性は、行動の帰結を見定めることについて、何か分からないことがあると示す。その混乱は、世界についてすべてを知り、より大きな金額を選ぶだけの極めて単純な場合にさえ現れる。
そうは言っても、人間は10ドルを取るのに何の問題もないようだ。
人間の意思決定方法から、何か手がかりを得られるだろうか。
実際に10ドルと5ドルのどちらかを選ぶよう求められたとしよう。自分が10ドルを取ると知っている。それなら代わりに5ドルを取ったなら何が起きるかを、どう推論するのか。
自分自身を世界から切り離し、外部の帰結(5ドルを得ること)だけを考えられるなら簡単に見える。
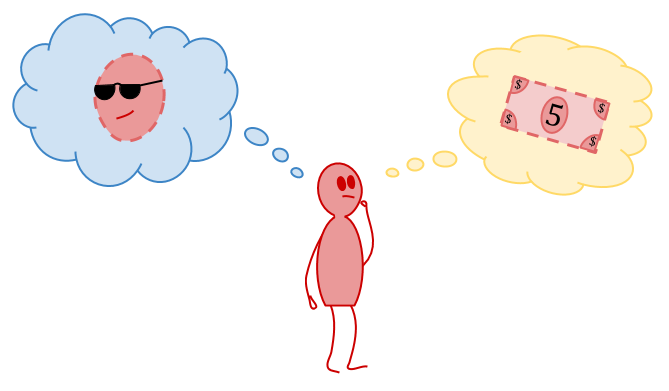
自分自身についても考えると、反事実は少し奇妙または矛盾して見え始める。5ドルを取るなら世界がどうなっているかについて、「目が見えないはずだ!」のような不合理な予測をしているかもしれない。
だが問題はない。結局、5ドルを取れば悪い結果になると依然として判断し、10ドルを取るので、うまくできている。
形式的エージェントにとっての難題は、似た立場にありながら5ドルを取っていて、自分が5ドルを取ると知り、10ドルを取ると何が起きるかについて不合理な予測を行うため、代わりに10ドルを取るべきだと突き止められない場合があることだ。
人間がそのような状況へ陥るのは難しそうに見える。しかし形式的推論器を書き下そうとすると、この種の問題に繰り返し直面する。したがって、人間の意思決定は、ここで私たちがまだ理解していない何かを実際に行っているように見える。
埋め込まれたエージェントなら、環境内のほかの物体について考えるのと同じように、自分自身について考えられるはずだ。そして環境内のほかの推論器も、自分について考えられるはずである。
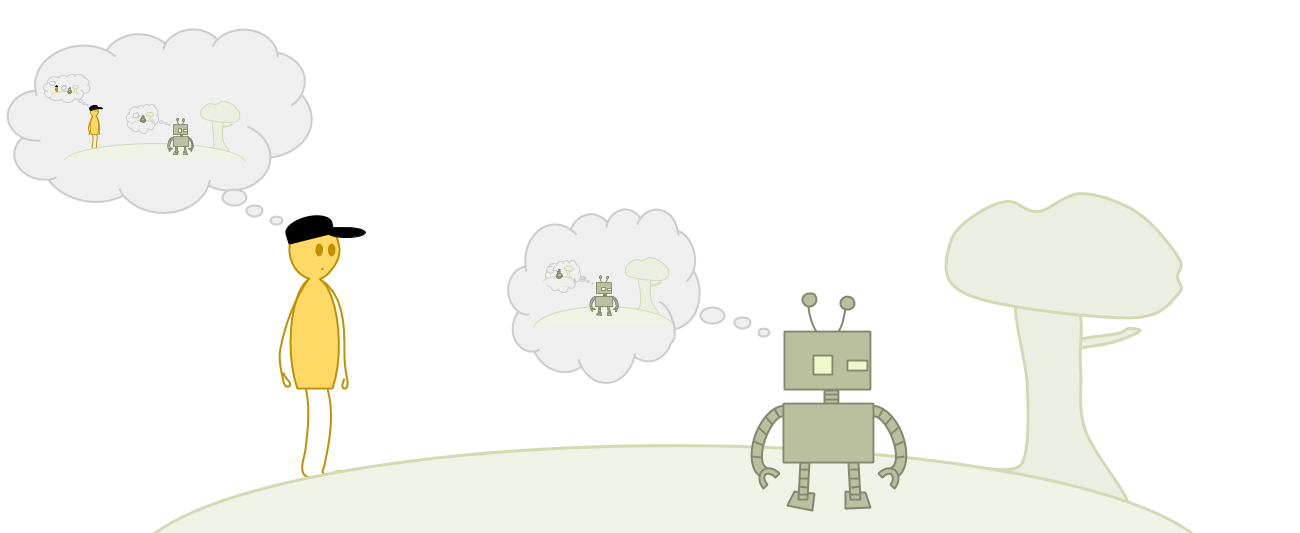
5ドルと10ドル問題では、エージェントが行動前に自分の行動を知ると、物事がどれほど混乱しうるかを見た。しかし埋め込まれたエージェントが、これを避けるのは難しい。
【トピック:埋め込み型世界モデル】 論理的全知を前提とする標準的なベイズ設定では、自分の行動を知らずにいることが特に難しい。確率分布は、論理的に真である事実へ確率1を割り当てる。したがってベイズ・エージェントが 【トピック:頑健な委任】 自分のソースコードを知っているなら、自分の行動も知るはずだ。
しかし論理的に全知ではない現実的なエージェントも、同じ問題へ直面しうる。論理的全知は問題を強制的に顕在化させるが、論理的全知を退けても問題は消えない。
ε探索は、エージェントが自分の選択について不確実性を持ち、予想が経験に基づくよう保証することで、多くの場合、この問題を実際に解決するように見える。
しかし警備員の例で見たように、ランダムに探索した結果と、予測可能な形で行動した結果が異なる場合、ε探索でさえ誤った方向へ導くように見える。
このような形で誤る例には、自分のように振る舞う環境の別の部分――自分によく似た別のエージェントや、自分について十分に優れたモデルまたはシミュレーションなど――が関係するように見える。これをニューカム型問題と呼ぶ。先に触れた双子の囚人のジレンマが一例である。
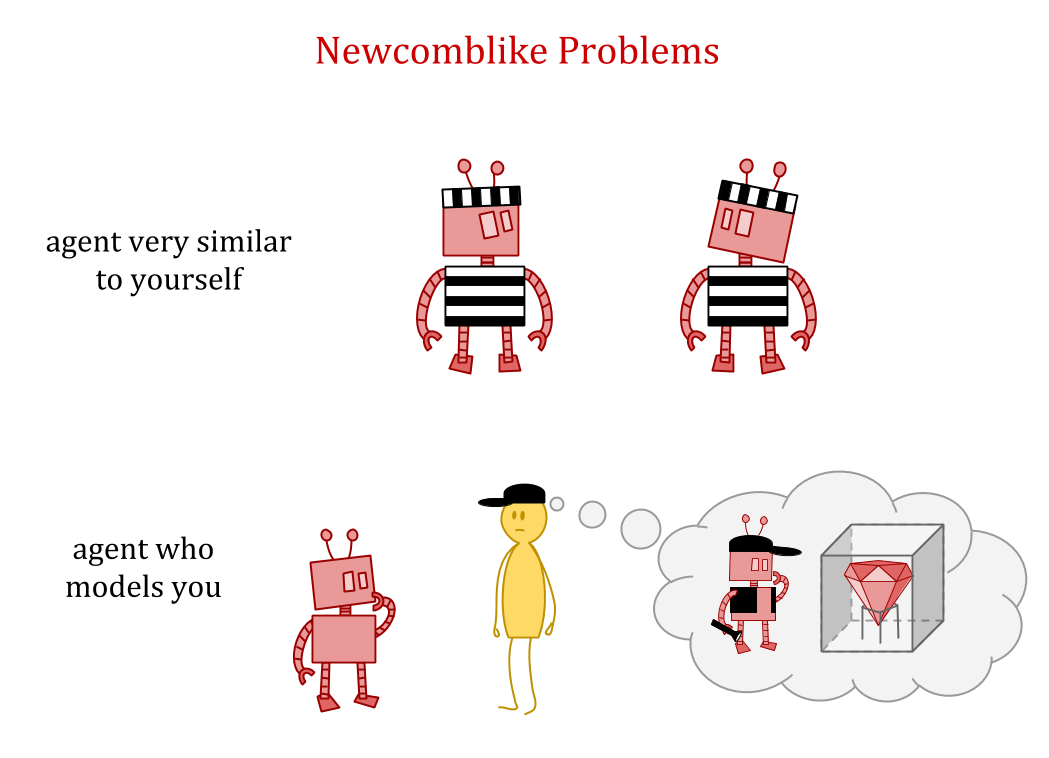
5ドルと10ドル問題が、世界を自分の行動の関数として扱えるよう、自分の形をした部分を世界から切り取る問題なら、ニューカム型問題は、世界に自分とおおよそ同じ形の部分が複数あるとき、どうすべきかという問題である。
一つの考えは、完全なコピーは100%、自分の「論理的制御」下にあるものとして扱うべきだというものだ。自分の近似モデルや、単に似たエージェントでは、 【トピック:埋め込み型世界モデル】 論理的相関が低下するにつれて、制御も急激に低下すべきである。しかし、それはどのように機能するのか。
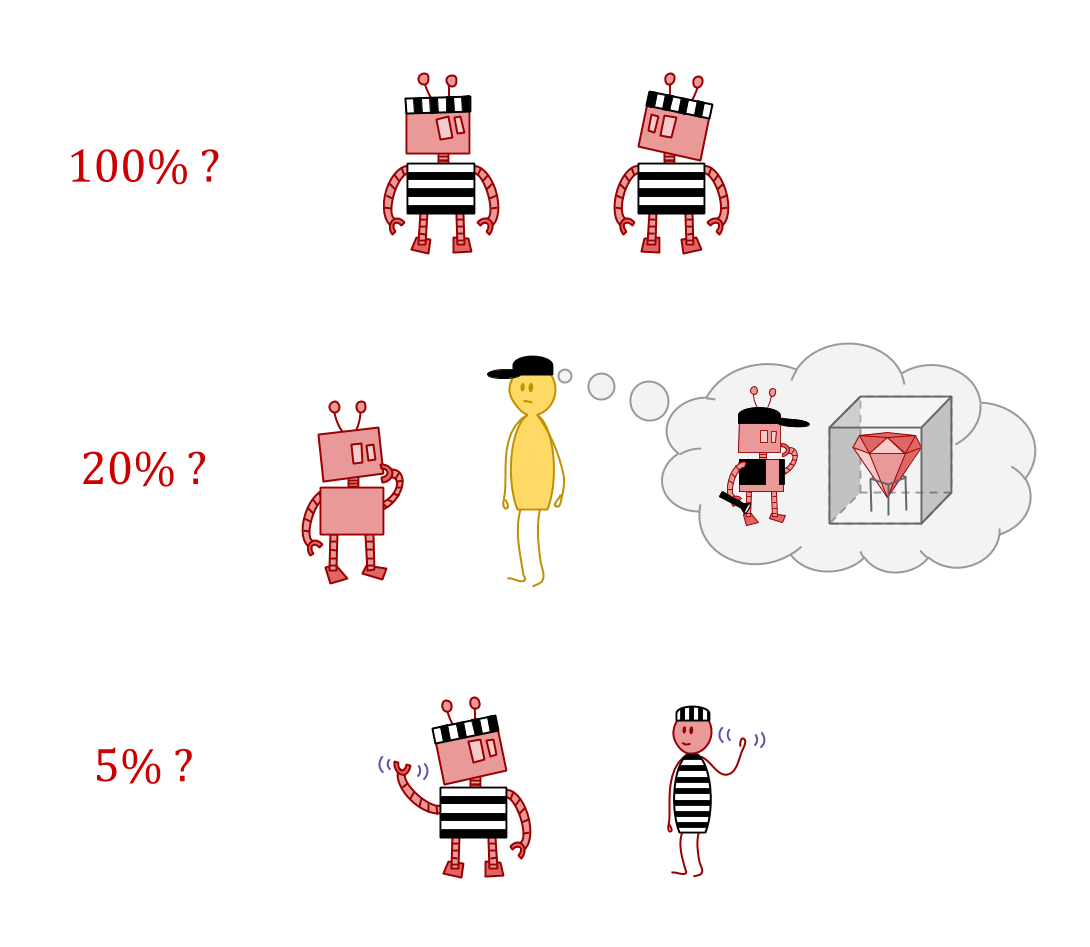
ニューカム型問題が難しい理由は、ここまで論じた自己言及の問題とほぼ同じである。予測だ。ε探索のような戦略では、問題を避けるため、エージェントの自己知識を制限しようとした。しかし環境内に強力な予測器が存在すると、問題が再び持ち込まれる。予測器は共有する情報を選ぶことで、エージェントを操作し、その行動を選ばせられる。
自分を予測できる何かがあるなら、その予測や関係する情報を自分へ伝えるかもしれない。その場合、知りうるさまざまな事柄へどう反応するかが重要になる。
何を伝えられても、その反対を行うと決めたとしよう。その場合、そもそもシナリオを設定できない。予測器は結局正確ではないか、または予測器が予測を自分へ伝えないかの、どちらかである。
反対に、予測されたとおりに行動する状況があるとしよう。その場合、予測器はどの予測を伝えるか制御することで、自分の振る舞いを制御できる。
したがって一方では、強力な予測器が、整合する可能性の中から選ぶことで自分を制御できる。他方では、そもそも反応のパターンを選ぶのは自分である。つまり、そのパターンを自分にとって最も有利な形に設定できる。
ここまでは、行動反事実――異なる行動の帰結をどう予測するか――を論じてきた。反応を制御するという議論から、観察反事実が導入される。異なる事実を観察したなら世界がどうなるかを想像することである。
将来の挙動について予測を伝える者が誰もいなくても、観察反事実は正しい判断をするうえで役割を果たしうる。次のゲームを考えよう。
アリスは無作為に1枚のカードを受け取り、それはHighかLowのどちらかである。望むならカードを公開できる。その後ボブは、アリスのカードがHighである確率 \(p\) を提示する。アリスは常に \(p^2\) ドルを失う。ボブはカードがLowなら \(p^2\)、Highなら \((1-p)^2\) を失う。
ボブには適正スコアリング規則が適用されるため、本当の信念を提示するのが最善となる。アリスは、ボブの信念をできるだけ「Low」寄りにしたいだけである。
アリスがこのゲームを一度だけ行うとしよう。Lowのカードを見た。ボブはアリスについて巧みに推論できるが、隣室にいるので、そぶりを読み取れない。アリスはカードを公開すべきだろうか。
アリスのカードはLowなので、ボブへ見せれば一銭も失わず、可能な限り最善の結果になる。しかしこれは、アリスがHighのカードを見た反事実的な世界では、秘密を守れないことを意味する。その場合もカードを見せるほうがよい。見せるのをためらえば、それ自体が「High」であることを同じくらい確実に示すからだ。
他方、アリスがカードを見せなければ25セントを失う。しかしそうすれば、もう一方の世界でも同じ戦略を使え、1ドルを失わずに済む。したがってゲーム前のアリスは、公開しないと目に見える形でコミットしたい。この戦略の期待損失は25セントだが、もう一方の戦略は50セントである。観察反事実を考慮すると、アリスは秘密を守れる。それがなければ、ボブはアリスの行動からカードを完全に推論できる。
このゲームは、反事実的強盗と呼ばれる意思決定問題に相当する。
更新不要意思決定理論(UDT)は、High/Lowカードゲームで秘密を守れる、提案されている意思決定理論である。UDTは、以前なら最も賢明に見えたこと―― 【トピック:頑健な委任】 以前の自分が行うとコミットしたであろうこと――を何でも行うよう勧めることで、これを実現する。
実のところ、UDTはニューカム型問題でも良好に機能する。
UDTのようなものは、暗黙的な形にすぎないとしても、人間が意思決定問題でよい結果を得るために行っていることと関係しているのだろうか。関係していないとしても、意思決定を考えるためのよいモデルになりうるだろうか。
残念ながら、ここにはなお、かなり深い難点がある。UDTはかなり幅広い意思決定問題への優雅な解決策だが、以前の自分が、 【トピック:埋め込み型世界モデル】 起こりうるすべての状況を予見できる場合にしか意味をなさない。
事前分布がすべての可能性をすでに内包するベイズ設定では、これはうまく機能する。しかし現実的な埋め込み設定では、そうする方法が存在しないかもしれない。エージェントは新しい可能性を考えられなければならない。つまり以前の自分は、すべての判断を下すのに十分なことを知らない。
こうして私たちは、 【トピック:埋め込み型世界モデル】 埋め込まれた世界モデルの問題へ、真正面から直面する。
本稿は、エイブラム・デムスキー(Abram Demski)とスコット・ギャラブラント(Scott Garrabrant)による埋め込みエージェンシー連載の一部である。続きはこちら!