
MIRIは、理論計算機科学の中でも、まだ十分に研究されていない一群の問題を専門とする非営利研究機関です。GiveDirectlyは、東アフリカの貧しい世帯にお金を渡す現金給付サービスです。これほど異なる組織の代表が、政策アナリスト、慈善家、哲学者、その他の人々と一堂に会するのは、どんな会議でしょうか。
Effective Altruism Globalは、まさにそんな会議です。数時間後にはオックスフォードでの会合が始まります。効果的利他主義(EA)は、科学の道具を使って世界の最も大きな問題に取り組みたいという関心を共有する、善をなそうとする人々の多様なコミュニティーです。GiveDirectly、Centre for Effective Altruism、慈善団体の評価を行うGiveWellのようなEA団体は、非営利分野の透明性と、人々を助ける効果について新たな基準を求め、大きな反響を呼んできました。
MIRIと効果的利他主義には、どんな関係があるのでしょうか。人工知能の安全性研究は、どのような意味で「利他主義」なのでしょうか。そして私たちは、今後数十年、この研究がコンピューター科学の極めて重要な分野になる可能性が高いと、なぜ考えているのでしょうか。以下で、それぞれに簡単に答えます。
MIRIと効果的利他主義
なぜMIRIはEAと結びついているのでしょうか。大きな理由は、どの仕事を優先するかを決めるとき、効果的利他主義者とMIRIが同じような基準を使っているからです。
人間より賢いAIシステムを有用で安全なものにするために必要な形式的な道具を開発する、というMIRIの使命は、科学技術の進歩が、これまでの歴史と同様、今後も人々の幸福を左右する最大の要因の一つになるという、大きな見取り図から来ています。したがって、知的労働の自動化は、よくも悪くも、とりわけ大きな影響を持つ研究になる可能性があります(「背景にある4つの主張」を参照)。そして、AIシステムの目標を私たちの価値観に沿わせるために必要な理論的な前提のうち、取り組みやすく、かつ手薄なものを見つけようとする中で、扱う未解決問題が決まります(「MIRIのアプローチ」を参照)。
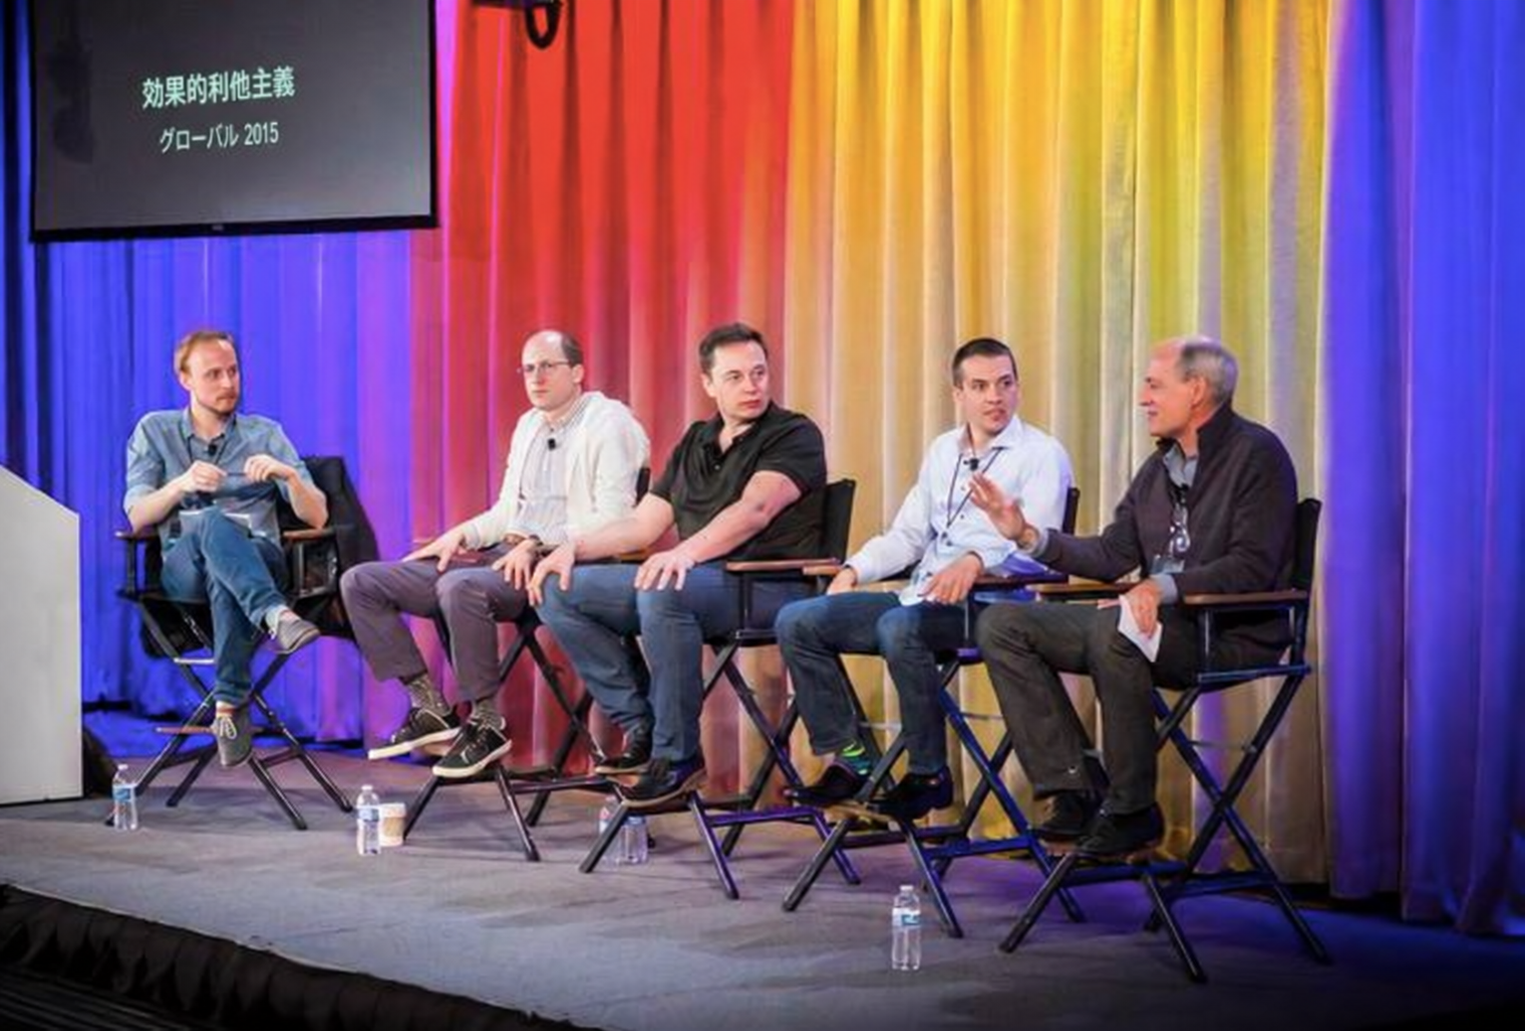
ダニエル・デューイ、ニック・ボストロム、イーロン・マスク、ネイト・ソアレス、スチュアート・ラッセルが
EA GlobalでAIリスクについて討論。撮影:ロビー・シェイド。
こうした基準で重要な活動分野や介入策を見つけようとする組織は、MIRIだけではありません。それらの組織は、まとまって行動することが、さらに大きな効果を生むのに役立つと分かってきました。メンバーが一つの活動分野に永久に固執しておらず、共通する考え方そのものを大切にしているため、資源を気軽に共有し、その考え方から次々と生まれる魅力的な案を、協力して広められます。こうして、効果的利他主義のコミュニティーが成り立っています。
こうした有益な交流の一例が、MIRIの前事務局長ルーク・ミュールハウザーが6月にMIRIを離れ、GiveWellから生まれたOpen Philanthropy Projectで、栄養学など、慈善活動の有望な機会になりうる分野を調べるようになったことです。((効果的利他主義は、遠い未来、動物福祉、世界の貧困、「メタ」という別々の分野に分けられることがありますが、この区分は以前から、やや人為的なものでした。貧困支援団体Giving What We Canの創設者トビー・オードは、人類の存続に関わるリスクを研究する主要な学者の一人で、Future of Humanity Instituteに所属しています。EAの中で動物保護運動を最も強く支持する一人、デイヴィッド・ピアースは、未来思想で最もよく知られています。ピーター・シンガーは、動物福祉とともに、世界の貧困への取り組みを早くから推進したことで有名です。「メタ」を重視するCenter for Applied Rationalityの事務局長アンナ・サラモンは、かつてMIRIの研究者でした。)) 一方、OpenPhilは、MIRIも参加した大規模なAI助成プログラムに資金を提供しています。
GiveWellとOpenPhilのスタッフからは、過去に非常に有益な批判的な意見をもらっており、長年にわたって多くの対話を重ねてきました(1、2、3、4、5)。彼らはMIRIよりずっと幅広いテーマを扱い、私たちの見方をすべて共有しているわけでもありません。それでも、「重要で、取り組みやすく、比較的手薄な」介入策を見つけたいという関心から、MIRIと重なる理由で、AIを調査すべき重要な分野に選びました。OpenPhilの世界規模の破局的リスクに関する3月の報告と、最近公開された高度な人工知能の潜在的リスクの概説をご覧ください。
EAに関わる人の大半は、AIリスク以外の分野で活動しています。人々の幸福にひときわ大きく貢献する有望な方法は、MIRIのアプローチだけでは決してありません。ただ、私たちはおおむねEAに沿った考慮に基づいて判断しようとしています。そのため、研究の進め方の理由を説明すると、EA的な哲学上の立場を勧めることにもなります。こうして、人々を助ける効果の大きな介入策を見つけたい、多くの人々との強い結びつきが生まれました。
被害が大きく、起こる確率も高いリスク
EAの活動分野をめぐっては、驚くほどよくある誤解があります。それは、世界の貧しい人々を苦しめる高確率の危機、人間以外の動物を苦しめる中程度の確率の危機、低確率の世界的破局、という3つに分かれるというものです。たとえばディラン・マシューズの最近のVox記事では、AI安全性やバイオセキュリティーに取り組む理由は、大惨事が起こる確率は非常に低くても、起こればあまりに悲惨だから、念のため調べる価値があるという議論なのだ、と想定されています。
これはMIRIの立場を誤解しています。Future of Humanity Instituteなどの組織で技術リスクに関心を持つ人々の立場も、そうだと思います。私たちは、価値観に沿わない自律AIシステムがもたらす存亡リスクは、防ぐために何もしなければ、起こる確率が高いと考えています。MIRIの活動を必要とする理由は、この見方に基づいています。AIのリスクが生じる可能性はごく低いと考えていたなら、AIアラインメント研究の優先順位を下げ、ほかの緊急の研究課題を優先するでしょう。
したがって、AI分野が今後どのように進むかについて私たちと大きく意見が違うEAの人は、AIリスク以外の分野で活動するだろうと考えています。「念のため」にMIRIへ寄付すべきだとは思いませんし、「パスカルの強盗」に基づく議論は退けています。「パスカルの強盗」とは、超指数関数的に巨大な便益が得られる無限小の確率に、誤って注意を集中する意思決定を指して、MIRIの研究者たちが作った名前です。((MIRIの上級研究員エリエゼル・ユドコウスキーが2013年に述べた言葉を引用します。
人類の存続に関わるリスクについては、あらゆる形のパスカル的な推論や、ごく小さな確率に大きな影響を掛ける考え方を、私は捨て、反駁し、支持しないと明言する。私たちが暮らすこの地球では、人間の知能の強化、分子ナノテクノロジー、十分に高度なバイオテクノロジー、ブレイン・コンピューター・インターフェース、そしてもちろん、さまざまな形の人工知能などの実現が見込まれている。あるものが世界の運命に影響する確率がごくわずかしかないなら、同じくらい大きな影響を、もっと高い確率でもたらす、そちらを心配すべき別のものがあるはずだ。[……]
明確にしておくと、「ごく小さな確率に大きな影響を掛けるな」という原則を私が当てはめるのは、大規模なプロジェクトや、歴史がたどりうる道筋だ。非常に大きな規模で見て、FAI[友好的AI]が世界を救う見込みは十分あると思うなら、人類はそこに多くの労力を投入すべきだし、誰も投入していないなら、あなたは今より多くの労力を注ぐべきだ。もっと小さな規模で、資金を必要とする2つの存亡リスク低減プロジェクトを比較するなら、次に労力を追加したときの限界的な効果を、ある程度見積もる必要がある。このときの効用単位、ユティロンを比べる共通の尺度は、おそらく救われる命の数ではなく、「よい結果に至る確率」、つまり最終的に幸福な銀河間文明が生まれる確率だろう。この場合、追加する1ドルが平均して増やせる確率は、ごく小さなものにすぎない。しかし、これはパスカルの賭けではない。成功か失敗かで評価する大規模な取り組みでは、小さな労力を1単位追加するごとの成功確率の増加が小さくなるのは、適切で、正当で、避けられないことだ。「よい結果に至る道筋全体」にごく小さな確率を割り当て、そのうえで、次の1単位の労力をそこに投じるか別の存亡リスクに振り向けるかという議論を、巨大な見返りを持ち出して封じるのであれば、それこそがパスカルの賭けになる。
))
スチュアート・ラッセルが書いているように、「どんな効用関数を選ぶかにかかわらず、意思決定の質を高めることが、AI研究の目標であり続けてきた。これは、いま年間数十億ドルを費やしている主流の目標であり、孤独な悪の天才の秘密の企みではない」。任意の認知課題で人間を上回るシステムを作ることを目指し、AIの汎用的な能力を高める研究に、何千人時もの労力が注がれています。
こうした取り組みがいつ成功するかは分かりません。しかし、いずれは成功すると予想しています。今後数十年かもしれず、今世紀中というのも十分にありそうです。自律AIシステムの安全性の保証を強めることで、長期的な世界規模の大惨事の確率を大きく下げながら、AIの進歩による利益をはるかに多く得られるでしょう。
人間より賢いAI技術を、確実に有益なものにするというMIRIの使命は野心的です。しかし、それは「地球温暖化を防ぐ」「工場式畜産を廃止する」といった目標と同じ種類の野心です。こうした目標に取り組むとは、通常、ほかの人々がその上に積み重ねられる、少しずつの進歩を実現することです。一回きりの宝くじを毎回xドル買うというより、子どもの大学進学資金として毎月の給料からxドルを積み立てることに近いのです。
ある特定の100ドルが、それだけで子どもの将来の仕事の見通しを大きく変える可能性は低くても、賢い投資ではありえます。温暖化対策をする一つの慈善団体だけで、問題全体を解決することはありません。だからといって寄付が無意味になるわけではありません。MIRIは小さな組織ですが、その仕事は、より頑健で透明性が高く、有益なAIシステムに向けた初期の進歩です。ほかの組織がさらに積み重ね、AIシステムの設計へ取り入れられるものです。((ニック・ボストロムもEA Globalで、同じようなことを指摘しました。個人の行動が決定的な違いを生む確率は低くても、AIは重要な活動分野だ、ということです。人工超知能に関する討論で、ボストロムは、AIリスクに影響を与えられる確率は、「高い」や「中程度」ではなく「低い」と述べました。マシューズらは、これを、ボストロムがAIを推測的な活動分野だと考えている意味に受け取ったようです。しかし、私が本人に意図を尋ねると、こう説明しました。
EA Globalで私が言いたかったのは、あなたが、つまり聴衆の誰であっても、AIによる破局から世界を救う確率は非常に小さいということだ。AIによる破局が起きる確率が小さいという意味ではない。だから、AIリスクへの取り組みは、大統領選挙の運動にボランティアで参加することに似ている。
))
ただし、AIによる破局は高確率だ、とだけ言って終わらせるのではなく、AI研究が現在の方向のまま進むなら、高確率だと言うべきでしょう。AI分野が、能力の研究とともにアラインメントの研究も主な重点に含める方向へ変われば、破局が起こる確率は、必ずしも高くありません。
私たちがこの分野の技術的な取り組みを重要だと考えるのは、AIによる大惨事が、起こりそうにないとも、避けられないとも考えていないからです。効果的利他主義を実践したい人の立場から、最も取り組むべきリスクは、何もしなければ近い将来に起こる可能性が高い一方で、自分たちが取り組み、既存の研究コミュニティーや科学機関を巻き込めば、その確率を大幅に下げられるものです。
こうした原則は、AI以外の分野にも当てはまります。現在、MIRIはAIアラインメントの長期的な技術研究を専門とする唯一の組織ですが、EAの根底にある原則を、何らかの形で実践しようとする、数多くの、そして増え続ける組織の一つでもあります。その意味で、世界をよくする最善の方法について意見が違っても、効果的利他主義者は結局、同じチームにいるのです。