
40年以上にわたり毎年開催されてきた国際機械学習会議(ICML)は、現代のAI研究で最も影響力のある会議の一つだ。今年ソウルで開催されるICMLでは、AIガバナンスの技術研究に関するワークショップ(TAIGR)が2回目を迎える。MIRIの技術ガバナンスチーム(TGT)からも、数人が7月に参加する。
この記事では、今年のTAIGRワークショップで取り上げられるTGTの論文6本を紹介する。1本目は、政府が対応を先延ばしするほどAIを統治する選択肢を失いかねないことを論じ、その選択肢を残すために今できる行動を提案する。2本目は、分散学習が計算資源を通じたガバナンスの選択肢をどれほど脅かすかを検討し、対策を示す。3本目はAI研究の制限を扱い、遵守の検証に役立ちうる30近い仕組みを取り上げる。残る3本は、信頼できない相手国を対象にする場合でも、政府がチップの使われ方を検証する助けとなる具体的な技術を扱う。チップ内のすべてを読み取らずに学習処理を検出する方法、クラスターに出入りするデータを監視する方法、そして検証のためにAIの推論を完全に再現できることを示す実証である。
閉じつつある機会の窓:政府はどのように高度なAIを抑制する力を失いうるか
ピーター・バーネット
AIの能力が高まるにつれて、政府はいずれ、開発者がさらに危険なモデルをつくることを防ごうと決めるかもしれない。しかし待ちすぎれば、新たな展開によって実効性のある制限が成り立たなくなるおそれがある。この論文は、ガバナンスを妨げかねない、十分ありうる展開を分析する。AI用ハードウェアの拡散、AIアルゴリズムの進歩、AIの研究開発を自動化する能力など、危険な能力をもつモデルの公開がそれに当たる。また、AIを統治する選択肢を維持するための速やかな行動も提案する。既存および新たに製造されるチップの追跡、頑健な検証技術の開発、米中間の情報共有の促進などだ。
分散学習は計算資源のガバナンスを損なうか?
ロビ・ラーマン
大規模言語モデルは通常、途方もない数のチップを備え、ネットワークで接続されたコンピュータクラスターで学習される。計算資源のガバナンスは、モデルの学習に使われた計算量にもとづいてAIを規制するため、ハードウェアの特定と監視を必要とする。だが、たとえばインターネット経由で接続された複数のクラスターに処理を分散させる分散学習によって、このガバナンスは損なわれるかもしれない。この問題に対して本論文は、(1)公表済みの機械学習実験にもとづいて分散学習の性能をシミュレーションし、(2)規制当局が追跡できないほど小規模なノードを使って大規模モデルを学習できるかを検証し、(3)検出方法を探る。
分析の結果、監視義務が生じないハードウェアを使っても、分散学習によって、現行または提案されているすべての計算量の閾値を超える、最先端水準のモデルをつくれることがわかった。たとえば、現在規制されている最も高い閾値である10^26 FLOPも、小規模ノードに分けて配置した40億ドル未満のハードウェアで超えられる。より低い閾値なら、さらに少ない費用でよい。最先端AIを開発する動機がある者にとって、この費用は好ましくはなくても、手が出ないほどではない。したがって、規制逃れを阻止することにはならない。頑健な規制には、チップの追跡、内部告発の制度、未登録ハードウェアへの制限といった対策を組み合わせる必要がある。
最先端AI研究への制限を検証する
アーロン・シャー
AIの進歩は主に、計算資源、アルゴリズム、データの3つの投入要素に依存している。能力開発競争を持続的に止めるには、その3つすべてを凍結することを目指すのかもしれない。この論文は、アルゴリズムを中心に、データもある程度扱う。具体的には、AIアルゴリズムの改善は機械学習研究を通じて生まれるので、AIの能力を長期にわたって制御するには、その研究を制限しなければならない。
この論文は特定の制限を推奨することなく、信頼関係が乏しい環境で、国家が遵守をどう検証できるかを分析する。国際的な捜索令状、AI学習コードの審査、通常の諜報活動の手段など、20を超える検証の選択肢を検討する。とくに、プライバシーとセキュリティを保ち、必要な場合にだけ人間の確認に回す、自動審査の可能性を強調している。内部告発者の保護は、取り組みやすい有望策として明確に浮かび上がる。実施が容易で、技術的な研究開発も必要ないからだ。
追加負荷ゼロのテレメトリで隠れた機械学習の訓練処理を検出する
ロビ・ラーマン、サビハ・タジダリ
MIRIの国際協定案を含め、計算資源のガバナンスについての提案の多くは、AIモデルの学習を制限するよう求めている。この種の規制は、物理シミュレーション、画像のレンダリング、学習済みAIモデルの実行、すなわち推論といった、強力なハードウェアの無害な使い方を制限するものではない。しかし開発者が学習処理を別の計算に偽装できれば、制限を逃れられる。
幸い、AIの学習に使われる高性能な画像処理装置(GPU)は、実行する処理によって振る舞いが異なる。その違いを利用すれば、チップの中身を読み取らなくても、学習と無害な利用を見分けられる。この研究では、メモリ使用量や消費電力などのハードウェア利用の特徴にもとづき、GPUが機械学習の学習処理に使われているかを検出する分類器を開発した。偽装された学習処理を検出できる分類器をつくる方法も述べている。
双方が信頼するプロセッサなしで、AIクラスターの全入出力にフィンガープリントを付ける
ナジ・チャンカヤ、ヤクブ・クリシ、ジョナサン・ン、ルーク・マークス、フェリックス・クリュッケル
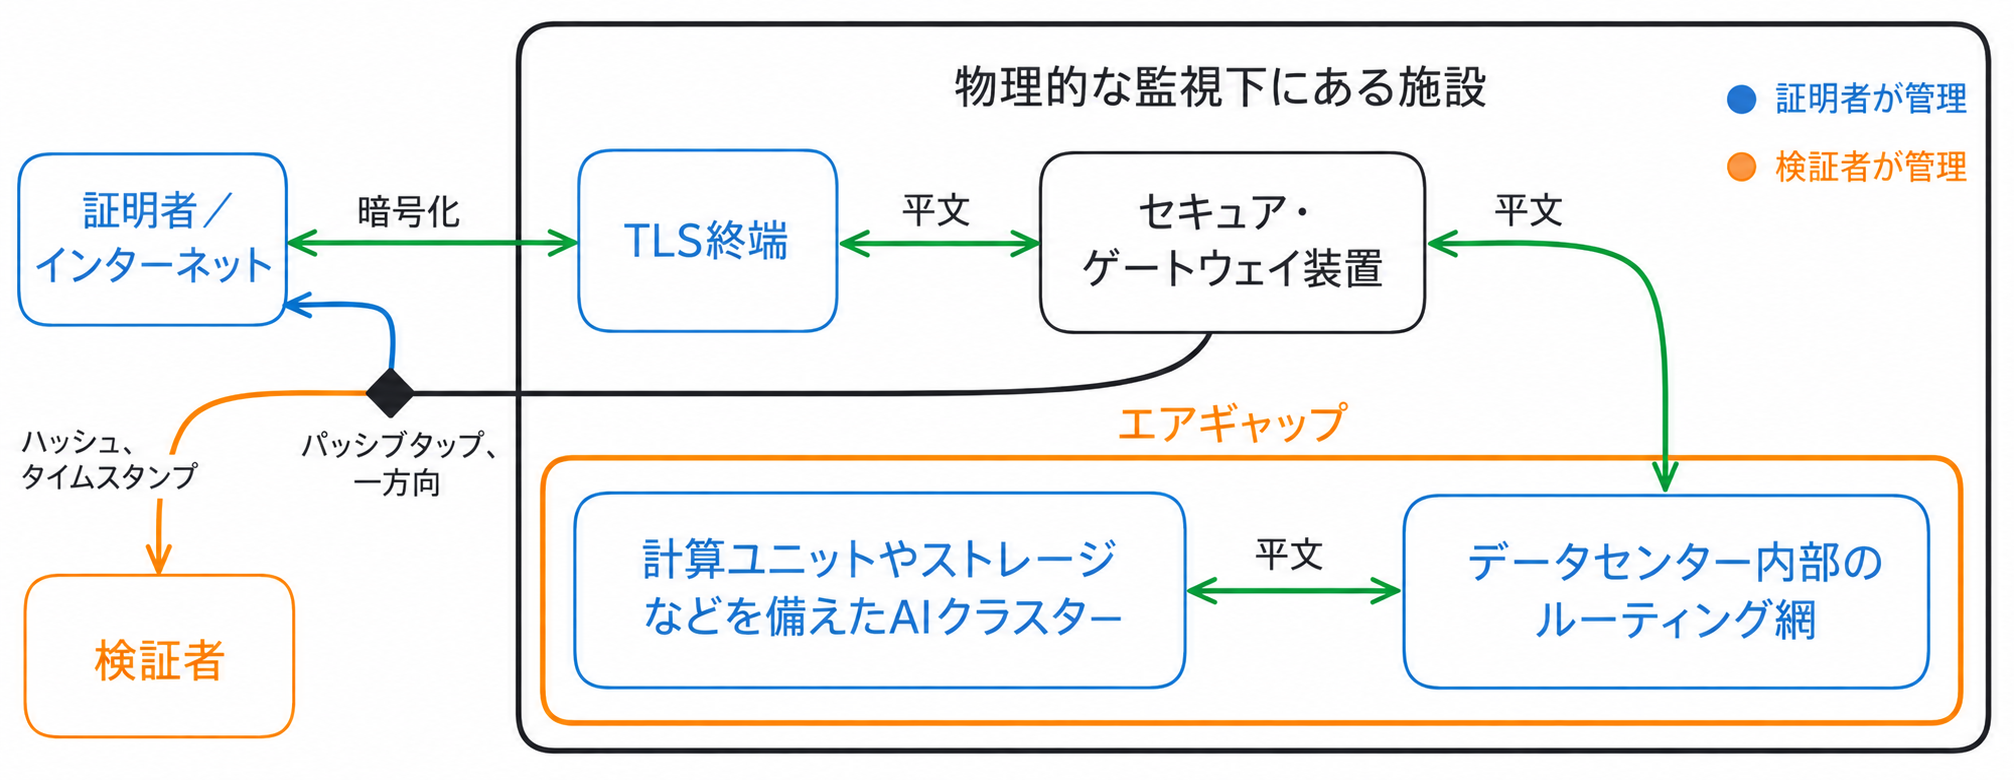
AIを制限する国際協定を実現するなら、AIデータセンターの検証基盤をつくり始める必要がある。監査者が検査するシステムを信頼しなくてもよく、データセンターの所有者も監査者を信頼しなくてよいようにするためだ。この論文が提案する解決策は、施設に出入りするすべての情報を記録し、さらに暗号化することである。
仕組みはこうだ。施設の内外へ情報を運ぶすべての配線から、関係者全員が構造を知っている「セキュア・ゲートウェイ装置」を使って情報を取り出す。提案された装置は、入出力データを効率よく処理して隠れ通信路を取り除き、それから分割してハッシュ化し、そのハッシュのコピーを検証のために施設外へ送る。監査者はデータ自体にはアクセスできないが、施設の所有者に入力をもう一度施設へ送るよう求め、ハッシュが一致することを確認できる。この仕組みによって、不正を行う者が違法な処理の結果を施設から取り出すことは、はるかに難しくなる。そして、施設が申告された処理だけを実行しているという確信が高まる。

性能を犠牲にせず、AI推論をビット単位で完全一致させて検証する
最優秀論文賞受賞。
ナジ・チャンカヤ
AIの国際的なガバナンスには、信頼関係が乏しく、規制逃れの動機もある環境で、監視対象のチップ上で何が実行されているかを検証する能力が必要だ。一つの選択肢は、施設所有者が使っていると申告したのと同じソフトウェアを使い、検証者側の機械で入力を再実行することだ。残念ながら、チップが行う浮動小数点演算は、常に同一の結果を生むとは限らない。計算記録を調べる監査者は、おおよその一致で妥協しなければならないが、その近似には、秘密の情報を埋め込むといった悪用の余地が残る。
この論文は、それでも十分な情報にもとづく方法なら、現代のAIシステム構成による出力を検証できると示している。一見ランダムな変動の大部分は、開発者によるハードウェアとソフトウェアの構成の違いから生じる。その違いを記録して再現すれば、見かけ上のランダム性を取り除ける。また、その違いは、開発者の構成を識別するフィンガープリントとしても使える。構成の詳細がわかれば、推論の出力を完全に再現でき、監査者側に同一のハードウェアを用意する必要もない。