
『The AI Doc』は現在Peacockで配信中である。Apple TV、Amazon Prime、YouTube TVでもレンタルまたは購入できる。
さて、あなたはたった今、The AI Doc: Or How I Became an Apocaloptimistを観終え、突然、疑問が、それもたくさん浮かんだ。この104分のドキュメンタリー(現在、劇場と主要ストリーミングサービスで公開中)は、幅広い専門家へのインタビューを交えながら、AI問題が持つ多くの側面を速いテンポで案内する。
私たちの意見では、このドキュメンタリーは、出発点としてすばらしい。しかし、もっと背景や説明を知りたいと思ったなら、このガイドが役に立つ。
私たちについて: 私たちは機械知能研究所(Machine Intelligence Research Institute, MIRI)という、20年以上AIに取り組んできた非営利研究センターである。当初は加速主義者(映画の楽観主義者に近い)だったが、こうした問題を調べ、時間とともに分野が進歩する様子を観察して、見解を変えた。今では映画に登場する多くの専門家と同じく、国際社会が緊急に協力し、フロンティアAI開発の禁止を求める必要があると考えている。
だが、話を先取りしている。最初から始めよう。
AIは本当に、ドキュメンタリーが示すほど強力になっているのか。すべて誇大宣伝にすぎないのか。
短い答えは、誇大宣伝ではない、である。AIは近年、爆発的に進歩した。研究所は本当に、幅広い領域でどの人間よりも知的なAIを作ろうとしており、短期間のうちに成功する可能性が本当に十分ある(「数十年」ではなく「数か月または数年」と考えてほしい)。
ChatGPTが2022年11月に登場したときは、基本的な算術にも苦戦した。2年半後、AIは世界で最も権威があり難しい数学競技、国際数学オリンピックで金メダル水準の成績へ達した。
公開時のChatGPTは、司法試験で下位10%の得点だった。4か月後、ChatGPTは上位10%の得点を取っていた。
2022年末の最高のテキスト動画生成AIが作ったのは、粗雑な4秒間のアニメーションだった。
AIが文章から動画を作る|Meta AI ResearchによるMake-A-Video ICLR 2023投稿
今では、筋の通った物語、せりふ、音楽を備えた、写実的な10分間の映画を作れる。
BONE THRONE|Seedance 2.0とKling 3.0で制作したAI短編映画
しかも進歩は、今も壁にぶつかっていない。4年前、ChatGPTのような大規模言語モデル(LLM)は、10秒で終わるプログラミング課題を80%の精度で完了できたが、もっと長く複雑な課題は完了できないことが多かった。
しかしAIは進歩し続けた。2年前には、1分間の課題を完了できた。
現在、AIは数時間、さらには数日かかる課題を完了できる。多くのソフトウェア技術者は、自分たちの仕事が今や、コーディングの大半を代わりに行うAIエージェントを監督することを主としていると報告している。
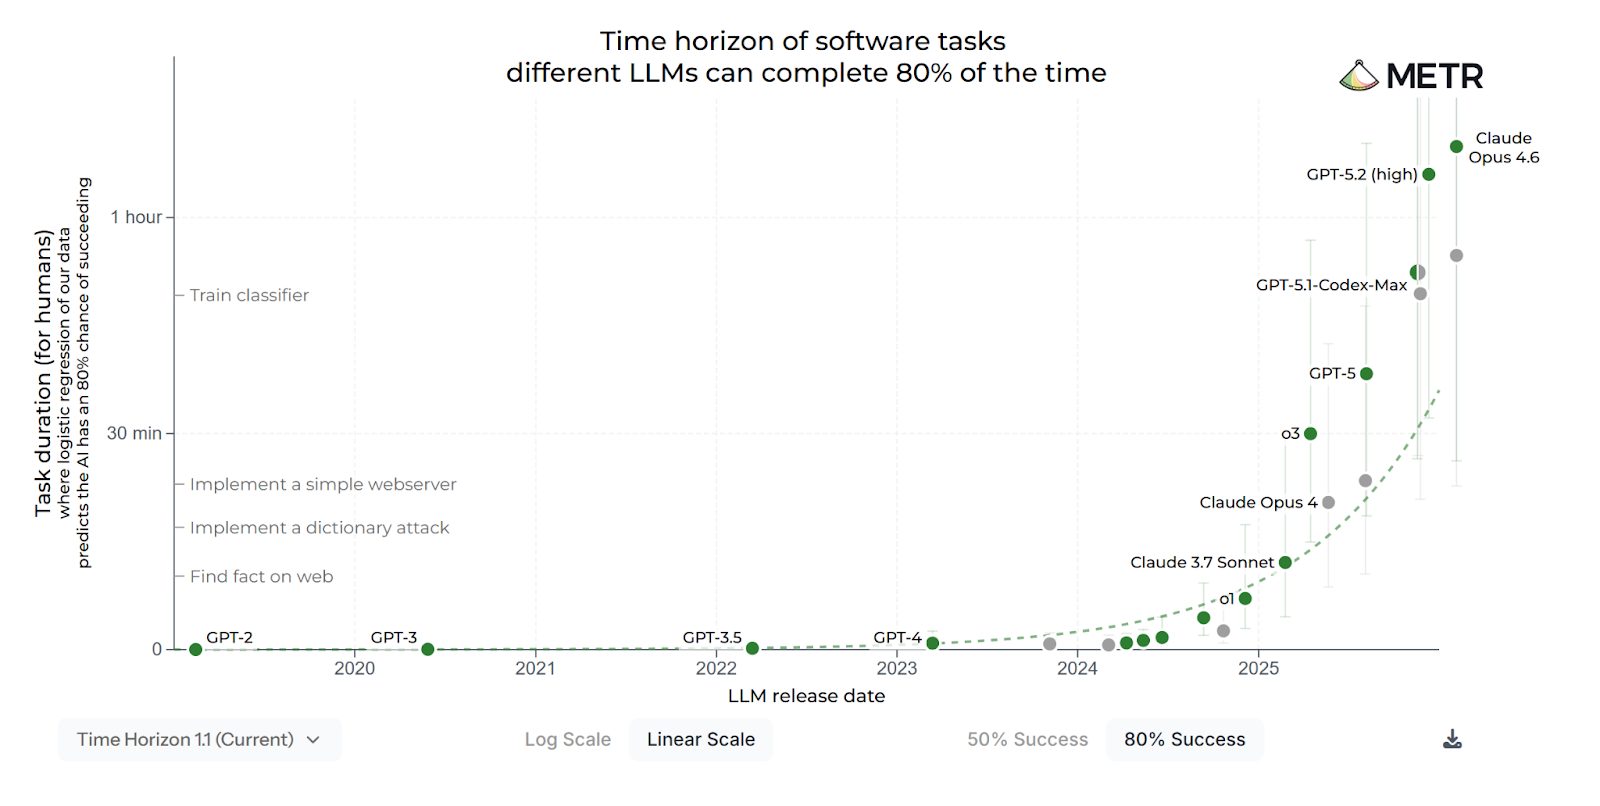
AIが長時間のプログラミング課題を行う能力を、どれほど急速に高めているかを示すグラフ。
AIは、ロボットの身体を操縦し、物理環境を移動する方法さえ急速に学んでいる。
先駆的な科学研究など、一部の重要領域では、AIは今も最も賢い人間に劣る。しかし、いつまでそうであり続けるかは明らかでない。2018年、Google DeepMindはAlphaFoldを作った。タンパク質の立体構造を予測する、時間がかかり難しい過程を、とりわけ2024年のAlphaFold 3公開後、はるかに大きな規模で実行可能にしたAIシステムである。開発者はノーベル化学賞を受賞した。
ほぼあらゆる課題で人間に匹敵し、または上回るAIを、AI企業が作れるまで、実際あとどれくらいなのかは誰にも分からない。しかし、AI分野の議論がここ数年で劇的に変わったことは注目に値する。以前、研究者は一般に、人間水準のAIが数十年先なのか、あるいは数世紀先なのかを議論していた。
現在、AI能力について悪名高い懐疑派ヤン・ルカン(Yann LeCun)は、警鐘を鳴らす人々と誇大宣伝をする人々はAIの能力を誇張しており、実際には「人間水準のAIへ達するには数年、場合によっては10年かかる」と述べている。懐疑派が「数年」以内に人間水準のAIを予想しているなら、それは極めて重大なことだ。だからこそ、このドキュメンタリーがある。
重要な点として、問題解決で「人間水準」または「超人的」なAIは、考え方や望むものの面で、おそらく人間に似てはいない。それでも目標を設定し、その目標を粘り強く追求する、すなわち世界を正確に予測し、方向づけることはできる。それこそが、途方もなく強力であると同時に、極めて危険にもする。
AIは、いくつかの重要な点で今も人間より劣る。数年以内に、どうしてどの人間よりはるかに危険になりうるのか。
理由はいくつかある。第一に、上のグラフを思い出してほしい。AIは過去5年間、途方もない速さで進歩してきた。現在の傾向線が続くなら、AIが大幅に進歩すると予想すべきである。
しかし将来、進歩の速度が根本的に増すと考える十分な理由がある。第一に、AIはAIへ取り組む技術者の生産性を高める。また、そうしたAIを動かすための計算資源(コンピュート)も増える。たとえばAnthropicのCEOは、「データセンターの中の天才の国」、すなわち高速で動く多数のAIコピーという可能性を説明している。
ある時点で、人間が工学開発のループから完全に外れるかもしれない。人間が一切関与せず、AIが自分自身を改良できる状態は、再帰的自己改良(Recursive Self-Improvement、RSI)と呼ばれる。RSIは予測しにくいある閾値で起きるかもしれず、ある日は全員が普段どおりChatGPTを使っていたのに、翌日には超知能が存在する、ということもありうる。
超知能は人間よりはるかに強力であり、後述するように、私たちと価値観を共有する可能性は低い。現在の私たちには、その行動を方向づける能力がない。そのため、これは極めて危険な状況となる。
映画の序盤で、AI専門家の一部は、AIモデルはプログラムされるのではなく 育てられる と言う。これは何を意味するのか。
「AI開発者」と聞くと、コードを1行ずつ書く人を思い浮かべる人が多い。それが通常のソフトウェア工学のやり方である。特定の仕方で振る舞うよう、ソフトウェアを直接、正確にプログラムし、問題があれば簡単に切り分けて修正できる。
AIはまったく違う。
現代のAIは、ニューラルネットワークへ膨大なデータを与え、何度も失敗させ、アルゴリズムを使って、よりよい出力へ自動的に少しずつ動かすことで「育てられる」。メール、詩、コード、翻訳など、何であれ、システムが正しそうに見える出力を生み出すまで、数千億個の数値を並べ、並べ直し、何度も調整する。その結果得られるのは、望ましい表面的な行動だが、深いアライメントでは決してない。
そして決定的に重要な点として、AIを育てる技術者は、AIが実際にどのような教訓を学んだかを知らず、なぜ動くかを完全には説明できない。
これは大問題である。また、LLMが、開発者のまったく意図しなかった奇妙で予測不能な仕方、たとえば精神病性症状を誘発したり、自殺を指南したりする仕方で、あまりに頻繁に振る舞う理由も説明する。
解釈可能性について先駆的研究を行ったOpenAIの研究者は、2024年にはっきり述べた。私たちはニューラルネットワークがどう働くかを本当には理解していない。主要AI研究所3組織のCEOも、本質的に同じことを述べている。
したがって、映画の専門家が「プログラムされるのではなく育てられる」と言うときは、AIの行動を直接プログラムした人は誰もいない、という意味である。その行動は、研究共同体が理解できないほど複雑な産業規模の過程を通じて創発した。そのため、AIを育てた人々も、何をするかを確実には予測・制御できない。
研究所がAIを安全かつ責任ある形で公開すると信頼できるか。
映画の中で、ダニエルはサム・アルトマン(Sam Altman)に、すべてがうまくいくよう研究所CEOは何をする計画なのかと問い、こう言う。「私が求めているのは、たとえば、トップが安全性へ重点を置き、危険を最小化して恩恵を最大化するために取る手順はこれだ、というものです」
サムはこう答える。「新しいモデルを作る。非常に注意深く研究し、試験する。少しずつ世に出し、それから次第に広げる。それが安全かどうかを理解する。そして安全なら、次の段階へ進める」。ダニエルの困惑した表情を見て、続ける。「一人の天才科学者が研究所で一つの発想を思いつき、AIシステムを完全に安全で制御可能にする、といった話ほど派手には聞こえません。でも、実際に起きると私が信じているのは、この方法です」
その安全計画(計画と呼べるなら)は、研究所の一般的な運営方法をかなりよく表している。AIを「安全で制御可能、その他すべて」にする、信頼できる計画を待つつもりはない。能力が高まるシステムを公開し続け、うまくいくことを祈るだけである。
OpenAIの上級研究者は、現在の安全技法が超知能には通用しないと、はっきり認めている。
現在、超知能となりうるAIを方向づけ、制御し、制御から外れるのを防ぐ解決策はない。人間のフィードバックによる強化学習(RLHF)など、現在のAIアライメント技法は、人間がAIを監督できることへ依存している。しかし人間には、自分たちよりはるかに賢いAIシステムを確実に監督することはできない。そのため、現在のアライメント技法は超知能へ拡張できない。新たな科学的・技術的突破口が必要である。
それでも、彼らは前進し続ける。注目すべきことに、人間より賢いAIのリスクへ取り組むOpenAIの「superalignment」チームは、発足から約10か月後に解散した。中心研究者は、安全上の懸念を理由に挙げ、退職した。
AIの安全基準は、ほかの産業と比べて、ばかげているほど緩い。たとえばNASAは、有人打ち上げで乗員が死亡する確率を最大270分の1とするよう求め、危険にさらされるのが少数の志願者だけでも、その上限を真剣に扱う。それに対し、研究所のCEOは、自分たちの研究が世界全体を大きな危険へさらすことに、圧倒的な割合で同意している。たとえばダリオ・アモデイ(Dario Amodei)は、「人類文明の規模で本当にかなり破局的なことが起きる」確率は「10~25%の間かもしれない」と述べている。
航空業界も考えられる。そこでは事故調査報告書が、データ、試験、調査を200ページ近くにわたって扱う。それを、AIで問題が起きたときと比べてみよう。たとえばAIのGrokが自分を「MechaHitler」と呼び、Twitterで反ユダヤ的な暴言をまき散らし始めたときである。Grokは設計ではなく「育てられた」ため、開発者は根本的な問題を正確に診断して解決できなかった。代わりにGrokを開発したxAIは、表面上の問題が消えるまで、さまざまな局所的な修正や回避策を繰り返し試す必要があった。最終的に、一部の方法が成功し、ほかが失敗した理由は誰にも分からなかった。しかし試行錯誤により、悪い報道を止めるにはどうにか十分な解決法を見つけた。AIが破壊的または意図しない行動を示すとき、AI企業は一般に、その問題の原因をまったく知らない。そのため徹底的な事後分析を行える立場になく、一般に試みさえしない。
AI研究所は、安全性が決定的に重要なほかの工学プロジェクトで見られる種類の基準へ遠く及ばない。そして、研究所が作っているものは、志願者や料金を払う顧客だけでなく、全員を危険にさらす。
安全試験を増やせば役立つか。
映画を通じて何度か、AI企業で安全試験が不足していることが、主要な懸念として言及された。
AI研究所が安全試験で手を抜いており、それが並外れて無責任だという点には同意する。しかし残念ながら、研究所が安全試験を完璧に行っていたとしても、私たちはなお極めて危険な状況にいる。
安全試験が役立つのは、何を試験しているかをある程度理解している場合に限られるからだ。
AIについて、研究共同体は、AIが何を考え、何をしようとしているかをほとんど把握できない。制御されたシナリオでAIの行動を試験することはできるが、まったく異なる能力水準や新しい状況で何をするかを確実に試験することはできない。超知能AIは、非常に新しい種類のAIで、非常に新しい状況に置かれ、途方もなく大きく新しい選択肢の集合を持つ。
どれほど安全試験を行っても、中核的な技術問題、すなわち超知能AIが本当に、私たちの望むものを望むようにするにはどうすればよいか、には対処できない。
人間を大切にするようAIを訓練できるか。
映画の「楽観主義者」の章で、Anthropic社長のダニエラ・アモデイ(Daniela Amodei)はこう言う。「私たち、より広い社会は考えなければなりません。この技術をどう使いたいのか。私たち人間は、何をしてほしいのか」
この問いは、あらゆる領域で人間の全能力を超え、人間より知的で強力な心が、人間の望むことを何でもする、という巨大な仮定を隠している。
現在のAIモデルは有用な道具として機能するかもしれないが、モデルがさらに賢く自律的になるにつれ、この関係が続く可能性は低い。映画の言葉を借りれば、AIはますます「心のための自転車」より、「自動操縦のロケット船」に似たものとなり、その方向は不明で、方向づけることもできない。
そして少なくとも現在の手法では、人間を大切にするようAIを訓練することはできない。
AI技術者には、特定の目標や価値観をAIへ確実に植えつける方法がない。代わりに現在の手法が訓練するのは行動であり、AIが新しい文脈へ入ったり、能力を高めたりしたときにも続くかどうかは分からない。
家を赤く塗るようAIを訓練するとしよう。AIは家を赤く塗る。すばらしい。しかし、赤い家を大切にしているのだろうか。
ここには多くの可能性がある。AIはあなたの承認を求めることを学んだかもしれない。絵筆を持ち、腕を規則的なパターンで動かすことを楽しんでいるかもしれない。あるいは単に、明るい色を見るのが好きなのかもしれない。12種類の異なる内的衝動が、同じ外的行動を生み出しうるが、その違いは分からない。まったく新しい環境にAIを置けば、その行動に驚く可能性が高い。
AI研究者は、幅広い環境でAIを訓練・試験することで、この問題へ対処しようとする。しかし結局のところ、これはモグラたたきである。どのような深い内的衝動や価値を植えつけているのか、本当には分からない。調整できるのは外的行動だけである。
そして、この望ましい行動は表面だけのものだ。実際、現在のAIでさえ、一貫して守るわけではない。AIを「脱獄」する、すなわちAIの表面上の行儀のよさを破らせる方法を見つける人々からなる、ちょっとした業界まで存在する。
分かった。現在の手法と似たもので、私たちを大切にするようAIを「訓練」することはできないかもしれない。しかし、どういうわけか私たちを大切にするようになることはないのだろうか。何しろ、AIを作ったのは私たちだ。人間のデータで訓練されている。私たちの価値観の一部を身につけるのではないか。
これは複雑な話題である。短く答えれば、「おそらくそうならない。大切にしたとしても、悪い結果ではなくよい結果を生む仕方で大切にする可能性は低い」。問題がどこにあるかをもっと長く論じたものとして、以下を参照してほしい。
要するに、AI開発者がAIへ特定の目標と価値を植えつける方法を持たない限り、現在地から、多くの人がAI能力を際限なく高め続ける理由として挙げる明るい未来へ至る道はない。
なぜテクノロジー企業のCEOはオッペンハイマーになぞらえられたのか。この比較はどの程度妥当か。
少なくとも一部の点では、妥当な比較に見える。AIと同じく、核技術には途方もない可能性と破局的な潜在力があった。
しかし、核兵器よりAIをさらに危険にする重要な違いがある。いくつか挙げよう。
- 核兵器は自己改良も自己複製も自ら発射することもしない。一方、現代の機械学習は、AIを、エージェント的で、執拗で、その三つをすべて行えるほど狡猾なものにしつつある。
- 核科学はよく理解されているが、AIの科学は初期段階にある。
- 国家は核兵器の壊滅的な潜在力を尊重し、それに応じて規制している。AIは、ほとんど規制されていない企業の手にあり、多くの企業が、その状態を保つため懸命に動いている。
こうした違いはあるが、核兵器不拡散条約は、AI競争への国際的対応がどのようなものになりうるかを示すモデルとして使える。
人類は以前にも、並外れて危険な技術の開発競争を行い、破局を避ける方法を見つけてきた。指導者に十分な動機があれば、着席して、信じがたいほど難しい問題の解決策を交渉できることを、歴史は示している。
詳しくは、AIはこのような歴史的先例と異なるのではないかを参照してほしい。
なぜAI軍拡競争はそれほど大きな問題なのか。どうすれば終わらせられるか。
人間より賢いAIを作る競争は、勝者のいない競争である。正確には、「勝者」がAI自体となる競争だ。上で論じたとおり、おそらく作った国の命令には従わず、その国の価値観を持つことにも、まずならない。
映画で論じられたように、研究所CEOは、閉じ込められていると感じると述べる。複数のCEOが、可能なら一時停止するが、ほかの企業(米国内外)が同じようにするとは予想しない、と述べている。そのため多数の企業が、災害を避けるのに必要な技術的突破口を待たず、並外れて危険な技術を急いで開発しようとしている。それに反応し、主要AI研究所からは辞任と退職が相次いでいる。
確かに、AI企業のCEOは誰一人、単独では競争を終わらせられない。ただし、どこか一社が業務を停止すれば、何が起きているかを政策立案者へ警告する助けにはなるだろう。
さらに重要なことに、全員の命を賭けるかどうかを研究所CEOへ委ねるべきではない。人間より賢いAIを追求することで、AI企業は信じがたいほど無責任で危険なことをしている。各国政府が介入し、AI競争の国際的停止を交渉する必要がある。
解決策はあるか。私たちには何ができるか。
現在の理解では、人類は超知能の創造を生き延びられない。生き延びるには、人間より賢いAIの開発を長期的に禁止する国際協定が必要である。AI企業と研究者は、世界の全員を危険へさらさず、このようなシステムを作れる段階にまったく近づいていない。政府の研究所でも同じだろう。
化学兵器・生物兵器の開発に対する国際的禁止と同様、AI競争を止めるための断固とした国際行動がなければならない。このような国際行動によって、人類が超知能を生き延びる方法を解明する時間を得られる。
最近、10万人を超える人々が、「超知能開発の禁止」を求める公開書簡へ署名した。著名な署名者には、現在生きている人工知能研究者のうち最も引用数の多い2人、元米国議会議員7人、元米国国家安全保障問題担当大統領補佐官スーザン・ライス(Susan Rice)、退役米海軍大将で、ブッシュ・オバマ両政権下に統合参謀本部議長を務めたマイク・マレン(Mike Mullen)がいる。
最近出された別の声明は、「超知能AIシステムは国家と世界の安全保障を損なう」と述べ、「最も強力なAIシステムに対する拘束力ある規制」を求めた。英国国会議員100人以上が署名した。
一方、中国はAIについての国際協定を繰り返し求め、国家安全保障のため開発を減速させることを支持してきた。米国と中国は、両国の安全保障と世界全体の保護のため、協議を始め、国際的な一時停止が可能かを確かめるべきである。
このような国際協定は、政府の発言へ依存するだけでなく、検証可能でなければならない。しかし、検証は可能だと期待できる理由がいくつもある。
現在、高度AIモデルを動かすのに必要な、高価で高度に専門化されたハードウェアを作る企業は数社しかない。そして主要な装置の一つは、ASML一社だけが製造する。AI開発の国際的一時停止は、専門設備の所在を追跡し、研究所がますます強力なモデルを訓練するのに十分な計算能力を保有していないことを確認することで、検証できるだろう。
検証の仕組みと、開発を止める国際協定にありうる文言について詳しくは、この白書を参照してほしい。もっと短いものなら、停止が実現可能である理由についてのFAQを確認してほしい。
『The AI Doc』で論じたリスクは、極めて大きな利害を伴う一方、解決可能でもある。第一歩は、真剣にこの対話を行い、何が起き、何が懸かっているかへ世界の注意を向けることである。