
この記事はMIRI Single Author Seriesの一編です。このシリーズの記事は、記名された著者の信念や意見を表しており、MIRI全体の見解を代弁するものではありません。
有望なソフトウェアエンジニアから、何度かこう尋ねられました。最先端のAI研究所で働くべきでしょうか。
私の答えは、いつも「いいえ」です。
この記事では、最先端のAI研究所の根本的な問題と、そこで働くことを支持するよくある議論を取り上げ、なぜ私が納得しないのかを説明します。
根本的な問題
OpenAI、Anthropic、Meta、Google DeepMindなど、最先端のAI研究所が主に生み出しているのは、最先端モデルの能力向上を加速し、人間を超える機械の登場を早める研究です。アラインメントをどれほど重視するかは研究所ごとに違いますが、難しい問題を解く見通しも、こうした機械が人間の生存と取り返しのつかないほど両立しなくなるのを防ぐ見通しも、どこにも立っていません。確実なアラインメントの手順がないまま最先端の能力研究を進めることは、人類の滅亡を早めます。よほどの例外がない限り、その研究を手伝うために加わるのは、人が犯しうる最も重大な過ちの一つだと私は考えます。
研究者を目指す人の中には、こう反論する人もいます。「それは分かっています。でも、最先端モデルの安全性を研究したいのです。能力向上に直接関わる仕事は断ります」。こうした計画は立派なものですが、規模拡大を進める研究所の優先順位やインセンティブを、大きく誤解しています。問題は、能力研究を無理にさせられることではありません。研究所で行われる安全性の仕事の大半が、アラインメントの難問には対処できない一方、規模拡大を続ける助けや言い訳になることです。
あなたも同化される
AI研究所には、機械学習の最前線を押し広げるよう、組織として圧倒的な圧力がかかっています。この圧力は、職員の考えること、すること、言うことのすべてを歪めかねません。
OpenAIで研究科学者を務めていたリチャード・ンゴは、その影響に自ら気づきました。
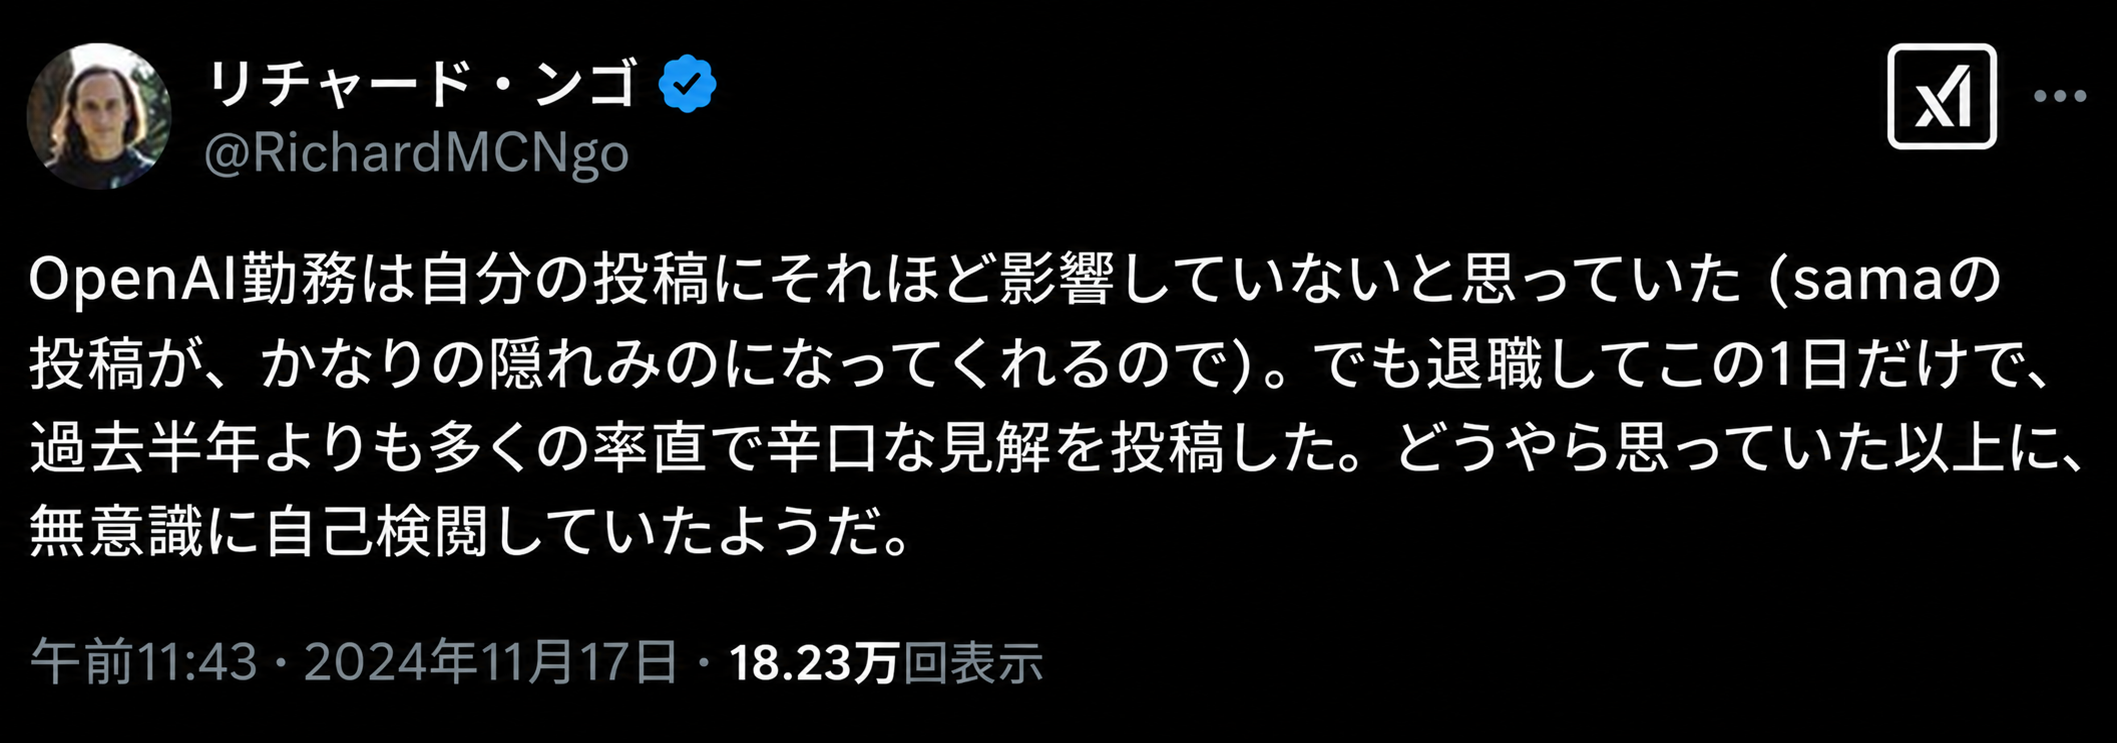
この歪みは、研究の方向にはさらに強く作用します。そんなつもりは一切なくても、安全性に取り組んでいるという見せかけを作る「セーフティーウォッシュ」に陥るのは、恐ろしいほど簡単です。
アラインメント研究と能力研究の重なりが、その影響をさらに強めます。短期的に機械学習モデルの出力を理解・制御する取り組みの多くは、次の製品モデルの改善に利用できるだけでなく、実際にすぐ、そうした形で使われることがよくあります。
- 人間のフィードバックによる強化学習(RLHF)は、商品になるチャットボットにとって大きな突破口でした。
- アラインメント計画によく組み込まれる、規模を拡大できる監督手法は、根本的に、アラインメントが未解決のまま、人間の研究者と同等以上のAIを作ることに依存しています。
- 危険になりうる能力の評価さえ、売り物になる性能向上を目指し、その評価結果を指標としてモデルを少しずつ最適化するために使われかねません。
機械論的解釈可能性には有望な用途もありますが、一部で主張されるような解決策ではありません。また、アルゴリズムの改良を着想するために使われる危険もあります。将来の解釈可能性の研究が、ニューラルネットワークの働きを人間に深く理解できるようにするほど、それはアラインメント研究に限らない効率向上にも使えるのです。
ここは誤解しないでください。再帰的な自己改良によって超知能に到達することが、すべての最先端AI研究所にとって、戦略上の最優先目標です。この目標に貢献しない研究は強く淘汰され、金銭的なインセンティブは、盲目的に規模を拡大した長期的な結果を軽く扱う方向へ、強く働きます。
いまのところ、どの研究所にも、よい結果に至る見込みが十分にあるとは思えません。誰の計画が最も有望に見えるか、と尋ねられたこともありますが、問い方が間違っていると思います。滅亡を防ぐ計画は、そもそも存在する場合でさえ、どれもひどいものです。もっとよい問いは、誰なら自分たちの取り組みが失敗していると気づき、理解が進むまで盲目的な規模拡大をやめられるか、です。大切なのはこの試験であり、大手研究所はすべて、見るも無残に失格しています。
そこに加われば、あなたもおそらくそうなるでしょう。
そこで働くことを支持する議論
以上を踏まえても、AI研究所への就職を、差し引きで有益なものにする理由はあるでしょうか。ここでは、私が聞いた中で、最先端研究所で働くことを支持する最も強い議論に答えてみます。
研究所では、有用なアラインメントの知見が得られるかもしれない
主張:大手研究所で働けば、ほかでは得にくい研究の機会がある。最先端モデルをいじれること、優秀な研究者が集まっていること、計算資源を使えることから、AIが超知能へと拡大する前にアラインメントに取り組むには、最先端研究所が最適な場所だ。
私の評価:AnthropicやDeepMindなどの研究所は、確かに「Alignment Faking in Large Language Models」のような画期的な研究や、世界の解釈可能性研究の大きな部分を担っていることを、評価されるべきです。
こうした研究があるのは、うれしいことです。ほかの条件が同じなら、もっと増えてほしいと思います。しかし、ほかの条件は同じではありません。AIをもっと強力にすることには、比較にならないほど多くの労力が注がれています。そして、この種の研究を能力向上に使えるなら、研究所で行われた場合には、実際に能力向上に使われます。
彼らのアラインメントへの取り組みは、少なすぎ、遅すぎるように見えます。人間より賢いAIをアラインさせる実行可能な方法を示した研究所は、一つもありません。人間より賢いAIを手にする前に、その欠落を埋められるとも思えません。既存の安全性の枠組みには、不合理なほどの自信が前提になっています。
研究者がもう一人加わったとしても、こうした見込みを大きく改善できるとは思いません。巧妙なものも露骨なものも含め、のしかかるインセンティブの重圧に抵抗できたとしてもです。
また、選んだ組織が重要なアラインメントの知見を得たとしても、それを社外に持ち出さないよう、厳しい拘束力のある契約に縛られている可能性を忘れないでください。
研究所が規模を拡大するにつれ、モデルが破局を招くほど危険になる可能性は高まります。単に動く超知能よりも、アラインされた超知能を得るには、はるかに多くの資源が必要ですが、主要な研究所は、その大半を前者に注いでいます。崖がどこにあるか分からず、知ることもできない以上、こうした仕事は全体として無責任であり、行われるべきではありません。
内部にいれば、内部告発しやすい
主張:研究の秘密性と重要性が増し、公開されないモデルが社内で使われるようになるほど、安全性の研究者にも一般の人々にも、転換点に達した時期が分かりにくくなる。危機的な瞬間に警鐘を鳴らせる人材を、内部に残しておくことは、コミュニティー全体に価値があるかもしれない。
私の評価:急激な能力向上や支配の奪取が目前に迫った兆候があれば、誰かが警告できる立場にいるべきだ、という考えには共感します。しかし、この計画の有効性には、大きく3つの理由から疑問があります。
- 情報へのアクセスは職位や在籍歴によって制限される。
- 機会は一度しかない。
- 警鐘には明瞭さが必要だ。
情報へのアクセスは職位や在籍歴によって制限される。 研究所は情報漏えいのリスクを強く意識しており、重要情報を上級研究者だけに見せるだろうと私は考えています。事態の重大性が高まるほど、アクセス制限も厳しくなるでしょう。すでに内部にいる人の中には、差し迫った危険を見つけたら告発するつもりだと、私的に述べる人もいます。あなたが、その人たち以上に情報へアクセスできる可能性は低いでしょう。こうした研究所の大半は、安全を重視する人々が設立したのであり、その全員が去ったわけでも、業界の圧力に完全に屈したわけでもないことを、思い出してください。
機会は一度しかない。 内部告発は非常に価値ある行為ですが、普通は繰り返せるものではありません。法規制によって、告発者と分かっている人を解雇することは防げても、機微な研究から遠ざけられる可能性は高いでしょう。つまり、告発しようとする人は、限られた持ち札を、いつ、どう使うかを極めて慎重に考える必要があります。その結果、警告を先延ばしにして、意味がなくなるほど手遅れになるかもしれません。
警鐘には明瞭さが必要だ。 一つの明確な転換点があるとは限りません。危険を見抜く目があれば、最先端の研究所が超知能を無謀に追求し、途方もないリスクを負っている証拠は、すでに山ほどあります。これだけ強い証拠がある中で、政策担当者や一般の人々が、何を決定的な証拠とみなすかは分かりません。つまり、告発を考える人は、自分には明白な不正の証拠でも、外部の人には十分伝わらないかもしれない、危険なチキンレースを強いられるのです。
このアプローチには、もう少し控えめで、支持できるかもしれない形もあります。たとえば、進歩の動向を把握し、重要な進展を仲間にひそかに知らせるつもりで、AI研究所に応募することです。しかし、そうした道の利益はさらに疑わしく、影響力は、地位、情報開示の制限、実際に共有できる知識の価値によって制約されたままでしょう。
すでに最先端の研究所で働いている場合も、私は方向転換を勧めます。この判断や関連する判断の助けとなる、AI Lab Watchという窓口があることも知っておいてください。
内部にいれば、研究所の行動を変えやすい
主張:研究所の内部で働けば、安全性を重視する個人が、その研究所の意思決定の方向に影響できる立場を得られる。
私の評価:この主張をできるだけ強い形に組み立てるのは、正直、難しく感じます。いまこの分野に入る個人が、研究所の内部から人間を超えるAIの開発を遅らせる、意味のある立場につけるとは思えないからです。
ペースを決めるのは、最も無謀な運転手です。OpenAIで働き、妥当に「安全性重視」と呼べたであろう人々の多くは、偏りを避け、ほかでもっとよい仕事をするため、あるいは十分な支援を受けられなかったためなど、さまざまな理由で結局去りました。残っている人々の職業上の信用や影響力にも余裕はなく、立場を保つためには、それを慎重に使う必要があります。
規模拡大を進める研究所を内部から効果的に方向づけるには、次のことが必要です。
- すでに加速主義の考え方に取り込まれた組織で、影響力のある立場を得る。
- 自分自身は取り込まれないようにする。
- 組織全体を、経済的なインセンティブに逆らう方向へ動かす。
- その結果として起こる反発に、違いを生むまで十分長く耐える。
私には、この勝負はすでに行われ、インセンティブが勝ったことが明らかに思えます。
研究所では実務経験が得られる
主張:規模拡大を進める研究所で働くことは、機械学習の専門知識を得る最善の方法だ。[それを後で、アラインメント問題の解決に生かせる。]
私の評価:私も以前はこの議論を信じていました。同僚から、その仕事に就くための基準がどれほど高いかを指摘されるまではです。いま、最先端のAI研究所で機械学習の研究者として採用されるなら、あなたには、ほかの場所で質の高い研究をする力が、すでに備わっている可能性が高いのです。
AI研究所の採用競争は世界でも屈指の激しさで、組織の階層やチーム構成は混乱し、人の入れ替わりも多く、直接指導してもらえる機会は限られます。能力を身につけるのに、よい環境ではありません。
ほかの人が入るより、私のほうがよい
主張: 私が最先端の研究所で働かなければ、別の人が働く。自分と同水準の普通の機械学習エンジニアよりは、私は安全性を重視しているはずだ。だから、その差の分だけよくできる。それが、自分に無理なく期待できる最大の貢献だ。
私の評価: この議論は、主に3つの仮定に基づいているようです。
- あなたは別の機械学習エンジニアよりよい仕事はしないので、あなたが加わっても、最先端の能力が意味のあるほど向上することはない。
- あなたが加わることで、安全性は意味のあるほど向上する。
- 政策には望みがない。研究所の外では、人類の生存の見込みを改善する、もっとよい方法はない。
1つ目は本当かもしれません。ただ、自分が仕事をうまくやりすぎないことに人類の未来がかかっているかもしれない状況には、私は身を置きたくありません。
2つ目には、当然、次の問いが生じます。どうやって安全性を高めるのでしょうか。すでに簡単に述べたように、最先端の研究所で安全性を高める機会の大半は、それほど有望ではありません。アラインメント研究には、事業と製品の短期的な要請に応える強い圧力がかかります。内部告発の機会は、よくてもまれです。インセンティブに逆らって研究所の方向を変えようとした人々も、うまくいきませんでした。
3つ目は、単に避けられる判断ミスです。多くの政策担当者は、非公開の場で真剣な懸念を表明し、米国民も大半がAI規制を支持しています。現実の危機も、危機だと認識されることも、急速な変化を引き起こしえます。世界的な開発停止は実現困難だと切り捨てるのは、愚かで自分の目的を損なう判断です。私たちは、もっと賢明に判断できるし、そうすべきです。
代わりに何をすればよいか
いま最も緊急で手薄な問題は、政策と技術的ガバナンスにあります。賢く、問題意識を持った人々が、何がうまくいきそうかを考え、実行の機会が訪れる日に備えて、具体案を用意する必要があります。関心があれば、AI Futures Project、MIRI、Palisade、NIST、RAND、AISI、その他の技術人材を必要とする政策重視の組織への応募を考えてみてください。
一方、すでに持つ機械学習の技能を、リスクを少しでも下げるプロジェクトに生かしたいなら、METR、Apollo Research、Timaeus、Simplex、Redwood、ARCなどを検討できます。ジェイコブ・スタインハートの研究や、英国ARIAでのDavidadの研究から着想を得たり、支援する方法を探したりしてもよいでしょう。
ただし、どんな技能を持っていても、AGIを作ることを明示的に目指す組織は避ける、というのが私の助言です。