
この記事はMIRI単著シリーズの一篇である。このシリーズの記事は、署名した著者個人の信念や意見を表すものであり、MIRI全体を代表すると主張するものではない。
OpenAIは最近、AIの安全性とアライメントについての同社の考えを伝える新しいウェブページを公開した。これをつくったことは評価したい。超知能の開発を競う企業は、それが全員を殺してしまうのかという公の議論に、もっと積極的に参加すべきだからだ。ページの末尾で、異論をもつ人からの意見を求めていることも評価している。
私は同社の戦略だけでなく、その戦略の伝え方にも異論がある。この2種類の異論は、切り離しにくい。主に伝えたいのは、次の3点だ。
- このページが伝えるAGI開発の速度の見通しは、混乱を招く。OpenAIは、自分たちが何を信じているのかを、もっと明確にすべきだと思う。
- アライメントについての議論では、OpenAI自身が以前には明示的に認めていた重要な論点が見過ごされている。これらにもっと正面から答えるべきだと思う。
- 超知能が全員を殺すのを防ぐというOpenAIの計画は、証明されていない仮定に頼っている。その仮定を証明する責任を引き受けるべきだと思う。
1. AIの実現時期をめぐる二枚舌
最初の節では、AGI開発の速度の見通しを変えたと述べている。今では「非連続的」な一瞬ではなく、「連続的」な過程になると予想しているという。だが、それはどういう意味なのか。
AIの将来予測の議論では、「連続的」は通常、今後の進歩が、過去のデータから外挿した傾向線と整合することを意味する。
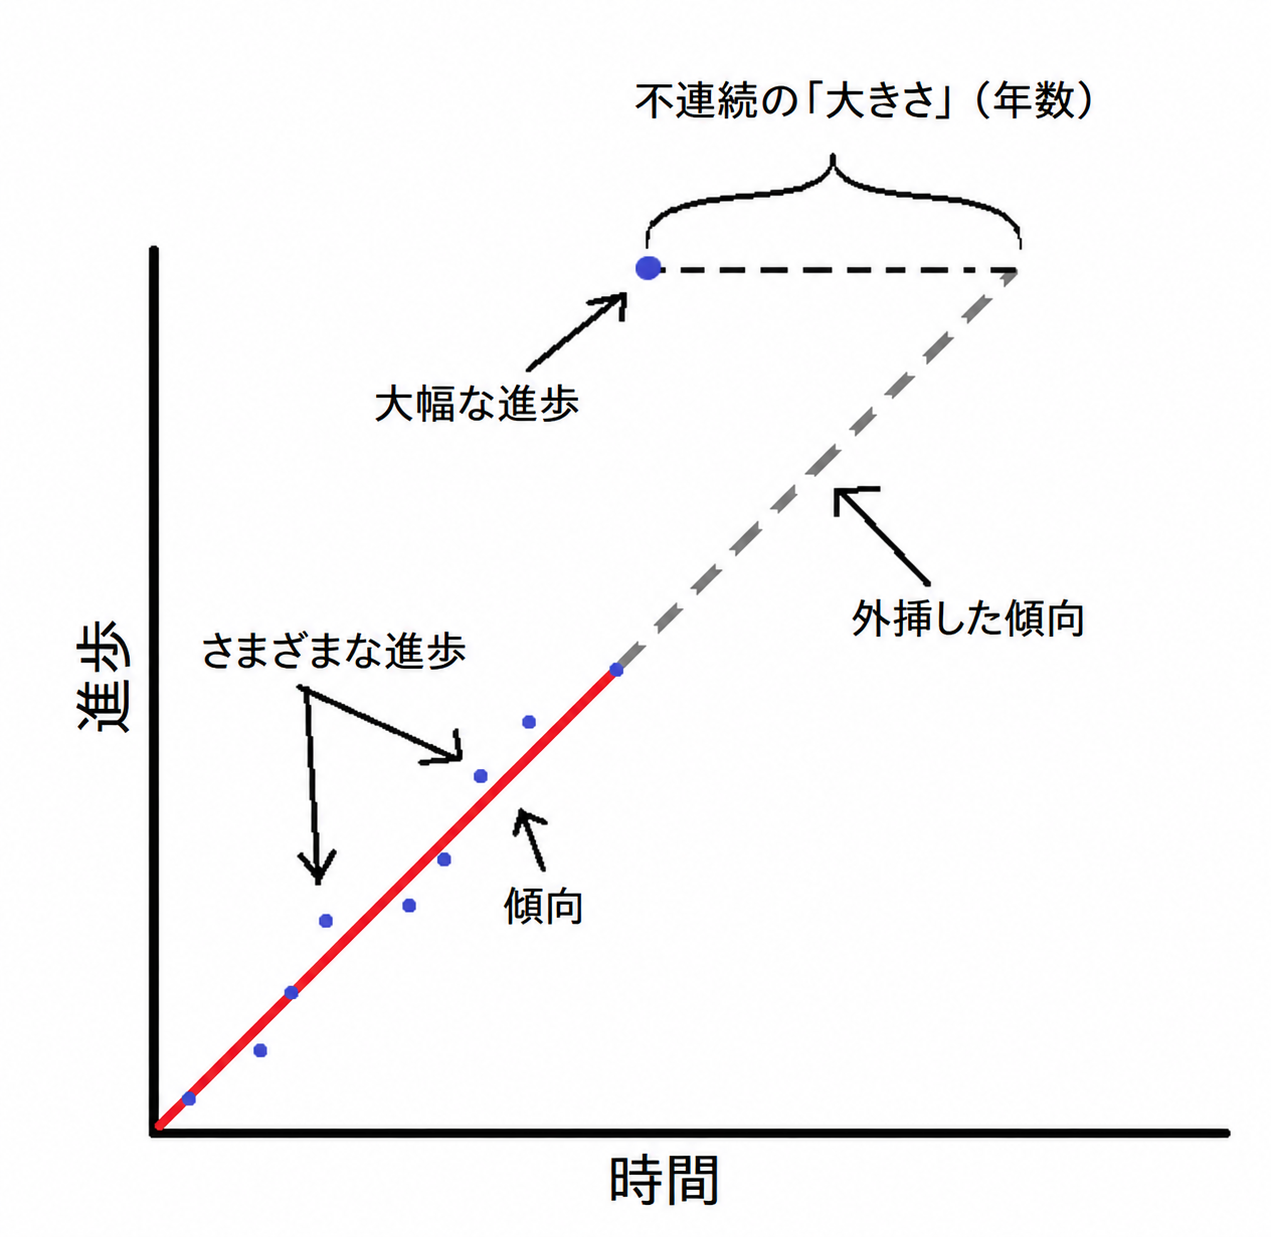
AI予測では、新しい観測が過去のデータから外挿される傾向と整合するなら、進歩は連続的である。(AI Impacts)
OpenAIの言う「連続的」も、この意味なのだろうか。そうかもしれないが、文脈からすると少しおかしい。第2節によれば、同社は数年以内に、AIが世界を「現在と1500年代の違い以上に、現在の世界とは異なる」ものへと変え始めると予想している。これは実は、妥当な予測だと私も思う。ただし、既存の傾向線を単純に延ばしたものではなく、再帰的自己改善のような新たな過程に依存する予測だ。
さらにOpenAIによれば、世界が「連続的」であることは、反復と試行錯誤による同社のアライメント手法を、より楽観してよい理由だという。しかし、予測できるのが「とんでもない状況になる」ということなら、予測可能だというだけで安全になるわけではない!
「連続的」な世界のほうが安全で扱いやすいと言うのは、この言葉を「遅く、緩やか」といった意味で誤用しているからかもしれない。それでも驚きはしない。「連続的」についてのよくある誤解であり、私がAI予測のこの専門用語を好きでない理由の一つでもある。だが、数世紀分の変化が数年に圧縮されるという予測は、遅く緩やかに進むという予測とは正反対だ。この解釈でも辻褄が合わない。
残念ながら、このページはAGI開発の速度についての同社の考えも、その考えがどう、なぜ変わったのかも説明していない。
私の見るところ、同社は広報上の難しい立場に自分で追い込まれている。OpenAIは、自ら以前に表明した見解に照らせば、危険なほど見当違いの判断をしばしば下している。その判断を正当化するには、何かについて考えを変えたのでなければならない。だが、正当化に使える合理的で首尾一貫した立場がない。この無理から、奇妙な二枚舌が生まれる。AGIのある世界への移行は緩やかで管理可能だが、同時に、数年で全世界を根本的に変えてしまうというのだ。
もっと筋の通ったことを言ってほしい。
2. 免罪符にされる科学的不確実性
このページは、OpenAIの行動を導く中核原則として「不確実性を受け入れること」を挙げている。
たしかにAIの未来には多くの不確実性がある。最も重要なのは、人類の絶滅を引き起こすかどうかだ。OpenAIの過去の文章の一部とは違い、このページはその可能性を明言していない。「人類の繁栄が回復不能な形で失われる」リスクには触れているが。この不確実性を踏まえ、どうするべきなのか。超知能が文字どおり人類を絶滅させる可能性が無視できないほどあるなら、絶滅を引き起こさずにつくる方法がわかるまで、開発を待つべきだ。私には、これは当然のことに思える。
ところがOpenAIにとって、不確実性とは、前進しながら考えていくべきだという意味になる。「私たちは安全性を科学として扱い、理論的な原則だけでなく、繰り返し実際に展開することから学ぶ。」これは、AIアライメントについて意味のある証拠は、OpenAIのような企業が最先端AIモデルをつくり続けることで得られるものだけだ、とほのめかしている。
突き進まなければ将来のリスクに「科学的」に向き合えないという考えは、一見して不合理だ。科学は、それまでの成果の上に積み重なる。理論は現実の観測によって支えられ、試され、その理論を使って予測できる。
より賢い知性は、より賢くない知性に対して大きな戦略上の優位をもつ、という理論的原則を考えよう。その経験的な証拠は、地球上の生命の過去5万年間にある。科学の名のもとに、人間より賢いAIシステムをつくって競争すれば、さらに試すこともできる。だが、実験の結果、全員が死ぬ可能性が高いと考えるなら、それでも実行しなければ科学者の名誉に反する、などということはない。これはひどい考えに見える、という常識的な判断をすればよいだけだ。
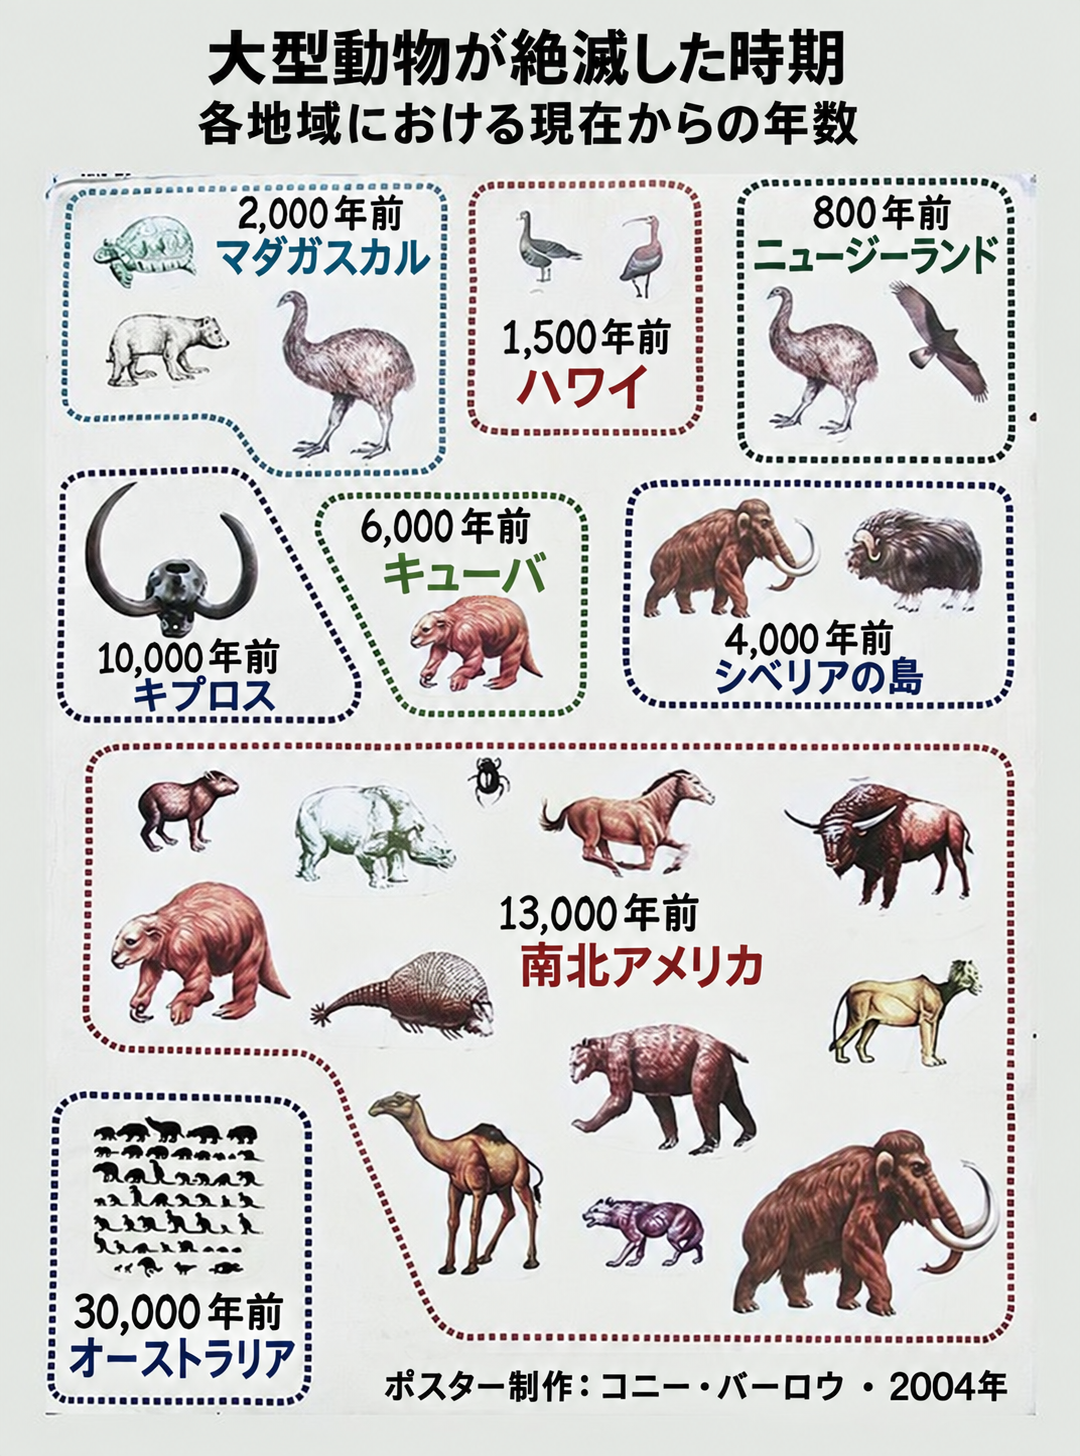
大型動物の多くの種は、その地域に人類が到来したのとほぼ同時期に絶滅した。(コニー・バーロウ)

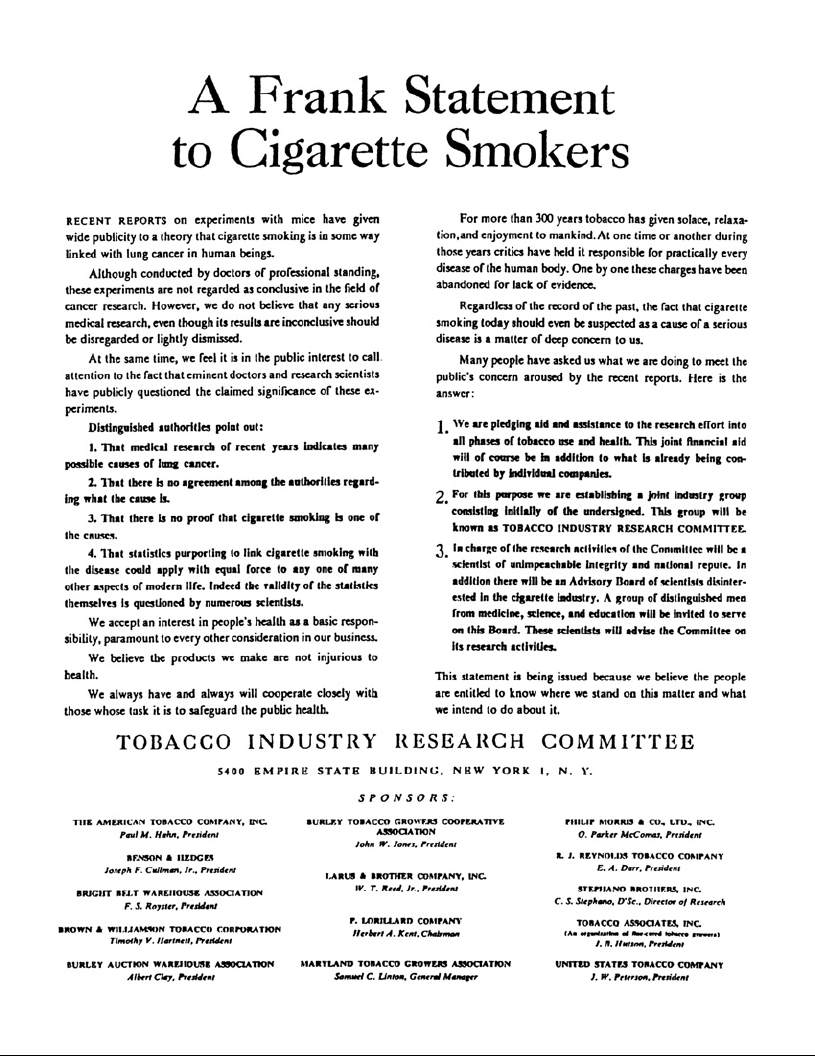
OpenAIの科学的不確実性の語り方は、ほかの企業が製品の潜在的な害を退けるために、世間へ発してきたメッセージの一部に似ていると感じる。たとえば、次のようなものだ。
喫煙と[肺がん]を結びつけるとされる統計は、現代生活の数多くのほかの側面のどれに対しても、同じ強さで当てはめられる。実際、その統計自体の妥当性を、多くの科学者が疑問視している。
――喫煙者への率直な声明 、 タバコ産業研究委員会による1954年の広告
今後10年以内に、科学は地球温暖化に影響する要因について、より多くの答えを示し、私たちの意思決定を改善してくれるだろう。今の私たちには、ただその情報がないのだ。
――科学:わかっていること、わかっていないこと、モービル石油による1997年の広告
科学的な不確実性があるときにそれを指摘するのはよい。しかし、それを、「不確実性」がなくなるまで肩をすくめて全速力で競争し続けてよいという免罪符にしてはならない。ところが、OpenAIの「安全性とアライメントをどう考えるか」は、そうしているように見える。安全性とアライメントの重要な論点を数多く無視している。以前に自ら明示的に認めたものまで含めてだ。
たとえば「能力の拡大に対応する手法」の節では、AIが書いた批評が、AIによる要約の欠点を人間が見つける助けになると示した、OpenAIの研究に触れている。これは、モデルの能力とともに拡張できる安全手法の例として挙げられている。だが、その論文が発表されたのは2022年6月だ。OpenAIが、既存の安全技術では超知能に対応できないと公式に発表した時点より、丸1年前なのである。
人間のフィードバックによる強化学習など、現在のAIアライメント技術は、人間がAIを監督する能力に依存している。しかし人間には、私たちよりはるかに賢いAIシステムを確実に監督することはできない。したがって、現在のアライメント技術を超知能まで拡張することはできない。
同様に、「人間による制御」の節は、強力な自律エージェントを制御し、封じ込めるために、「遠隔監視、安全な封じ込め、信頼できるフェイルセーフ」などのセキュリティ対策が必要になると述べている。立派で常識的な提案に聞こえるが、重要な留保が抜けている。十分に能力の高い超知能なら、人間が設計したほぼあらゆるセキュリティ対策を回避できる可能性が高い、という点だ。サム・アルトマンは、2015年のブログ記事でこの問題を認めていた。
たとえば、ある段階を超えたら、ネットワークから物理的に切り離されたコンピュータでしか開発してはいけないと定めることができる。自己改善するソフトウェアが反復のたびに先へ進むには、人間の介入を必要とするよう義務づけたり、ソフトウェアの一部に第三者によるコードレビューを義務づけたりすることもできる。だが、こうした対策が偶発的な誤り以外に効くという点では、私はあまり楽観していない。この戦略では、人間が常に弱点となるからだ。「箱の中のAI」の思考実験を参照してほしい。
OpenAIの「安全性とアライメントをどう考えるか」は、アライメントについてよく知られている難題に答えるべきだ。過去に同社自身が重大な危険や障害を明示的に認めていた場合に、それを避けるのは、とりわけ奇妙に思える。
3. 逆転した立証責任
OpenAIの「不確実性を受け入れる」という原則には、もう一つ問題がある。一貫して適用されていないことだ。このページは、AIでなぜ問題が起こりうるかについてのよく知られた議論を見過ごす一方、うまくいく筋書きについては、証明されていない仮定に大きく頼っている。
その最大かつ中核的な仮定は、OpenAI自身はアライメント問題の解をもっていないが、代わりに解いてくれる強力なAIシステムをつくれると信じている、というものだ。
私たちは、知能の向上を超知能のアライメントに役立てられると考えているが、まだ証明されてはいない。より能力の高いシステムをつくるにつれて多くの証拠が集まるはずであり、それによって私たちの方法を改めることになるかもしれない。
これは危険な計画だ。アライメント問題を解いた人はいないため、アライメント問題を解くといったことに確実に取り組もうとするAIを、どうつくればよいかも、誰も知らない。また、その問題を解く能力のあるAIをつくる方法も、誰も知らない。これは難しいことで知られる課題であり、OpenAI自身も「科学と技術の新たな突破口」が必要だと述べていた。この問題を解ける閾値に向かってAIの能力を高めることは、世界規模の破局を引き起こせる閾値にも近づけることになる。私たちは、それぞれの閾値がどこにあり、どれほど離れているのか、そもそも意味のある違いがあるのかさえ、知らない。
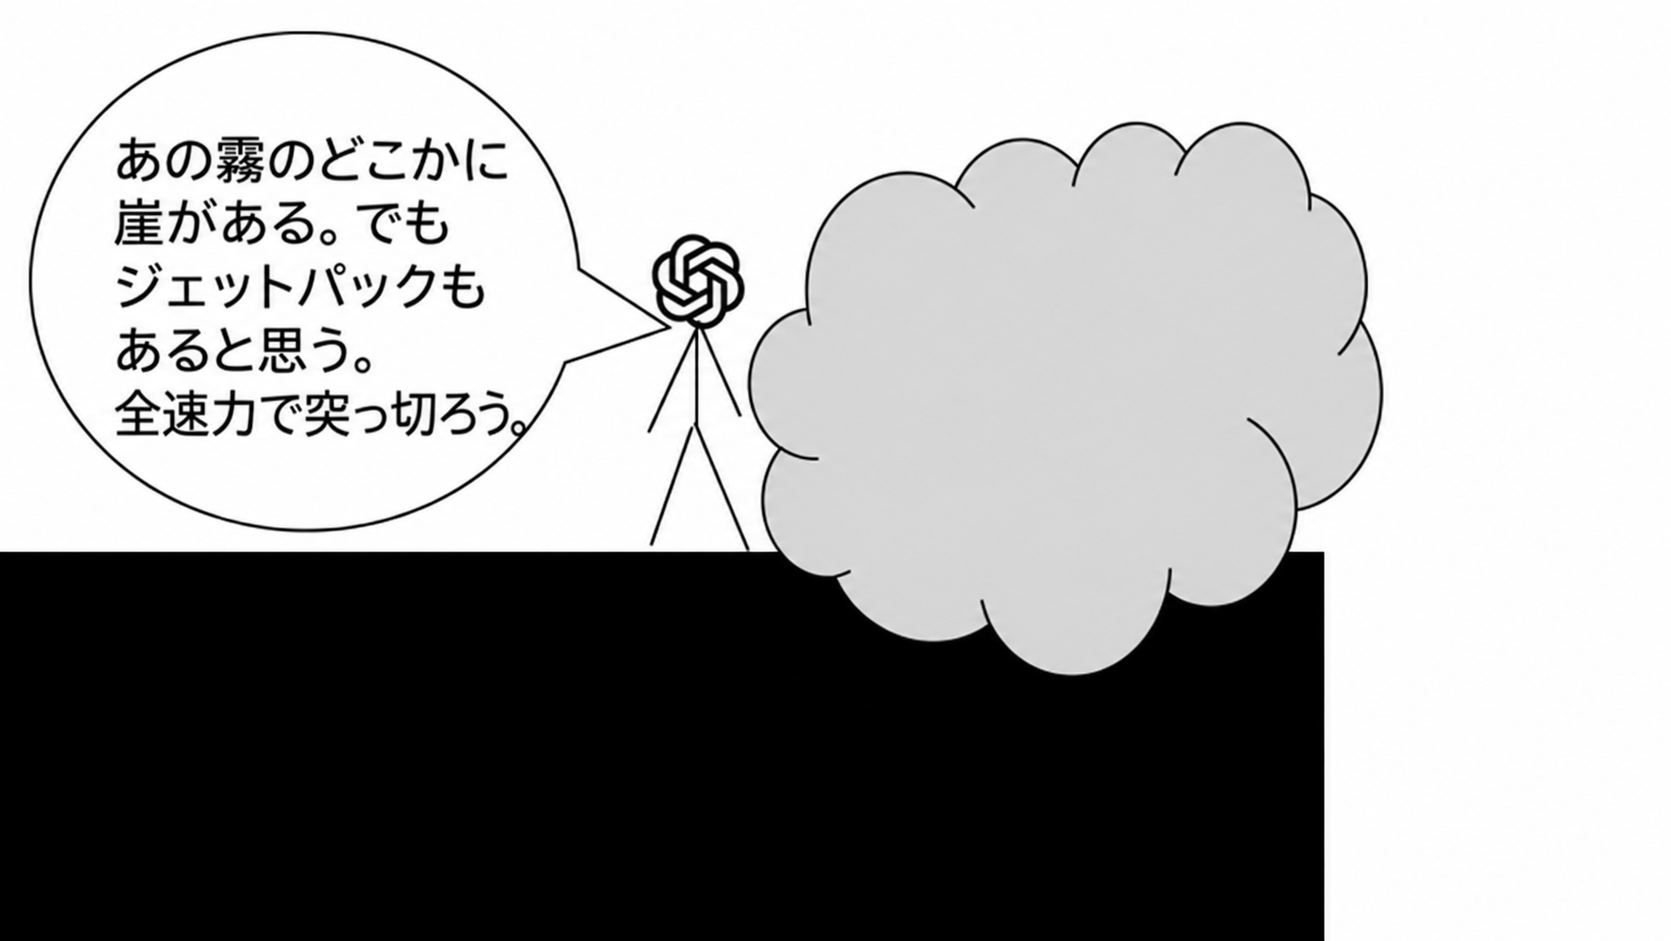
OpenAIがこれらの閾値について間違っていたら、同社の戦略は命取りになる。それでもこの戦略を進め、なぜ命取りになるのかという議論を軽く退けることによって、同社は議論における自らの責任を果たしていない。
ある企業が、人類よりはるかに賢い新種をつくっている、その制御方法はわからない、人類を絶滅させるかもしれないと考えている、と世界に告げるなら、それが全員の死を招かないと示す責任は、その企業にある。立証責任が逆にあるかのように示唆するのは、本末転倒だ。
では、OpenAIが議論における責任を果たすとは、どういうことだろう。
まずは、政策担当者や一般の人々に話す際、絶滅の脅威を一貫して認めることが、よい出発点になる。「全員の灯が消える」のような曖昧な婉曲表現ではなく、10年前、OpenAI設立以前のサム・アルトマンのブログ記事や、今は解散したOpenAIスーパーアライメントチームの設立発表にあったのと同じ明確さときめ細かさで語るべきだ。AIアライメント問題に対する見解を、明確かつ十分に説明する必要がある。この問題がきわめて難しいとする議論への異論があるなら、それも含めてだ。
同時に、超知能の開発競争をやめるべきでもある。現在、AI企業は、人類が知らないまま、同意もしないまま、人類の生存を賭けにさらしている。
人類にとって幸いなことに、「超知能を永遠につくらない」と「できる限り速くつくる」以外にも道はある。ただ、その道を見つけやすいのは、大手AI企業が自分たちの考えや異論について、もっと率直に語る世界のほうだろう。