
編集者注: 以下は、エリエザー・ユドコウスキー(Eliezer Yudkowsky)が2017年11月に書いた文書へ軽く編集を加えたものである。これは特定の時点におけるエリエザーの考えを切り取ったものなので、2017年の文書であることを本文の随所で改めて示している。
背景として、次の点に触れておきたい。
新たな難題に直面しても、人は時代遅れの攻略法をなかなか捨てられないことが多い。そして汎用人工知能(artificial general intelligence, AGI)は、間違いなく非常に新しい難題である。
イタリアの将軍ルイージ・カドルナ(Luigi Cadorna)は、記憶に残る歴史的な例を提供している。第一次世界大戦のイゾンツォ攻勢で、カドルナは、有刺鉄線と機関銃で守られた敵の塹壕へ無益な正面攻撃を繰り返し、何十万人もの兵士を失った。士気が急落し、脱走が蔓延すると、カドルナは残った兵士たちの「臆病」を治そうとして、自軍の兵士を集団で処刑し始めた。この攻勢は2.5年間続いた。
カドルナは多くの過ちを犯したが、その中でも最大の過ちは、この戦争がそれ以前の戦争とは根本的に違うと認めなかったことである。近代兵器はパラダイム転換を強いていた。カドルナの直観は、単に調整がずれていたのではなく、体系的に壊れていた。時代遅れの枠組みの中で小さな修正をいくら積み重ねても、新たな難題へ対処するには足りなかったのである。
この種の過ちにはほかにも、iTunesやストリーミングに対するレコード業界の当初の反応や、より深刻な例としてはCOVID-19に対する西側諸国の大半の政府の対応がある。
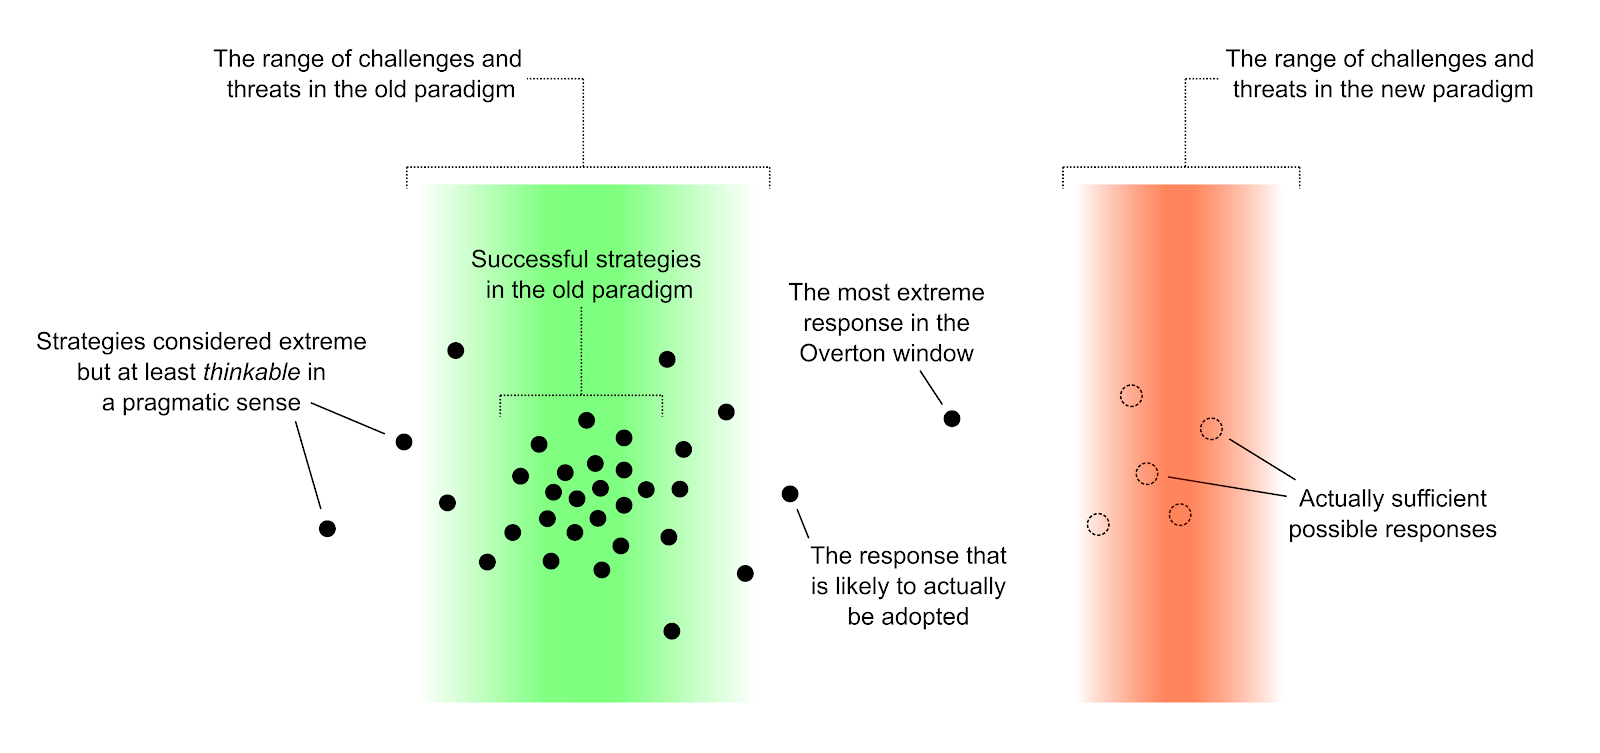
いつものことだが、参照クラス予測(reference class forecasting)の本当の難しさは、モデル化しようとしている対象がどの参照クラスに属するのかを見極めることにある。
ほとんどの問題では、アプローチを根本から考え直すのは無駄であり、必要もない。ほとんどの問題は、過去の多数の事例と似た因果構造を持つからである。だがAGIの場合のように、その問題が既存の戦略では対処できない性質のものなら、新しい攻略法が必要になる。
私はときどき、「AGI分野には善玉の組織がない」と不満を漏らすことで知られている。というより、完全な恐怖に駆られながら、丁寧な形でそう絶叫することで知られている。つまり、この地球上で共通善へ貢献したいと現在考えている研究者が加われるプロジェクトは文字どおり一つもなく、参加可能な状態に近いプロジェクトさえないということだ。現版のこの文書は、そのような「善いプロジェクト」が備えるべき性質を列挙してほしいと私に頼んだ、あるAI研究者への非公式な回答である。
要約すると、「善いプロジェクト」には次のものが必要である。
- 信頼できる指揮系統: そのプロジェクトの知的財産(intellectual property, IP)を、法的にも実質的にも統制する信頼できる指揮系統。この意味での「IP」には、稼働中のAGIも含まれる。
- 研究の非公開化: IPを信頼できる部門の内部へ閉じ込め、かつ/または区画化(silo化)し、単に既定の成り行きとして外部へ公開されることを防げる組織能力。
- 強固な運用保安: 例えばロシアの情報機関にコードを奪われることで、コード(または、例えば1年以内にコードを再現するのに十分なその他の情報)が拡散するのを防げるだけの運用保安(operational security, opsec)。
- 共通善へのコミットメント: プロジェクトの指揮系統と参加者は、短期的な善と長期的な善の両方へ、信頼に足るコミットメントを持たなければならない。短期的な善とは現在の地球における当面の福利であり、長期的な善とはトランスヒューマニスト的な天文学的価値の実現である。
- アライメントに必要な思考様式: プロジェクト内の誰かが、AGIアライメントを確実にするための新しく深い対策を自ら考案できるほど深いセキュリティ思考とAIの認知に対する理解を持たなければならない。その人物は技術的な統制権を握る立場にいるか、さもなければ事実上無制限の政治的影響力を持つ必要がある。プロジェクトの全員が、AGIをアライメントすることは途方もなく難しく、恐ろしく危険だと理解し、予想していなければならない。
- 必要な資源水準: プロジェクトは、より慎重でない競合プロジェクトに対して1年以上先行するために必要な、計算資源(コンピュート)、知的労働力、非公開の知見をどのような組み合わせであれ確保し、AGI開発の最前線で競えるだけの十分な資源を持たなければならない。
それぞれの次元で、どのような水準なら「最低限、十全、良好」といえるのかを私は尋ねられた。私は物事を「十全でない」と「十全である」に明確に分けがちだが、それでも質問の趣旨に沿って答えてみる。
信頼できる指揮系統
名目上(Token): AGIをアライメントしようとする考えそのものに反対する人、各家庭にAGIを置きたがる人、あるいはAGI戦略のうち簡単な部分をなぜか受けつけない人の手に、実質的・法的な権力を持たせない。
例えば、ラリー・ペイジ(Larry Page)は、コスモポリタンな価値観はよく、種差別(speciesism)は悪く、知覚を持つ存在が炭素ではなくシリコンで実装されているというだけで虐待するのは間違っている、といった正しい見方から出発する。ところがその後、目標と能力には直交性(orthogonality)があり、道具的な戦略には道具的収束(instrumental convergence)が見られ、価値は複雑で壊れやすいという考えを退ける。その結果、AGIは自動的に友好的になると予想し、AIをアライメントしようとするあらゆる試みに対して、AIを「鎖につないでおく」企てだとして反対しかねない。
別の例を挙げると、2015年12月時点のイーロン・マスク(Elon Musk)は、非公開化に賛同していなかっただけでなく、超人的な能力を持つAIをむしろオープンソース化したいと考えていたらしい。
イーロン・マスク個人がOpenAI理事会の過半数を占めるわけではない。しかし、彼が実質的に理事会の過半数を動かせるなら、この基準は名目上の最低水準さえ満たしていない。
(追記:イーロン・マスクは2018年2月、OpenAIの理事を退任した。)
改善途上(Improving): 理事会はIPを統制せず、アライメントの問題を認識する研究区画が統制する、と定めた法的契約がある。
十全(Adequate): 最終的な統治権を持つ理事会の全理事を含め、指揮系統全体がアライメントの難しさと危険性を十分に認識している。理事会が突然、それでもAIをオープンソース化しようと決めた場合に備え、技術責任者がディスク消去措置を用意していても、理事会は反対しない。
優秀(Excellent): どういうわけか、現地のいかなる権力主体にも、介入して安全対策などを解除する危険がない。この方向へ段階的に進みながら、かえって事態を悪化させずに済む方法が私には思いつかない。例えば、アイスランド政府が突然、事態の深刻さを理解し、あるプロジェクトへ公的な承認と保護を与えたなら、この説明に当てはまるだろう。しかし、このようなことを画策すれば、それが広める思考様式のために、世界全体ではおそらく事態を悪化させると私は考える。
非公開化
名目上(Token): 組織内の一部の人々が、コード、アーキテクチャ、一部の発想を外部の人々から「秘密」にしておきたいと考えていることが、組織全体でおおむね理解されている。反対意見があっても、プロジェクトの全員がそれを受け入れている。原則として、明らかに能力向上につながる要素を含む興味深い発見を、研究者が公表するよう迫られることはない。実際には、必ず誰かが「でも6か月後には、ほかの誰かが似た発想を公表するだろう」と言い、そうでないと考えるのは傲慢ではないかと疑う。それでも、中程度の個人的代償を払えば、公表せずに済ませることはできる。
改善途上(Improving): 成功確率をゼロより有意に高くするには、コード、アーキテクチャ、得られた教訓などの一部を、一般の機械学習(ML)コミュニティへ届かせてはならない理由を、プロジェクト内の一部の人々が理解している(妥当な長さの先行期間を持つプロジェクトがなければ、アライメントと能力のトレードオフのため、この難題には勝てないからである)。その人々は、プロジェクト指導部の認可と了承を得て、プロジェクト内に非公開の区画を設けている。どのような考えが能力向上につながり得るかについて、社会的に慎重な判断をしても問題視されない。そして、これを心配することは、自分の能力を誇示する思い上がった行為でも、論文を書かずに済ませるための策略でもないと理解されている。
十全(Adequate): プロジェクトの全員が非公開化を理解し、同意している。プロジェクト内の全員が知る必要のない情報は、必ず区画化される。
念のため繰り返すが、これは2017年の文書である。
運用保安(Opsec)
名目上(Token): 無関係な人が建物の中を勝手に歩き回ることは許されない。
改善途上(Improving): あなたの弟がIPを盗むことはできない。情報は暗号化されている。区画化されたプロジェクトの参加者は、秘密保持契約(NDA)へ署名している。
十全(Adequate): 大国の政府であっても、通常とは異なる労力を払わずに、ひそかに、誰にも気づかれずIPを盗むことはできない。プロジェクトの全参加者は、政府の機密取扱許可に準じる身元調査を受ける。AGIのコードはAWS上ではなく、ネットワークから隔離されたサーバー室で動く。そのサーバー室には、機密取扱許可を得た警備員がいる。
優秀(Excellent): 軍事級または国家安全保障級のセキュリティ。(この水準の実力を投入できる組織について、信頼できる指揮系統と共通善へのコミットメントを確保する難しさや、獲得を試みること自体が一般の思考様式へ及ぼす影響を考えると、これを得ようとする試みが逆効果にならずに済む方法は想像しにくい。)
共通善へのコミットメント
名目上(Token): プロジェクトの参加者と指揮系統は、自分が独裁者になれる限り独裁制は素晴らしい、などと公然と話してはいない。プロジェクトは、トランプ(Trump)やプーチン(Putin)へ直接責任を負ってはいない。もちろん民主主義とアップルパイを推進すべきであり(拍手)、全員が金の壺からいくらか分け前を得るべきだ(拍手)といった、曖昧で中身のないことは言っている。
改善途上(Improving): プロジェクトの参加者と指揮系統は、人々へ親切にし、最終的には善良な銀河間文明を築くことへの賛成を明言している。がんの治療法を持っていれば、現在の配備状況が許す限り、それを公開するだろう。脱生物学的な未来へ向かう段階的な歩みや、最終的に懸かっている真の価値の大部分を実現することへ反対しそうにもない。
十全(Adequate): プロジェクトの参加者と指揮系統は、AGI技術が許すなら、長期目標としてCEV(整合外挿意志、coherent extrapolated volition)のようなものへ明示的にコミットしている。それができない場合も、知能強化がどのような経路を通るにせよ、価値と知覚ある存在の権利を慎重に守ることへコミットしている。短期的には、自分たちに良い考えと思えることを何でも行うのではなく、まず、自らの手で人類を滅ぼさず、その精神を傷つけないことを優先する。(例えばGoogleやFacebookが一貫してこのように考えていたなら、ソーシャルメディアが認知能力を損なうことを、もっと早くから懸念していただろう。)政策上の帰結を伴う、本物の道徳的謙虚さが実際に存在する。
アライメントに必要な思考様式
名目上(Token): 指揮を執る人の少なくとも一部は、AIが、組織トップの「アルファ雄」が起こしたいことを何でも自動的に行うわけではないと、ぼんやりながら理解している。「倫理学者」を雇ってトロッコ問題やどのサルにおいしいバナナを与えるべきかを話させているだけではなく、少なくとも技術的に取り組むふりはしている人も雇っている。
改善途上(Improving): 「安全性」グループが生み出す技術的成果は、自明でも誤りでもない。指揮を執る人々はAIについて普通のパラノイアを持っている。アライメントはある程度難しく、余分な労力がいくらか必要になると予想している。史上初のAGIを使って自分たちが行いたいことは、どれも同じように安全に試せるわけではないと理解している。
十全(Adequate): そのプロジェクトは、AGIを構築する仕事の大半が、それをアライメントすることだと悟っている。完全なセキュリティ思考を持ち、AGIの認知を認知そのものとして深く理解する人物が、新しく深いアライメント対策を自ら考案できることを実証している。その人物は技術責任者を務め、仕事を本当に完遂させるため、組織内で事実上無制限の政治的影響力を持つ。全員が、アライメントは途方もなく難しく、恐ろしく危険であり、姿の見えない弾丸が自分に当たるほど近づく前に、その影を見抜かなければならないような危険に満ちていると予想している。アライメントがアーキテクチャを厳しく制約し、能力と透明性がしばしばトレードオフになることを理解している。この組織が目標とするのは、次のAGIプロジェクトによる世界の破壊を防ぐために必要な認知作業のうち、最も危険性の低いものだけを行う最小限のAGIである。アライメントに関する仮定は、目標や価値を帯びない記述へ分解され、明確に書き出され、本当に真であるか継続的に監視されている。
プロジェクトにとって、アライメントに必要な思考様式を身につけるのは根本的に難しい。グレアムのデザインのパラドックスが当てはまるからである。普通のパラノイアしか持たない人には、認知の深さがもう一段上がったことを見分けられないかもしれない。のんきで無垢な人には、有益なパラノイアと、リスクや安全性について空疎な声明を発するスーツ姿の人々とを見分けられない。そうした人々は、自分に何が欠けているかにも気づかない傾向がある。したがって、研究力のある人、組織、政府をもう一つ説得し、新しいプロジェクトを始めさせるたびに、何か並外れたことが起きない限り、そのプロジェクトのアライメントに必要な思考様式は十全にならないという、恐ろしいほど強い既定の帰結がある。率直に言えば、現在の世界を前提とするなら、実際に成功させるには、結局のところ私かネイト・ソアレス(Nate Soares)を信頼する過程を経なければならないと私は考えている。ただし、ポール・クリスティアーノについては後述する。この次元で低い位置にいる人がどうすれば改善できるかについて、特定の人物に依存しない明確な手順がないことこそ、この次元の難しさが真の致命傷である理由だ。
それでも、この不可能な方法を試すと言い張るなら、優秀な機械学習研究者よりも、優秀なコンピューターセキュリティ研究者へまず話を聞くよう勧める。
資源
名目上(Token): 資金、優れた研究者、計算能力をプロジェクトが組み合わせて備え、関心を持つ慈善家がさらに資金を加えられ、アライメントされたAGIへ関心を持つほかの優れた研究者も参加できる、信頼に足る旗印になっている。例えばOpenAIは、ほかの5つの次元で十全なら、この基準を満たすだろう。
改善途上(Improving): プロジェクトの規模と研究者の質は、例えばFacebookのAI研究所と同程度であり、最大手にはあと一歩届かない有力組織の間で、十分に競争できる。通常とは違う目標へ注意を集中すれば、デミス・ハサビス(Demis Hassabis)が先に手をつけない限り、一般の研究分野より1年以上先にそれを成し遂げられる。例えば米国国家安全保障局(National Security Agency, NSA)が今から参入し、その後それ以上成長しなかったとしても、この水準の「資源」は持つだろうと私は予想する。
十全(Adequate): プロジェクトは、ほかの誰よりも2年先行して物事を成し遂げられ、競合がそこへ注意を集中しても追いつけるかは明らかでない。DeepMindには、極めて優秀な人材が大勢おり、外部と共有していないツールもある。この次元で十全性を達成する明白な候補である。ただし、ほかの次元でもなお十全である必要があり、優位を守り、積み上げるには、非公開化をさらに進める必要もある。私の理解では、十分な資源上の優位こそ、デミスが明示的に達成しようとしていたものだった。ところがイーロンがそれを台無しにし、オープン化ブームと軍拡競争を始め、おそらく私たち全員を死なせることになった。この次元で十全になろうとするほかの組織は、DeepMindを追い越すか、DeepMindと合併するか、もっと多くの研究を非公開にし、アライメント不可能なAGIへの道筋へ注ぐ労力を減らすようデミスを説得する必要がある。
優秀(Excellent): 優れた人々が参加する「善いプロジェクト」は一つの主要プロジェクトだけであると、研究コミュニティのかなりの部分が理解している。そのプロジェクトとの競争は賢明でなく、公共の利益にもならないと見なされる。この「善いプロジェクト」は、ほかの次元すべてで少なくとも十全である。主要な競合には、同等の資金か、同等の才能と洞察のいずれかが欠けている。現在の世界を前提とするなら、指揮系統の信頼性とアライメントに必要な思考様式が十分な、このようなプロジェクトを存在させるのは極めて難しい。そして、それを作ろうとして失敗すれば、アライメントされていないAGIを開発する、さらに悪い競合を生み出す危険がある。
非現実的(Unrealistic): トランプ、プーチン、国際連合安全保障理事会(United Nations Security Council)のような、共通善を目的としない指揮系統へ、どういうわけか責任を負わない単一の世界的マンハッタン計画がある。ほかの誰よりも何桁も多い計算能力と、優秀な研究者の労働力を持つ。何らかの力が、ほかのAGIプロジェクトの出現と、この巨大プロジェクトとの競争を防いでいる。プロジェクトは、透明性と能力のあらゆるトレードオフで自由に透明性を選び、アライメントを確実にするため、さらに10年以上を費やせる。ほかの次元すべてで少なくとも十全である。何世紀も前により有能な文明的均衡へ向かって分岐したエヴェレット分岐(Everett branches)では、遠く離れた、生き延びた私たちのいとこたちが、このように事を進めている。指揮系統の信頼性、アライメントに必要な思考様式、共通善へのコミットメントが十分な、このようなプロジェクトを、あなたが存在させることは絶対にできない。したがって、存在させようとしてはならない。第一に、そうすればアライメントされていないAGIを開発する、さらに危険な競合を生み出すだけだからである。第二に、その指揮系統としてありそうな姿を考えれば、仮にそのAGIをアライメントできたとしても、とてつもない天文学的苦痛のリスク(s-risk)になるからである。現実の中を横滑りしている人々は、これができると夢想する。
念のため繰り返すが、これは2017年の文書である。
補足所見
非公開化が「十全」なプロジェクトと「改善途上」のプロジェクトが統合すれば、全体としては非公開化が「改善途上」(つまり十全でない)なプロジェクトになる。非公開の部門が、開かれた組織内の一つの区画になるからである。ほかの次元にも同様のことが当てはまる。秘密保持契約を使うプロジェクトと、従業員へさらに徹底した身元調査を行うプロジェクトを統合すれば、一部の身元未調査者が建物内にいるプロジェクトとなる。したがって、運用保安は「改善途上」である。
非公開化と運用保安の次元における「十全性」は、私が最もありそうな筋として想定する次のシナリオをもとにしている。ほかの誰かが直後に世界を破壊するのを防ぐ最小限の行為を行わせることについてさえ、AGIをまだアライメントできない状態で、少なくとも1年を過ごすことは避けられない。しかしその1年の間には、コードから多くの安全措置を取り除き、透明性と能力のトレードオフを能力優先へ切り替え、運転を全開にし、ただちに世界を破壊することができる。
この期間中、コードが広い世界へ漏れれば、自動的に世界はペーパークリップへ変えられる。商業スパイ集団や国家情報機関など、複数の主要主体へコードが漏れれば、世界が破壊される可能性は極めて高いように私には思える。少なくとも一つの国家主体の指揮系統は、アライメントに関する議論を正しくやり直さず、しかも各主体は互いを恐れるからである。
また、非公開化が不十分なプロジェクトから重要な発想やアーキテクチャ上の教訓が漏れた場合も考えられる。そのプロジェクトは、漏洩がなければ、実際にアライメント可能なAGIを開発したはずだとする。それでも、10%の労働力で、アライメント不可能で世界を破壊するAGIをより短期間に実装できるようになるだろうと私は予想する。プロジェクトを厳重に非公開化しなければ、すべてがペーパークリップになる。
共通善へのコミットメントにおける「十全性」は、最初のタスク指向AGI(task-directed AGI)が、真の超知能をはるかに下回る領域で動き続ける、という私のモデルをもとにしている。その領域では、能力より透明性を優先するトレードオフが数多く行われ、そのため自己改変が大きく制約される。
このタスク指向AGIは、真の超知能による攻撃を防御できない。ほかのAGIプロジェクトが制約のない超知能を作らない限り、タスクAGIのような活動をかなり自由に独立して行えるような、目立たない方法でそれらを監視することもできない。最初のタスク指向AGIの設計者は、AGIが自分自身や環境の内部にアライメントされていない超知能を作らない領域で、かろうじてそれを運用できるにすぎない。最初のAGIを安全に運用するには、多大な監督努力を続ける必要がある。ほかのAGIプロジェクトに必要な安全監視の水準は非常に高い。そのため、最初の運用者がAGIの力でもっと多くのことを行うのがよいと判断したなら、それらを最初のタスク指向AGI上で動く追加タスクとして実行するほうが、はるかに単純で安全である。したがって: 超人的な科学や工学のように、人間を超える特化型汎用知能を呼び出して使うことはすべて、引き続き一か所の実効的な拒否権に服する。
これは、AGIの力を拡散できる、より極端でないシナリオでも同じである。AGIの力を非常に厳しく監視しなければならないからだ。安全措置をあまりに多く外し、意図的または偶発的に制約のない超知能が作られれば、アライメントされたAGIであっても、それから防御することはできない。いずれにせよ、監視を続け、世界を破壊しかねないことをほかの誰かがAGIで行うのを阻止する力を持つ、中央の拒否権者が存在する。
すると、人間の心をアップロードする、人間の知能強化を試みる、CEVを実行するため、よりクリーンで安定したAGIを構築するといったAGIの力のあらゆる利用は、最初のタスク指向AGIを運用する指揮系統の明示的な拒否権に服することになる。この指揮系統がCEVのようなものを支持しない、透明性のあるCEVがもたらすトランスヒューマニスト的な帰結を拒否する、知能強化を認めない、といったことがあれば、未来の天文学的価値はすべて永久に失われ、s-riskさえ生じ得る。
はるか昔、地球上の誰かが、人間のエミュレーション(emulations)は本当の「人」ではないと決めたり、そう投票したりしたために、知性ある存在の99.9%に公民権がない宇宙は、ペーパークリップだけの宇宙よりもはるかに悪い可能性が十分にある。(知性ある存在のほぼ全員が投票できないという結末に至る民主的正統性の議論は、自らの目的を損なうものだと私は考える。)
もしDeepMindが情報を区画化する水準まで非公開になり、十分な運用保安を施し、何らかの形でその区画内にアライメントに必要な思考様式を獲得し、その区画の指揮系統を信頼できるものにしたなら、私の大まかな推測では、地球を救えるかもしれない(私たちはロジスティック成功曲線の底から離れ始めるだろう)。
OpenAIは複数の次元で、DeepMindよりもさらに遅れているように私には思える。OAIは大幅に優れた「安全性」研究を行っている。しかし、たとえその研究が偽物でも自明でもないとしても、私の知る限り(as far as I know, AFAIK)、そのすべてがなお、本格的なAGIには適用できない。アライメントに必要な思考様式の次元について、OpenAIとDeepMindのどちらも、ロジスティック成功曲線の地下室から出ているとは思わない。私の立場から見る限り、OpenAIにアライメント成功の可能性を与えるために必要な奇跡が、DeepMindに同じ可能性を与えるために必要な奇跡より起こしやすいかは明らかでない。グレッグ・ブロックマン(Greg Brockman)をはじめとするOpenAIの意思決定者がまったく理解力を欠くわけでないなら、デミス・ハサビスもそうではない。OAIとDeepMindはどちらも、共通善へのコミットメントの尺度上で、かなりの距離を越える必要がある。この次元は比較的、上限まで高めやすい。しかし、指揮を執る人々が曖昧にうなずき、道徳的謙虚さについての使命声明を公表するだけでは、上限には達しない。道徳的に謙虚な指揮者と、そうでない指揮者が作る、壊れやすい政治的均衡でも足りない。もし私に莫大な資金があり、地球を救う真剣な有力候補をOpenAIから生み出したいなら、まずOpenAIの研究者のうち、身元調査に合格できるだけの人を集め、別組織として再設立するだろう。そして、それをさらなる人材採用の土台にする。
私が深いマクロ・アライメント研究だと見なす試みを行った人は、ポール・クリスティアーノ(Paul Christiano)以外に一人も見たことがない。例えば、ポールのAGI構想には、仮定へ分解できる全体的なアライメントの筋書きがあり、人間を正確に模倣するという発想は、表面的な防御策ではなく深い発想である。ただし、仮定はまだ十分に分解されていないと私は考えている。だがほかの人は、そもそもこのようなことを試みるべきだとさえ知らない。ポールのAGI構想はコストが何桁も高すぎ、アライメントについて鶏と卵の問題も抱えているとも私は考えている。それでも、ポールが技術指揮を執るプロジェクトを完全に除外するつもりはない。たとえポール自身のパラダイムでなくても、ほかの誰かによる深いセキュリティ分析を追い、その分析のパラダイムに立って理解できるのではないか、という希望を持てるからだ。ポールは有益な改善案を示し、全体的なマクロ像へ完全性を求めるだろう。そして、あるアライメント上の仮定が自分本来のパラダイム内の仮定でなくても、それを破ることがどれほど悪いかを真剣に受け止めるだろう。現在、比較対象となる土俵にいるのは、私とポール以外に誰もいない。私たち二人が同じプロジェクトで働いても、そのような人材が不安になるほど少ない状況は変わらない。機械学習研究者だけでなく、優秀な若手コンピューターセキュリティ研究者の集団から、このような人をもっと見つけるべきだと思う。それも同じくらいひどく失敗するかもしれないが、試されるところを見たい。
アライメントのための文書化された構想であれ、その他の固定的な助言であれ、普通のパラノイアを持つ優秀なプログラマーへ引き渡すだけで、本当に成功できるようなものを作ることは不可能だろうと私は考える。深い発想の一部は、間違っている、適用できない、あるいは単純に欠けていることが判明するだろう。実際に破局が起きる前に、誰かが修復不能な根深い問題に気づき、プロジェクトの進行に合わせて、単なる継ぎ当てではない、新しく深い発想を考え出さなければならない。
念のため繰り返すが、これは2017年の文書である。