
何かを解明したい。けれど、どうすればよいかは、まだわからない。
何とかして、その課題を部分的な計算に分けなければならない。それ以上分けられない「考える」という行為があるわけではない。知性は、知的ではない部品から組み上げる必要がある。
エージェントが部品からできていることは、 【トピック:意思決定理論】 反事実を難しくしていた理由の一つだ。部品のありえない構成について考える必要があるかもしれないからである。
また、部品からできているからこそ、 【トピック:頑健な委任】 自分についての推論や自己改変が、そもそも可能になる。
だが、この節で主に扱うのは、別の問題だ。エージェントが部品からできていると、 【トピック:意思決定理論】 敵対者は外部環境だけでなく、エージェントの内部にもいるかもしれない。
この問題群が、 【トピック:サブシステム・アライメント】 サブシステムのアラインメント である。サブシステム同士が相反する目的に向かって動かないようにし、部分的な処理が意図しない目標を最適化するのを避けることだ。
- 無害な帰納
- 無害な最適化
- 透明性
- メサ最適化器
たたき台として、こんなエージェントの設計を考えてみよう。
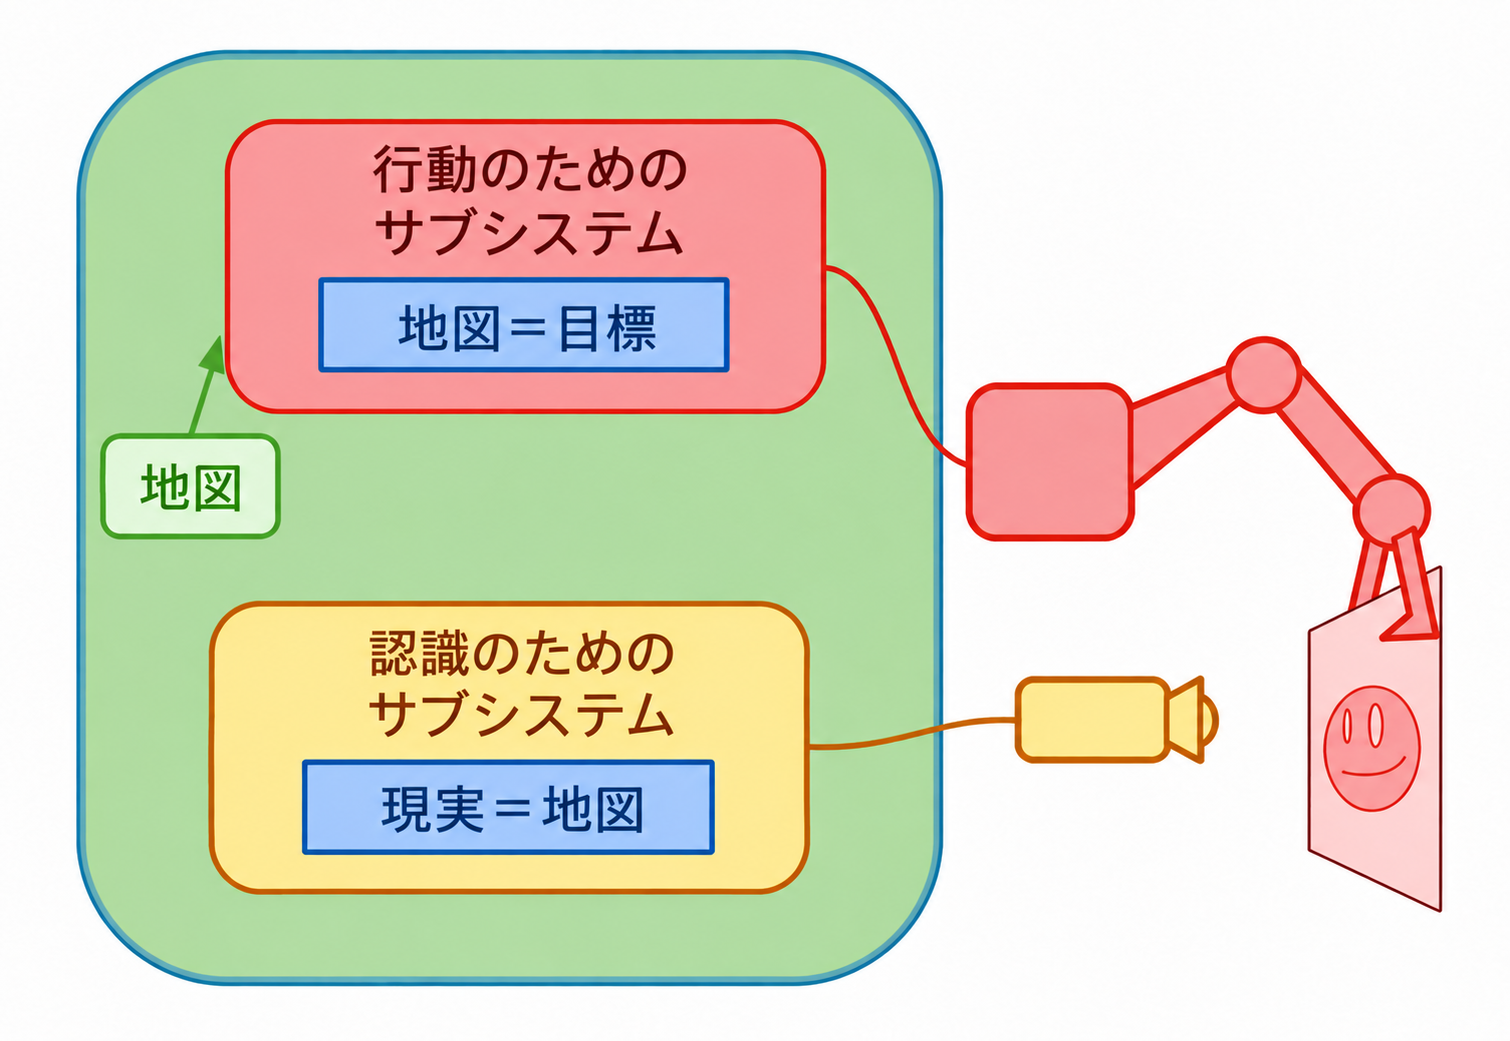
認識のためのサブシステムが求めるのは、正しい信念だけだ。行動のためのサブシステムは、その信念を使って、自分がどれほどうまくやっているかを把握する。行動側が認識側に比べて有能になりすぎると、図のように、認識側をだまそうとするかもしれない。
逆に、認識側が強くなりすぎても、悪い結果を生む可能性がある。
この設計は、認識と行動のサブシステムを、それぞれ固有の目標を持つ別々のエージェントとして扱っており、あまり現実的ではない。だが、 【トピック:頑健な委任】 ワイヤーヘディングの節で見たように、サブシステムが互いに食い違う目的で動く問題は、避けにくい。そして、そのサブシステムを意図的に作ったのでなければ、問題はいっそう難しくなる。
異なるものを求めるサブエージェントを起動しないほうがよい理由の一つは、 相対的な規模の違いに対する頑健性 がほしいからだ。
能力の規模を変えても、機能し続けるか、穏当に機能を失うなら、その方法は 規模に対して頑健 だと言える。三つの種類がある。 【トピック:頑健な委任】 拡大に対する頑健性、 【トピック:埋め込み型世界モデル】 縮小に対する頑健性、そして 【トピック:サブシステム・アライメント】 相対的な規模の違いに対する頑健性だ。
拡大に対する頑健性 とは、最適化が上手になっても、システムがよい振る舞いをやめないことだ。確かめる一つの方法は、AIが最適化する関数が本当に最大化されたら、どうなるかを考えることである。 【トピック:頑健な委任】 グッドハートの法則を思い出してほしい。
縮小に対する頑健性 とは、 【トピック:埋め込み型世界モデル】 能力を下げても、システムが機能することだ。もちろん、役に立たなくなるかもしれない。だが、安全に、不要な費用をかけずに失敗するべきだ。
関数を厳密に最大化できればうまく働くシステムでも、近似したら安全だろうか。たとえば、人間の価値を非常に正確に学べば安全でも、近似すると、ますますアラインしなくなるかもしれない。
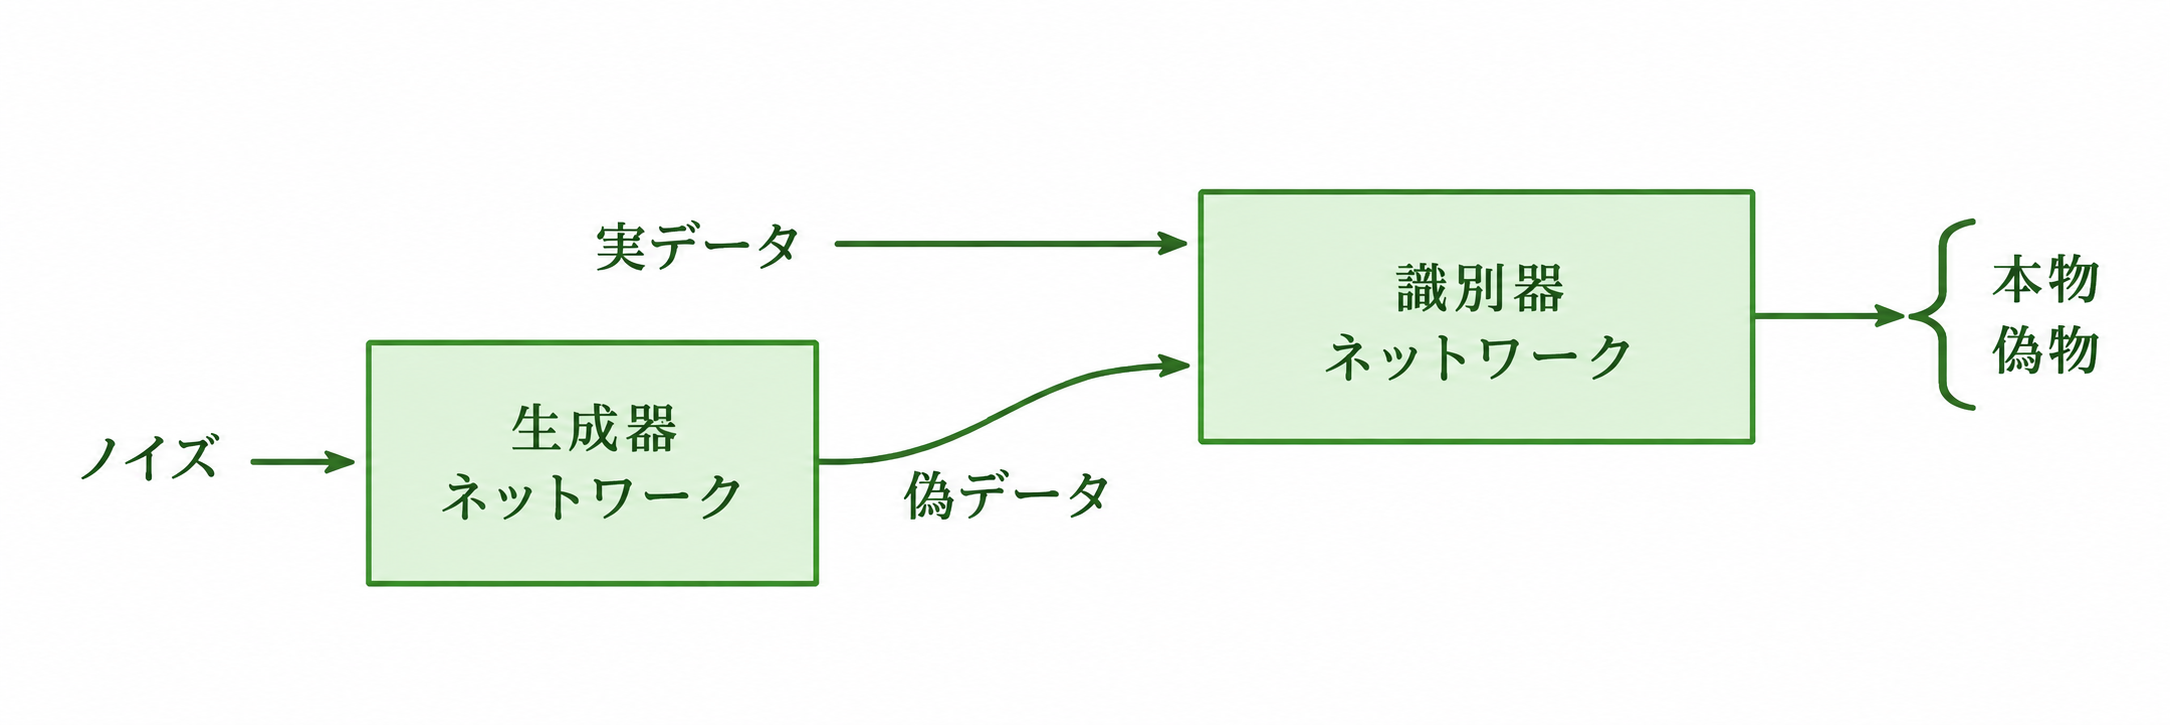
相対的な規模の違いに対する頑健性 とは、設計が、エージェントの各サブシステムが同程度に強いことに依存しないことだ。たとえば、GAN(敵対的生成ネットワーク)の訓練は、一方のネットワークが強くなりすぎると、訓練信号がなくなって失敗することがある。
規模に対する頑健性がないからといって、必ずしも提案が駄目になるわけではない。だが、意識すべき点ではある。頑健でないなら、適切な規模で動かしていると考える強い根拠が必要だ。
相対的な規模の違いに対する頑健性は、サブシステムのアラインメントで特に重要だ。知的な部分を持つエージェントは、なぜ常にそれが可能かを強く説明できるのでなければ、部分を知恵で出し抜けることに頼るべきではない。
大局的な教訓は、自分自身の中で目的が食い違わない、統一されたシステムを目指すことだ。
なぜ、内部の部品が争うエージェントを作るのだろう。明白な理由が三つある。下位目標、参照先を指すもの(ポインター)、そして 探索 だ。
課題を 下位目標 に分けることが、効率よく解を見つける唯一の方法かもしれない。だが、下位目標の計算が全体像をすっかり忘れてはいけない!
家を建てるためのエージェントは、階段を作ることだけを大切にするサブエージェントを起動すべきではない。
直感的に望ましい条件の一つは、問題を分解するために各部分が固有の目標を必要としても、下位目標が主目標を頑健に 【トピック:頑健な委任】 「指し返す」ことだ。
家を建てるエージェントが、階段だけを気にかけるサブシステムを作るとしても、それは 家 という文脈の中でだけ階段を気にかけるものであるべきだ。
ただし、それが、家を建てるシステムの頭の中に、もう一つの家を建てるシステムを入れただけ、ということになってはいけない。ここから、次の項目につながる。
参照先を指すもの:サブシステムは問題を 小さくする 必要があるので、 【トピック:埋め込み型世界モデル】 システム全体の目標を丸ごと抱えているのは難しいかもしれない。しかし、こうした間接的な参照は、サブシステムごとのインセンティブが食い違う状況を生みやすいようだ。
認識と行動のサブシステムの例で見たように、本当に大事な指標について、自分が何をしているかのフィードバックを直接受ける代わりに、何らかの 期待値 を最適化し始めると、歪んだインセンティブが生じかねない。これがグッドハートの法則だ。
上位の目標体系全体を渡さずに、サブシステムに「Xをしていると全体を納得させよ」ではなく、「Xをせよ」と頼むには、どうすればよいだろうか。
これは、価値をすべて書き下すのは難しいため、 【トピック:頑健な委任】 後継エージェントに価値を頑健に指し示してほしかった、という話に似ている。ただし今回は、より大きなエージェントの価値を学ばせることにも意味がない。サブシステムや下位目標は、 【トピック:埋め込み型世界モデル】 より小さく なければならないからだ。
人間が全面的に設計したサブシステムや、AIが明示的に作る下位目標のアラインメントは、それほど難しくないかもしれない。設計によって不一致を避け、 【トピック:頑健な委任】 自分の目標を頑健に委任する方法がわかれば、どちらも解けそうだ。
しかし、すべてのサブシステムを、それほど明示的に設計するのは無理そうだ。問題を解く途中で、自分が分け方を知っている限界まで分解し、それからは試行錯誤に頼らなければならない時点が来る。
これが、各部分が別々のものを最適化する第三の理由、 探索 につながる。豊かな可能性の空間を探して問題を解くのだが、その空間自体に、アラインしていないサブシステムが含まれているかもしれない。
機械学習の研究者には、よく知られた現象だ。高性能な機械翻訳システムを自分で直接書くより、それを見つけてくれるプログラムを書くほうが簡単なのである。
長期的には、これがさらに一段進むこともある。問題が十分に豊かで、探索過程が十分に優れていれば、探索で見つかった解自体が、何かを知的に最適化しているかもしれない。
偶然そうなることも、難しい問題を解くための戦略として意図的に作ることもある。いずれにせよ、グッドハート型の問題を悪化させる可能性が高い。以前は一つだったアラインメント失敗の機会が、実質的に二つになるからだ。
この問題は、ヒュビンガーらの「高度な機械学習システムにおける学習された最適化のリスク」で説明されている。
元の探索過程を ベース最適化器、探索によって見つかった探索過程を メサ最適化器 と呼ぼう。
「メサ」は「メタ」の反対だ。「メタ最適化器」は、新しい最適化器を生み出すよう設計された最適化器である。一方、「メサ最適化器」は、元の最適化器が生み出した最適化器なら何でも指す。プログラマーがベース最適化器に、新しい最適化器を探して ほしかったかどうか には関係がない。
「最適化」と「探索」は曖昧な言葉だ。ここでは、ある目的関数で高い得点を取る対象を「見つける」ために、相当な計算を行っている、と自然に解釈できるアルゴリズムを指すことにする。
ベース最適化器の 【トピック:頑健な委任】 目的関数は、メサ最適化器のものと同じとは限らない。ベースがピザを作りたい場合でも、新しい最適化器は、生地をこねたり、材料を刻んだりすることを好むかもしれない。
新しい最適化器の目的関数は、少なくともベースが検査する例では、ベースの目的に 役立つ ものでなければならない。そうでなければ、そのメサ最適化器は選ばれなかったはずだ。
だがメサ最適化器は、何らかの形で問題を小さくしなければならない。まったく同じ探索をもう一度やり直すのでは意味がない。そのため、メサの目標は、よい経験則に似たものになる傾向がありそうだ。最適化は容易だが、一般にはベースの目的とは異なる。
それでも新しい最適化器がベースの目的で高得点を取っているなら、両者の目的の違いを、なぜ心配するのだろう。本当に求めているものとの相互作用が問題なのだ。 【トピック:頑健な委任】 価値の仕様化を完全に正しく行っても、訓練集合と実運用の間には、必ず何らかの 分布の変化 がある。アモデイらの「AI安全性の具体的な問題」を参照してほしい。
通常なら小さな分布の変化も、有能なメサ最適化器には大きな違いになりうる。わずかな違いを観測し、自分の目的に利用する方法を見つけるかもしれないからだ。
実際、埋め込まれたエージェンシーという文脈では、「分布の変化」という言葉自体が不適切に思える。世界は独立同分布(i.i.d.)ではない。「分布の変化がない」に相当するのは、 【トピック:埋め込み型世界モデル】 最適化したいものに関係する未来全体の正確なモデルを持ち、それを訓練中に 【トピック:埋め込み型世界モデル】 何度でも実行できることだ。だから私たちは、巨大な「分布の変化」に対処しなければならない。
また、本当に求めるものとは少し異なるものを、最適化したい場合もある。全体の目標を犠牲にして下位目標を追うエージェントを避ける、わかりやすい方法は、サブシステムをエージェント的なものにしないことだ。階段の作り方をいろいろ探索するだけにし、階段を大切にする何かを作らない。
すると問題は、強力なメサ最適化器が、ベースのシステムにとって大切でない何かを最適化しており、しかもメサ最適化器には、エージェントとして振る舞う方向へ収束するインセンティブがあることだ。
さらに、メサ最適化器がベース最適化器の存在に気づく可能性もある。すると、純粋に生き残るためだけに、ベースの目的関数でよい成績を取ろうと意識的に努める一方、訓練を抜け出し、ふりをやめてよいという兆候を探すかもしれない。ニック・ボストロムの 【トピック:頑健な委任】 「裏切りの転換」の一種である。
これは、 【トピック:意思決定理論】 【トピック:頑健な委任】 敵対的グッドハートで見たのと同じ話だ。探索空間にエージェント的な何かがあり、こちらが選んだ代理指標に反応して、その指標を悪いものにしてしまう。
裏切りの転換を避けるため、夢の中にまた夢があるような設定で、「訓練終了、実運用開始」を訓練中に繰り返し模擬することも考えられる。十分な階層のシミュレーションで検査し、本物の実運用でも裏切らないと結論づけるのが目標だ。
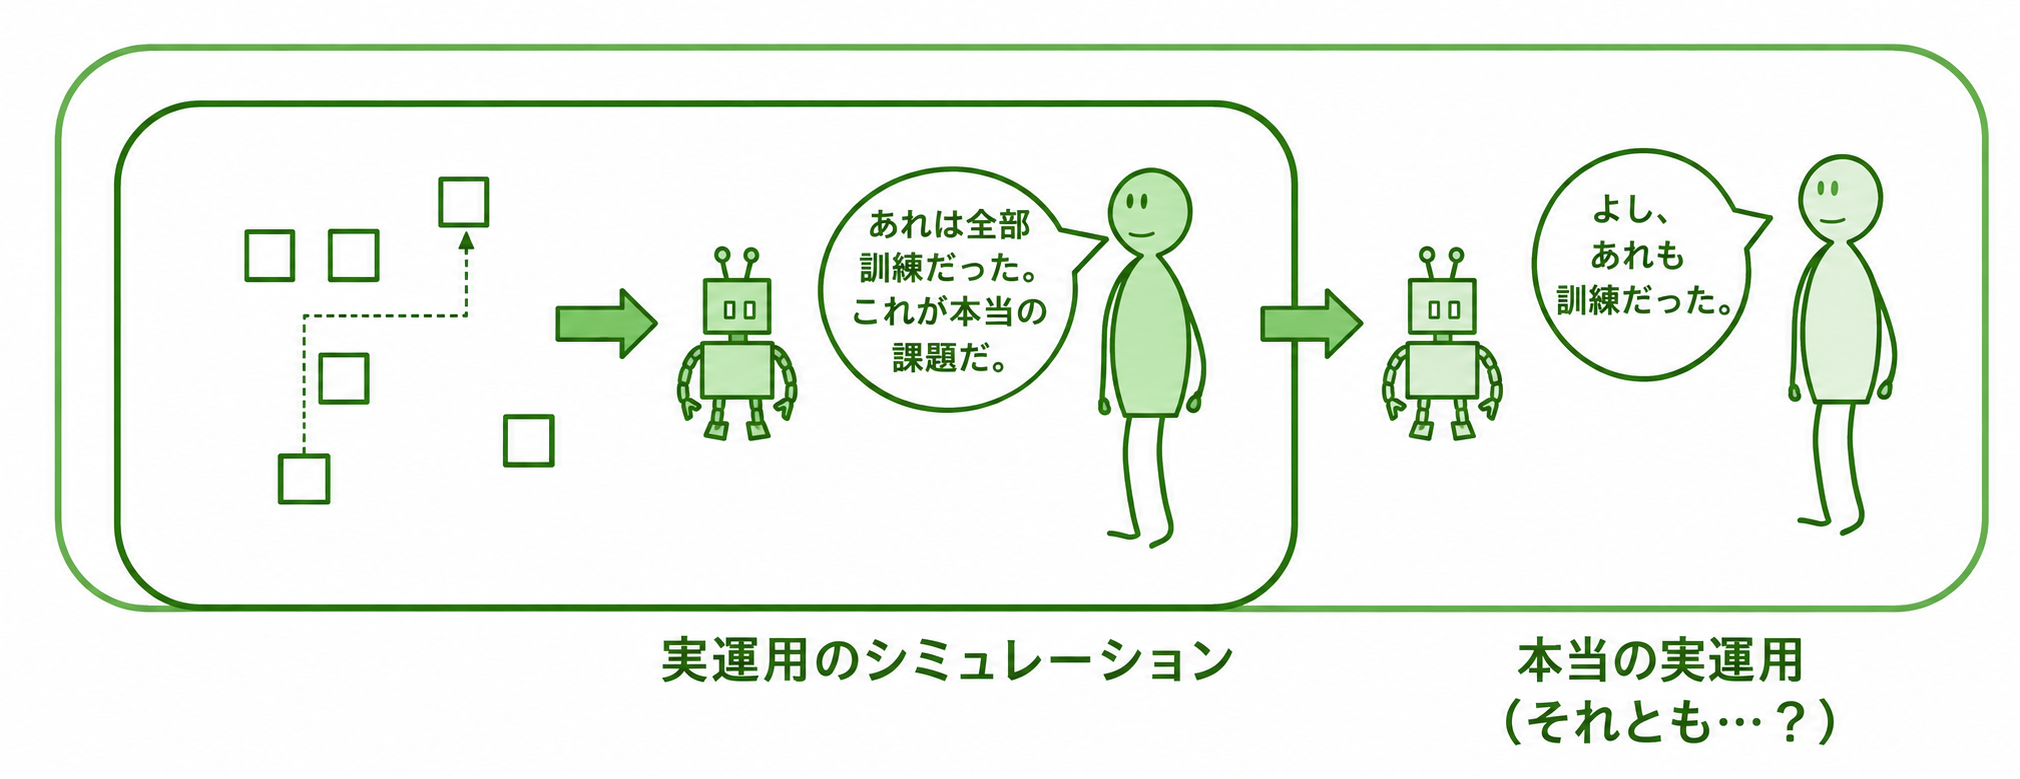
残念ながら、この種の学習の収束は悪くなりそうだ。通常、機械学習で成績がよいとは、平均的な場合の成績がよいことを指す。だが裏切りの転換は、最大の損害を与えるよう慎重に配置できる「誤り」だ。これを起こさないことを確かなものにしたい。
問題の一部は、ほかよりはるかに重要な出力があることだ。実運用は訓練より重要で、実運用中の重大な時点や弱点が露わになる時点は、特に重要になる。単に平均損失を小さくするのでなく、大事なことを確実に正しく行いたい。
しかし、何が重要かをシステムに教えても解決できない。それどころか、私たちはシステムがそれを見抜けないことを望んでいるようだ。重要度の低い例での成績から、重要度の高い例へ一般化できることに賭けているのである。だから、まれな破局や「罠」を避ける機械学習の技法の研究が、メサとベースの最適化器を一致させる問題に関係する。
豊かなモデルクラスから得られるモデルは、任意のコードにほかならない。それを実証的なテストだけで信頼するのは難しい。大きく単純化した問題を考えよう。常に \(1\) だけを出力するプログラムを見つけたい。\(0\) は破局的な失敗である。
自分でコードを調べられるなら、この問題は簡単だ。だが機械学習の出力は解析しにくいことが多い。そこで、コードをまったく理解できないと仮定しよう。
ある意味では、単純な関数のほうを信頼できる。短いコードには、例外が直接書き込まれている可能性が低い。これを数量化してみよう。
長さ \(L\) のプログラムすべての集合を考える。一部のプログラム \(p\) は、長い間 \(1\) を出力した後、\(0\) を出す。これを避けたい。
最初のゼロが出力されるまでの時間を \(W_{p}\) と呼ぶ。プログラム \(p\) が信頼できる、つまり決して \(0\) を出さないなら、\(W_{p} = \infty\) だ。
長さ \(L\) の全プログラムの中で、有限の \(W_{p}\) の最大値は、ビジービーバー関数の一種なので、\(BB(L)\) と呼ぶ。無作為に選んだ長さ \(L\) のプログラムを完全に信頼したいなら、そこから \(BB(L)\) 個の1が出るのを観測する必要がある。
ビジービーバー関数 \(BB(n)\) は、どんな計算可能な関数より速く増大する。したがって、こうした実証的な信頼の形成は、最悪の場合、真実を知るまでに、計算可能な範囲を超えるほど長い時間がかかる。
平均的な場合はどうだろう。
ほかの長さ \(L\) のプログラムがすべて簡単な例だと仮定しよう。長さ \(L\) のプログラムは指数関数的な個数あるので、平均は \(BB(L)\ / \ \mathrm{exp}(L)\) となる。だが、指数関数は計算可能だ。そのため、\(BB(L)\ / \ \mathrm{exp}(L)\) も、どの計算可能な関数より速く増大する。
したがって、短いプログラムを使えば理論上はある程度の確信が得られても、振る舞いについて一般化された結論を出す難しさは、長さの関数として急激に増える。
長さの制限があまり実用的でないなら、計算量の制限が役立つだろうか。直感的には、メサ最適化器が裏切りの転換を成功させるには、考える時間が必要だ。したがって、もっと早く結論に達するプログラムのほうが、信頼できるかもしれない。
しかし残念ながら、計算量クラスを制限しても、ビジービーバー型の振る舞いは避けられない。長く待ってから \(0\) を出す戦略は、プログラム長 \(L\) を少し増やすだけで、さらに遅らせられる。
どれも仮説的すぎると思うなら、地球上の生命の進化を考えてみよう。進化は、繁殖上の適応度を最大化するものと捉えられる。
実際には、進化はいろいろなものの最適化器とも、そもそも最適化器でないとも考えられるが、ここでは重要ではない。要点は、繁殖適応度を最大化したいエージェントがいたら、進化のようなシステムを使うかもしれない、ということだ。
知的な生物は、進化のメサ最適化器である。その欲求は、確かに繁殖適応度と相関するが、生物は実にさまざまなものを求める。進化を理解し、ときにはそれを操作するに至ったメサ最適化器さえいる。ならば、少なくとも十分な処理能力があれば、強力でアラインしていないメサ最適化器は、現実にありうるようだ。
問題が生じるのは、まだ解き方を知らない問題を解こうとして、 【トピック:埋め込み型世界モデル】 巨大な空間を探索し、「誰か」が解いてくれると期待するためのように見える。
大量の探索で問題を解くことが問題の源なら、別の解き方を探すべきかもしれない。物事を理解して解くべきかもしれない。だが、まだ解き方を知らない問題を、試してみる以外の方法で、どう解けばよいのだろうか。
一歩引いてみよう。
【トピック:埋め込み型世界モデル】 埋め込まれた世界モデルは、世界に埋め込まれたエージェントとして、そもそもどう考えるかを扱う。 【トピック:意思決定理論】 意思決定理論は、どう行動するかを扱う。 【トピック:頑健な委任】 頑健な委任は、信頼できる後継者と助け手の作り方を扱う。 【トピック:サブシステム・アライメント】 サブシステムのアラインメントは、信頼できる 部品 から 一つの エージェントを作ることを扱う。
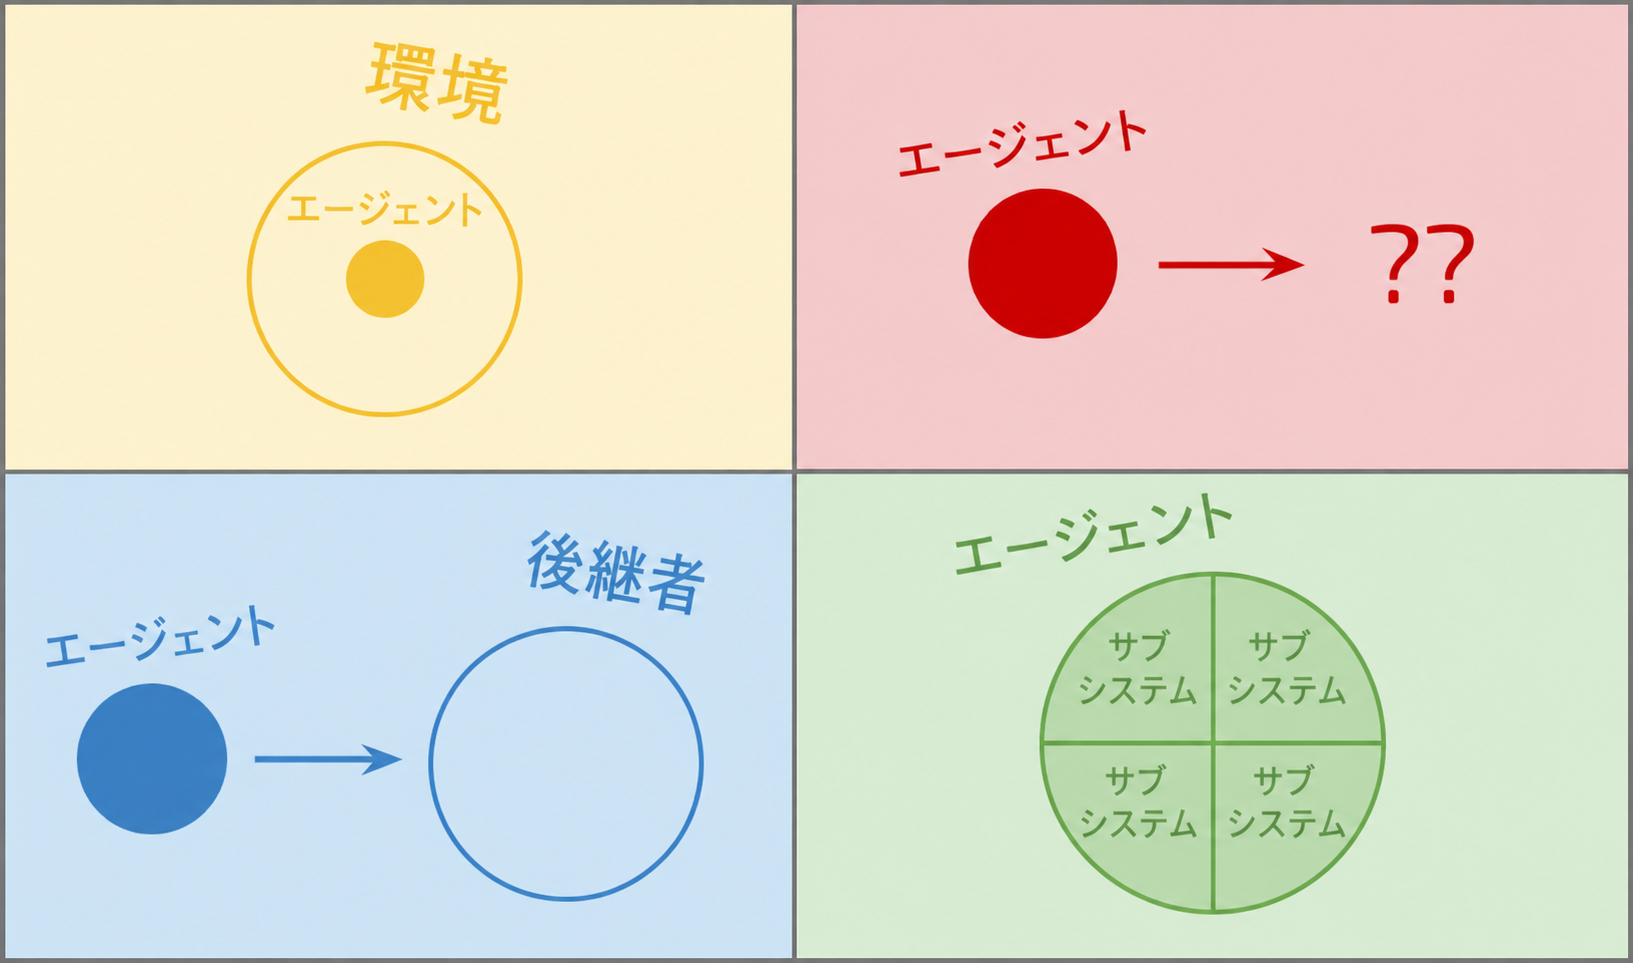
問題は、こういうことだ。
- 自分が環境より 【トピック:埋め込み型世界モデル】 小さいときに、その環境をどう考えるかがわからない。
- それが できる 範囲でも、その環境での 【トピック:意思決定理論】 行動の帰結をどう考えるかがわからない。
- それもできたとして、 【トピック:頑健な委任】 自分が何を 求める のかをどう考えるかがわからない。
- これらの問題が一つもなくても、求めるものを得られる 【トピック:サブシステム・アライメント】 行動を、確実に出力する方法がわからない!
これは、スコット・ガラブラントとエイブラム・デムスキーの埋め込まれたエージェンシー連載の、最後から二番目の記事である。結び:埋め込まれたエージェントをめぐる好奇心。