
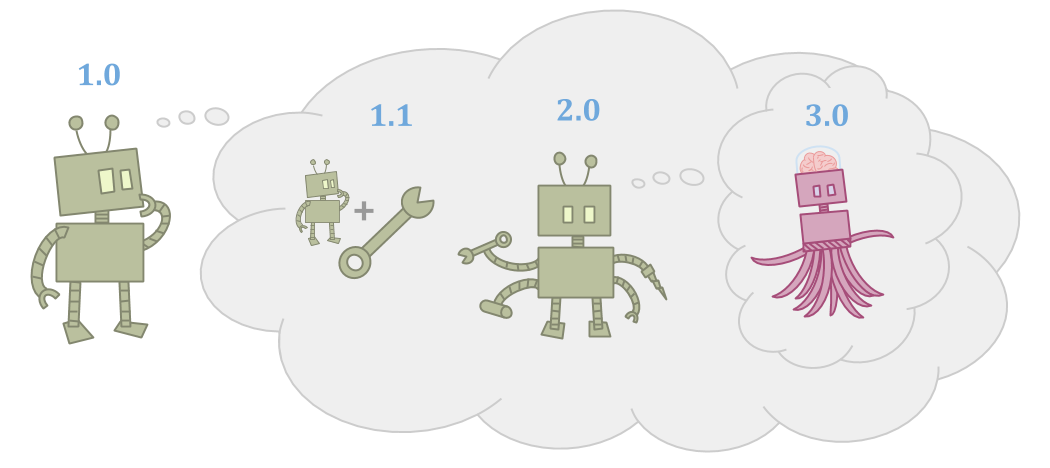
【トピック:埋め込み型世界モデル】 世界は大きいため、現在のエージェントのままでは、思考能力も含め、その目標を達成するのに不十分かもしれない。
エージェントは 【トピック:サブシステム・アライメント】 部品からできているため、自分自身を改良して能力を高められる。
改良には多くの形があり得る。エージェントは道具を作ることも、後継エージェントを作ることも、単に時間をかけて学習・成長することもできる。しかし、それが有益であるには、後継エージェントや道具の能力が元より高くなければならない。
ここから、特殊な本人・代理人問題(principal-agent problem)が生じる。
初期エージェントと後継エージェントがいる。初期エージェントは後継エージェントがどのようなものになるかを、厳密に決定できる。しかし、後継エージェントは初期エージェントよりはるかに知的で強力である。後継エージェントに初期エージェントの目標を頑健に最適化させるにはどうすればよいかを、私たちは知りたい。
この本人・代理人問題が取り得る形の例を三つ挙げよう。
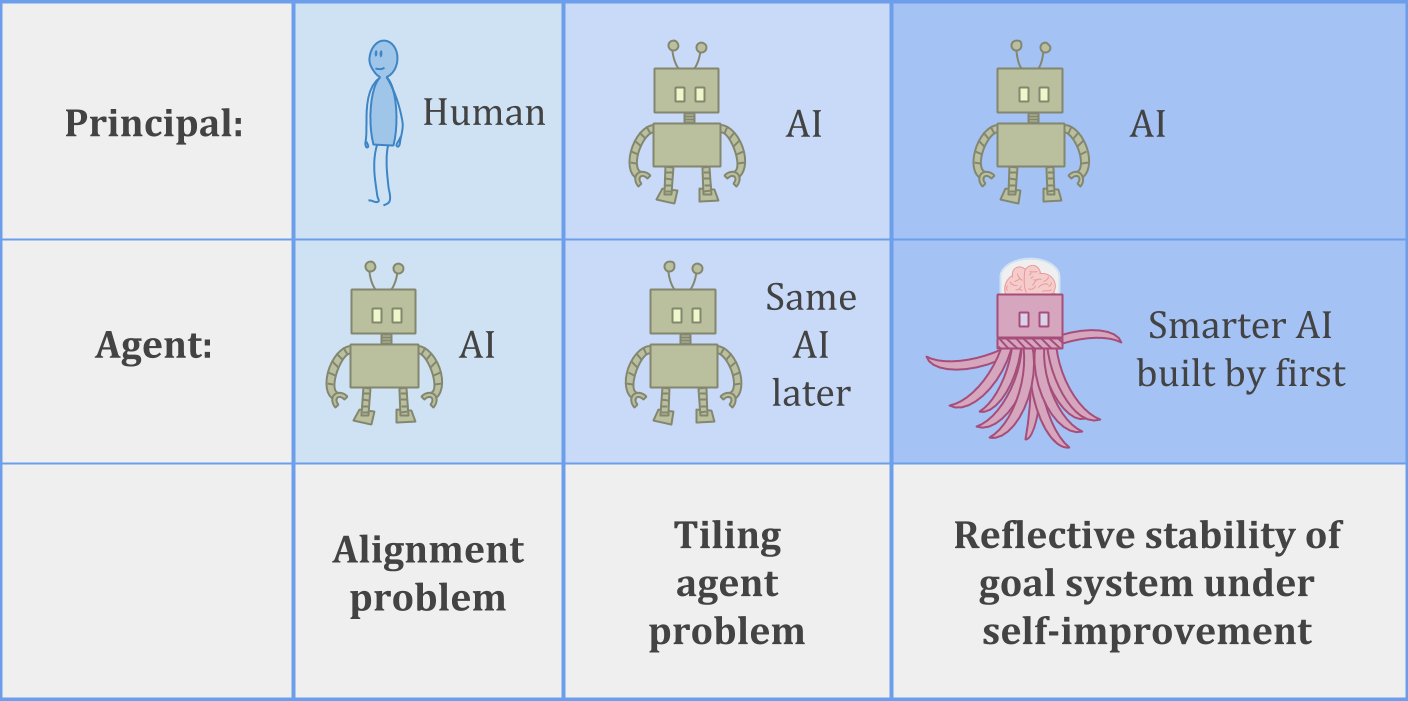
AIアライメント問題では、人間が、自分の目標を助けてくれると信頼できるAIシステムを構築しようとする。
タイリング・エージェント問題では、エージェントが、自分の将来の各時点の自己を、自分の目標に役立つ存在として信頼できるようにしようとする。
あるいは、タイリング問題のさらに難しい版――安定した自己改良――も考えられる。そこでは、AIシステムが自分より知的でありながら、なお信頼できて有用な後継エージェントを構築しなければならない。
AIを一切含まない人間の類比なら、王制における継承の問題を考えてもよい。より一般的には、時間が経っても目的を見失わず、望ましい目標を達成する組織を設立する問題である。
難しさは二つあるように思われる。
第一に、人間やAIエージェントは、自分自身や自分の目標を完全には理解していないかもしれない。何を望むのかを厳密かつ詳細に書き出せないエージェントにとって、後継エージェントがその目標を頑健に助けると保証するのは難しい。
第二に、作業を委任する発想の要点は、自分ですべての作業を行わなくてよいことである。後継エージェントには、自分が知らない新しい事柄を学んだり、新しい技能や能力を行使したりすることも含め、ある程度自律して行動してほしい。
極限まで考えるなら、頑健な委任について本当に優れた形式的説明は、どれほど能力の高い後継エージェントでも、誤りを起こさず扱えるはずだ。たとえば、人間やAIが信じがたいほど賢いAIを構築する場合や、エージェントが何年も学習と成長を続け、過去の自分よりはるかに賢くなる場合である。
問題は、後継エージェントが悪意を持つかもしれないということ(だけ)ではない。悪意を持たないとは何を意味するのかすら、私たちには分からないことが問題なのだ。
この問題は、どちらの観点から見ても難しそうである。
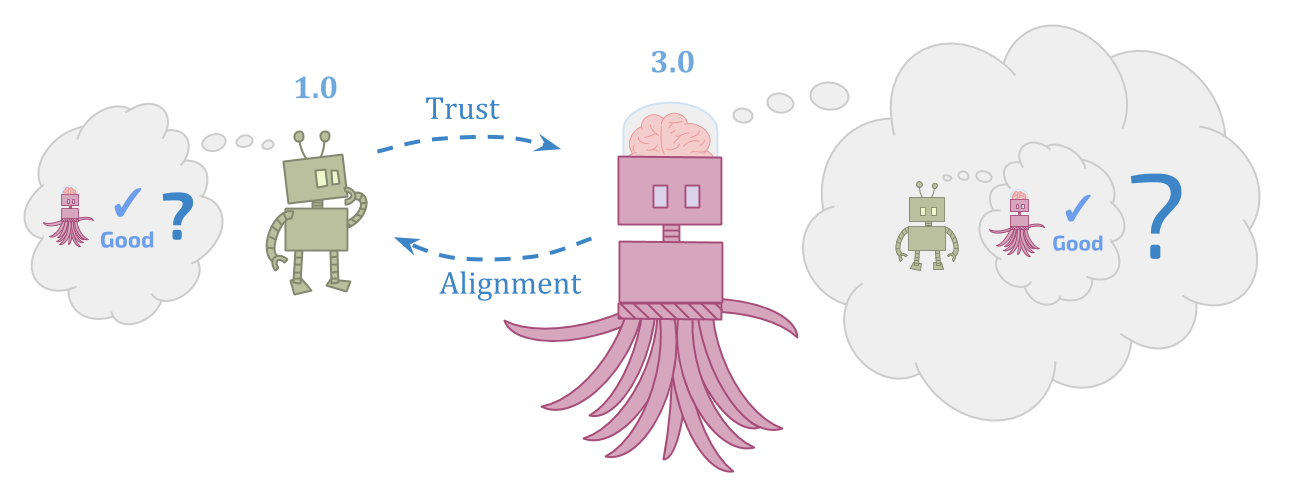
初期エージェントは、自分より強力なものがどれほど信頼性に富み、信頼に値するかを見極める必要があり、これは非常に難しそうだ。しかし後継エージェントも、初期エージェントには理解すらできない状況で何をすべきかを見極め、後継エージェントから見れば矛盾しているものの目標を尊重しようとしなければならない。これも非常に難しそうである。
一見すると、これは「 【トピック:意思決定理論】 意思決定を行う」や「 【トピック:埋め込み型世界モデル】 モデルを持つ」より基礎的でない問題に思えるかもしれない。しかし、「後継エージェントを構築する」問題に複数の形があるという見方自体が、二元論的な見方である。
埋め込まれたエージェントにとって、将来の自己は特権的なものではない。環境の別の一部にすぎない。自分の目標を共有する後継エージェントを構築することと、単に自分自身の目標が時間とともに変わらないようにすることの間には、深い違いはない。
したがって、ここでは「初期」エージェントと「後継」エージェントについて語るが、これは現在の人間が直面する、後継エージェントを正しい方向へ向けるという狭い問題だけではないことを覚えておいてほしい。これは、時間を通じて存続し学習するエージェントであることの根本問題を扱っている。
この問題群を 【トピック:頑健な委任】 頑健な委任(Robust Delegation) と呼ぶ。例には次のものがある。
CIRLゲームを幼児と行っていると想像しよう。
CIRLはCooperative Inverse Reinforcement Learning(協調型逆強化学習)の略である。CIRLの発想は、ロボットが人間と協力するとはどういうことかを定義することだ。ロボットは、人間が何を望むかを解明しようとしながら、役立つ行動を選ぼうとする。
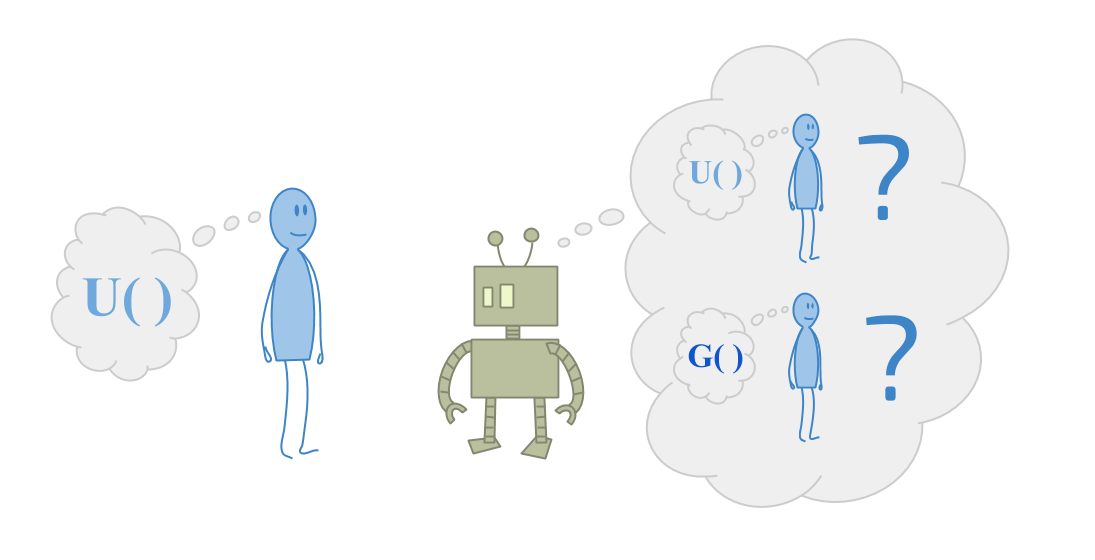
頑健な委任に関する現在の研究の多くは、AIシステムを人間の望むものにアラインメントするという目標から生じている。そのため通常は、人間の観点からこの問題を考える。
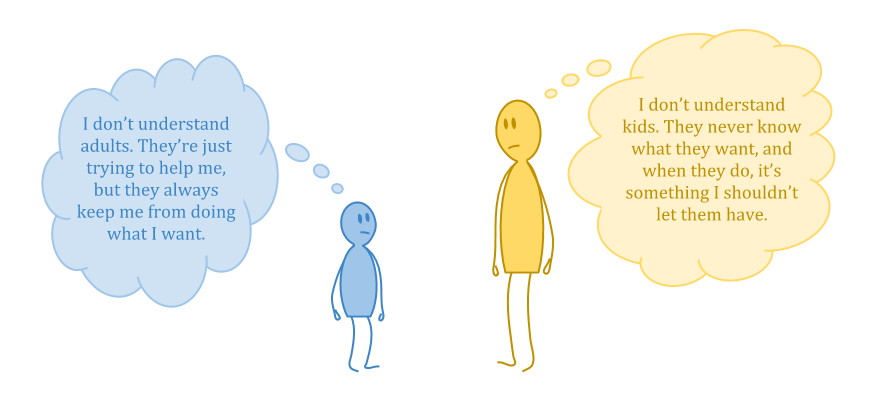
しかしここで、宇宙について非常に混乱している相手を助けようとする、賢いロボットが直面する問題を考えよう。幼児が自分の目標を最適化するのを助ける場面を想像してほしい。
- あなたの観点からは、幼児は非合理的すぎて、何かを最適化しているとはみなせないかもしれない。
- 幼児は何かを最適化しているオントロジー(世界を捉える概念体系)を持っているかもしれないが、あなたにはそのオントロジーが筋の通らないものだと分かる。
- 質問の仕方をうまく設定すれば、幼児がほとんど何でも望んでいるように見せられる、と気づくかもしれない。
問題の一部は、「助ける」エージェントがより高い能力を持つためには、ある意味でより 【トピック:埋め込み型世界モデル】 大きくなければならないことだ。しかしこれは、「助けられる」エージェントが「助ける側」を十分に監督できないことを含意するように思える。
たとえば、 【トピック:意思決定理論】 更新不要意思決定理論は、知っていることを条件に自分の行動の期待効用を最大化する代わりに、無知な状態から観測への反応の期待効用を最大化することで、意思決定理論における動的不整合を取り除く。

これは反射的整合性を達成する方法として魅力的かもしれないが、計算複雑性の点で奇妙な状況を生む。 【トピック:意思決定理論】 行動の型が \(A\)、 【トピック:意思決定理論】 観測の型が \(O\) なら、観測への反応の型は \(O \to A\) であり、\(A\) だけよりはるかに大きな最適化空間になる。しかも私たちは、それを 【トピック:埋め込み型世界モデル】 より小さな自己が実行できると期待しているのだ!
これはまずそうだ。
この問題をより明確に述べる一つの方法はこうである。将来の自己が具体的に何をするかを正確に予測できなくても、将来の自己がその知能を自分の目標の追求に用いていると信頼できるべきである。この基準をヴィンジ的内省と呼ぶ。
たとえば、新しい都市を訪れる前に車で走る経路は計画しても、一歩一歩の足運びまでは計画しない。ある詳しさの水準までは計画し、残りは将来の自分が解決できると信頼する。
ヴィンジ的内省を古典的なベイズ意思決定理論で検討するのは難しい。ベイズ意思決定理論は 【トピック:埋め込み型世界モデル】 論理的全知を仮定するからである。論理的全知のもとでは、「エージェントは自分の将来の行動が合理的だと知っている」という仮定は、「エージェントは将来の自己が、事前に予測できるある一つの最適方策に従って行動すると知っている」という仮定と同義になる。
ヴィンジ的内省については、いくつかの限られたモデルがある(ユドコウスキー(Yudkowsky)とヘレスホフ(Herreshoff)による「Tiling Agents for Self-Modifying AI, and the Löbian Obstacle」を参照)。成功するアプローチは、二つの問題の間の狭い道を進まなければならない。
- ローブ的障害:自分自身の推論の出力を信頼することを根拠に将来の自己を信頼するエージェントは、無矛盾ではない。
- 先延ばしのパラドックス:根拠なしに将来の自己を信頼するエージェントは、無矛盾ではあるものの健全でも信頼できるものでもない傾向があり、後でもできるという理由でタスクを永遠に先延ばしする。
これまでのヴィンジ的内省の成果は、許容可能性の閾値を目指す満足化主体(satisficer)など、限られた種類の意思決定手続きにしか当てはまらない。したがって、より有用な意思決定手続きについて、より弱い仮定のもとでタイリングの成果を得るなど、改善の余地は大きい。
しかし、頑健な委任の問題には、タイリングとヴィンジ的内省だけにとどまらない側面がある。
将来の自己へ委任するのではなく、別のエージェントを構築するときには、価値の読み込みという問題に、より直接向き合うことになる。
ここでの主な問題は次のとおりである。
- 私たちは、自分が何を望むのかを知らない。
- 最適化は、私たちが望むと言うものと本当に望むものとのわずかな差を増幅する。
この誤指定を増幅する効果は、グッドハートの法則として知られる。名称は、チャールズ・グッドハート(Charles Goodhart)の次の観察に由来する。「観察された統計的規則性はどれも、それを管理目的で制御しようと圧力をかけると崩壊する傾向がある。」
最適化の対象を指定するとき、その対象は私たちが望むものと相関していると期待するのが妥当である。場合によっては強く相関している。しかし残念ながら、これは、その対象を最適化すれば私たちが望むものに近づくことを意味しない。最適化の度合いが高い場合には特にそうである。
グッドハートには(少なくとも)四つの類型がある。回帰的、極端な、因果的、敵対的グッドハートである。
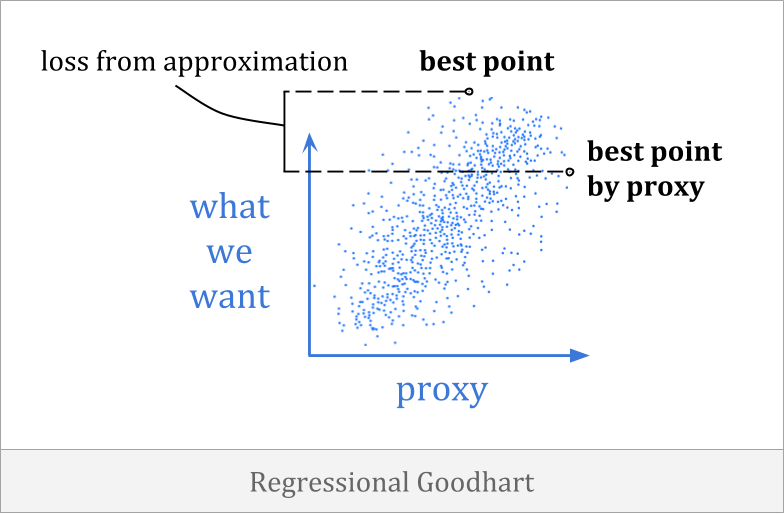
回帰的グッドハートは、代理指標と目標の相関が完全ではない場合に起こる。これは一般に最適化者の呪いとしてよく知られており、平均への回帰と関係する。
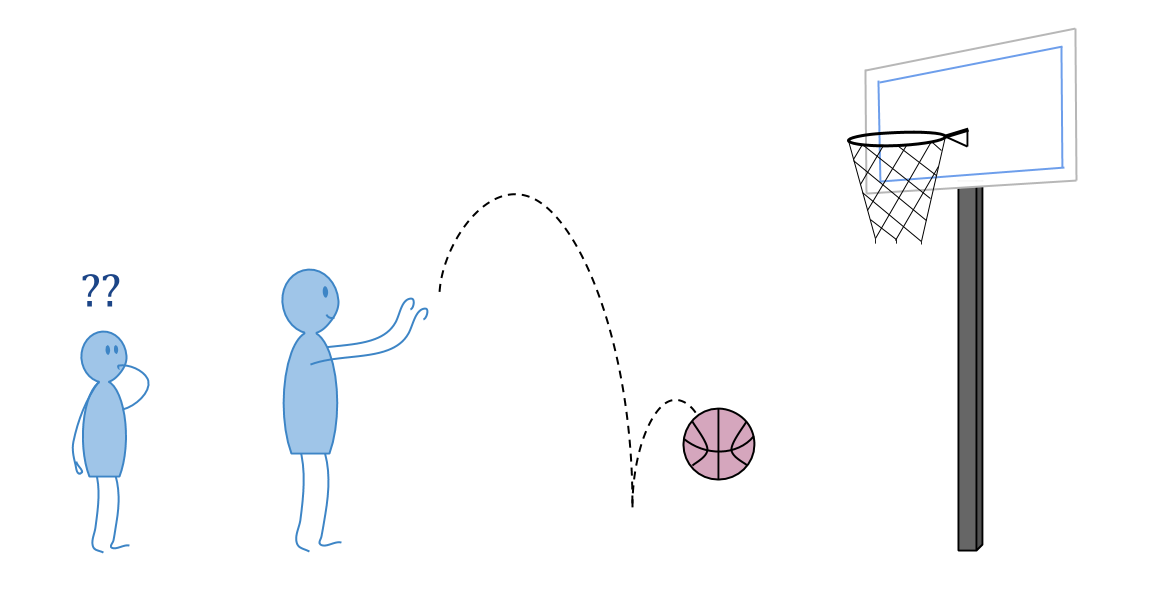
回帰的グッドハートの例として、身長だけに基づいてバスケットボール・チームの選手を指名する場合を考えられる。これは完全なヒューリスティックではないが、身長とバスケットボール能力には相関があり、選択に利用できる。
一般的な傾向が選抜したチームでも同じ強さで成り立つと期待すれば、ある意味で、予測可能な形で失望することになる。
統計学の言葉で述べると、\(x\) が与えられたときの \(y\) の不偏推定量は、最良の \(x\) を選抜したときには \(y\) の不偏推定量ではない。その意味で、最適化のために \(x\) を \(y\) の代理指標として使うと、失望することが予想される。
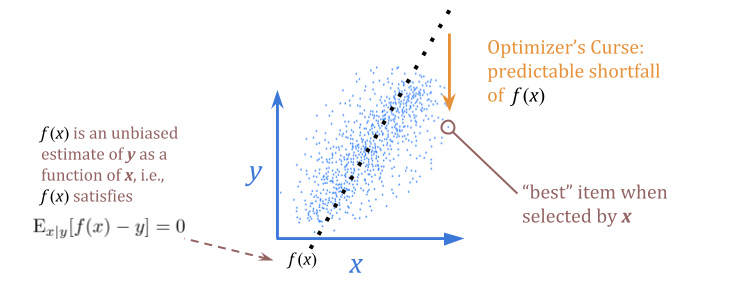
(この節のグラフは、関連概念を説明する助けとなるよう手描きしたものである。)
不偏推定量の代わりにベイズ推定量を用いれば、この種の予測可能な失望を取り除ける。ベイズ推定量は \(x\) のノイズを考慮し、典型的な \(y\) の値へ寄せる。
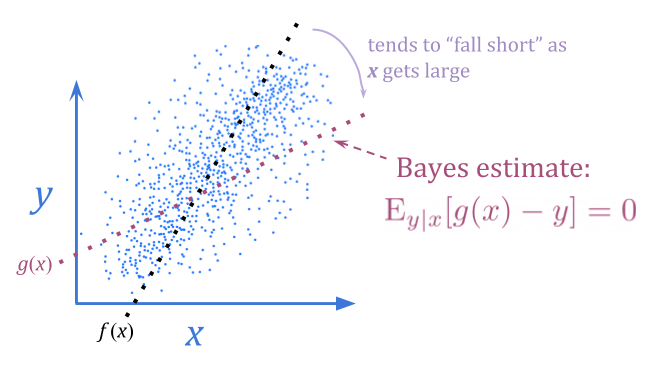
扱える情報は依然として \(x\) の情報量だけなので、これで必ずしもよりよい \(y\) の値を得られるとは限らない。しかし、得られる場合もある。\(y\) が分散 \(1\) の正規分布に従い、\(x\) が等しい確率で \(+\) または \(-\) となる \(y \pm 10\) なら、ベイズ推定量はノイズをほぼ完全に取り除くことで、よりよい最適化結果をもたらす。
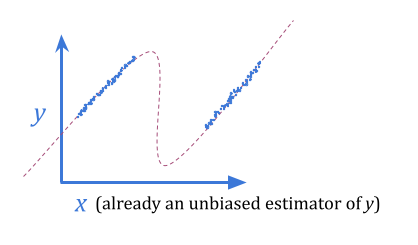
回帰的グッドハートは、最も克服しやすい形のグッドハートのように思える。単にベイズ推定を使えばよい!
しかし、この解決策には二つの大きな問題がある。
- 関心のある多くの場合に、ベイズ推定量は計算上扱えない。
- ベイズ推定量を信頼することが理にかなうのは、 【トピック:埋め込み型世界モデル】 実現可能性の仮定のもとに限られる。
この両方の問題が決定的になる例が、計算論的学習理論である。
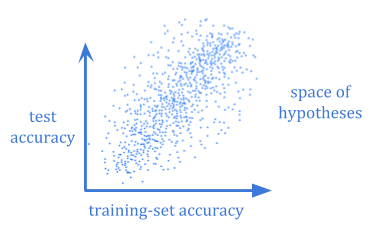
仮説のベイズ的な期待汎化誤差を計算するのは、計算上実行可能でないことが多い。たとえ計算できても、選んだ事前分布が世界を十分よく反映しているかは、なお疑わなければならない。
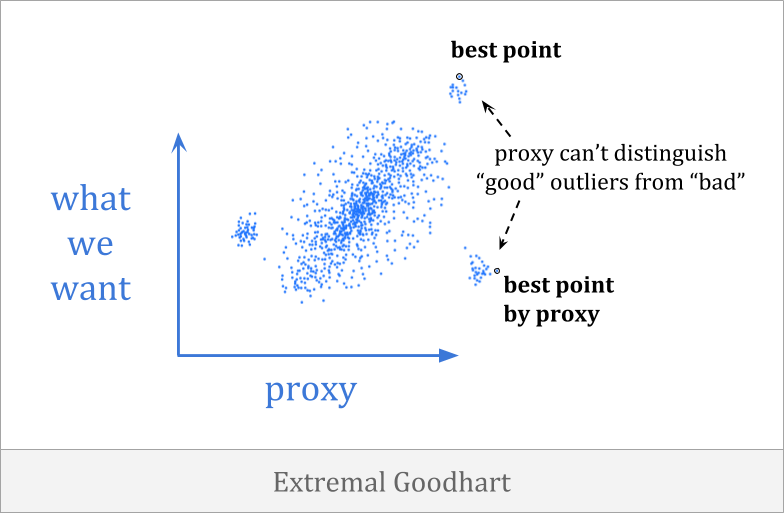
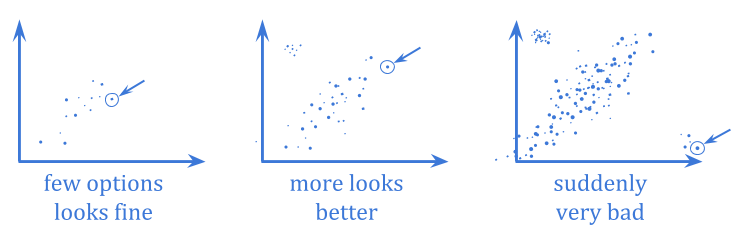
極端なグッドハートでは、最適化によって相関が成り立つ範囲の外へ押し出され、分布のうち、それまでとは大きく異なる振る舞いをする部分へ入る。
これが特に恐ろしいのは、最適化器が異なる状況でまったく異なる振る舞いをする傾向を生み、しかも事前の警告がほとんど、あるいはまったくない場合が多いためである。最適化が弱いときには代理指標が破綻する様子をまったく観察できなくても、最適化が十分強くなると、まったく異なる領域へ入り得る。
極端なグッドハートと回帰的グッドハートの違いは、古典的な補間と外挿の区別に関係する。
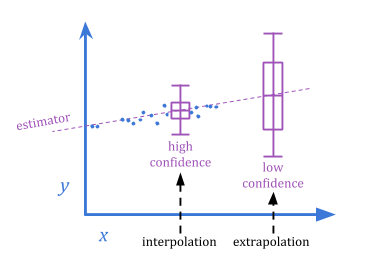
極端なグッドハートでは、システムを大規模化するにつれて振る舞いが急変するため、回帰的グッドハートより予測しにくい。
回帰的な場合と同じく、可能なリスクを確率分布が十分よく反映すると信頼するなら、原理上はベイズ的な解決策でこの懸念に対処できる。しかし、ここでは実現可能性への懸念がさらに際立つように思われる。
提案が、特定の事前分布からよく見えるよう高度に最適化されているとき、その事前分布が提案の問題を予測すると信頼できるだろうか。そのような条件では、人間の判断が信頼できないことは確かだ。この観察は、システムの価値判断が人間の判断を完全に反映するとしても、問題は残ることを示唆する。
問題を次のように述べることもできる。「典型的な」出力は極端なグッドハートを避けるが、「最適化しすぎる」と典型的なものの領域を外れる。
しかし、「最適化しすぎる」を意思決定理論の言葉でどう形式化できるだろうか。
クォンタライゼーションは、「ある程度は最適化するが、しすぎない」を形式化する。
代理指標 \(V(x)\) を、本当に望む関数 \(U(x)\) が「損なわれた」版だと想像しよう。損なわれ方が大きい領域と小さい領域があるかもしれない。
さらに、平均誤差がある閾値 \(c\) 未満であると確信できる、「信頼された」確率分布 \(P(x)\) を指定できるとしよう。
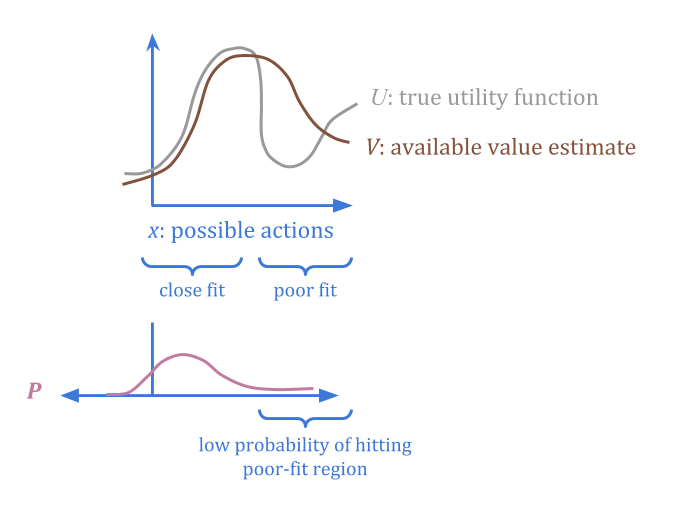
\(P\) と \(c\) を定めることで、\(U\) の推定値も、どの一点における実際の誤差の推定値も必要とせずに、誤差の小さい点がどこにあるかという情報を与えられる。
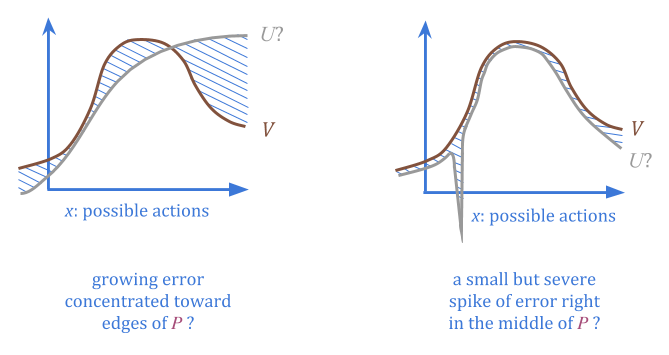
\(P\) から行動を無作為に選ぶなら、それでも誤差が大きくなる確率は低いと確信できる。
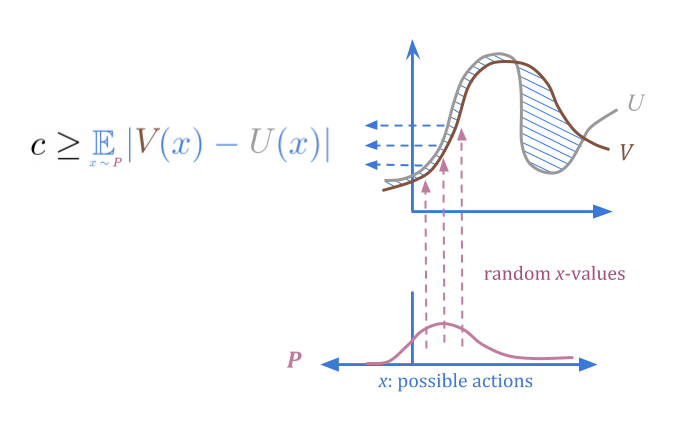
では、これを最適化にどう使うのか。クォンタライザー(quantilizer、分位点にもとづく選択器)は \(P\) から選ぶが、上位の割合 \(f\)(たとえば上位1%)以外をすべて捨てる。この図では、外れ値ではなく「典型的な」選択肢に確率の大部分がまだ集中する割合を、慎重に選んでいる。
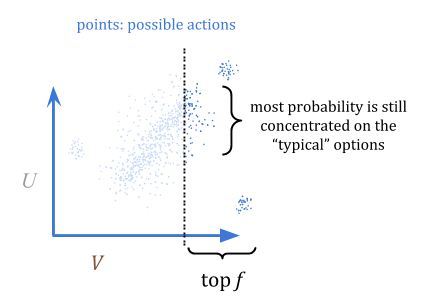
クォンタライゼーションを行えば、何かがどれほどよいかを過大評価している場合でも、期待値で最大 \(\frac{c}{f}\) しか過大評価しないと保証できる。最悪の場合でも、過大評価がすべて上位 \(f\) の選択肢に集中するからである。
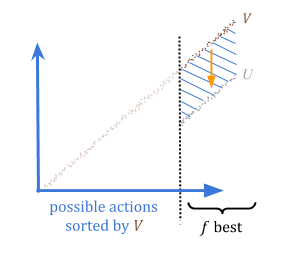
したがって、許容可能なリスク水準 \(r = \frac{c}{f}\) を選び、パラメーター \(f\) を \(\frac{c}{r}\) に設定できる。
クォンタライゼーションには、いくつかの点で大きな魅力がある。クラス内の個々の行動をすべて信頼しなくても――さらにはクラス内のどの個別行動も信頼しなくても――安全な行動クラスを指定できるからだ。
十分大きなリンゴの山に腐ったリンゴが一つしかないなら、無作為に選んでも安全である可能性は非常に高い。「最適化の度合いを抑え」、十分よい行動から一つを無作為に選ぶことで、本当に極端な選択肢の確率を低くする。対照的に、可能な限り強く最適化したなら、悪いリンゴだけから選ぶ結果になったかもしれない。
しかし、このアプローチにも不満な点は多い。「信頼された」分布はどこから来るのか。期待誤差 \(c\) をどう推定し、許容可能なリスク水準 \(r\) をどう選ぶのか。クォンタライゼーションは危険なアプローチである。\(r\) という、回すほど性能が向上するように見える一方でリスクも高まり、やがて(おそらく突然)破綻するつまみを与えるからだ。
さらに、クォンタライゼーションはタイリングしそうにない。つまり、クォンタライザー型のエージェントには、自分を改良したり新しいエージェントを構築したりするときに、クォンタライゼーション・アルゴリズムを維持する特別な理由がない。
したがって、極端なグッドハートへの対処法には改善の余地があるように思われる。
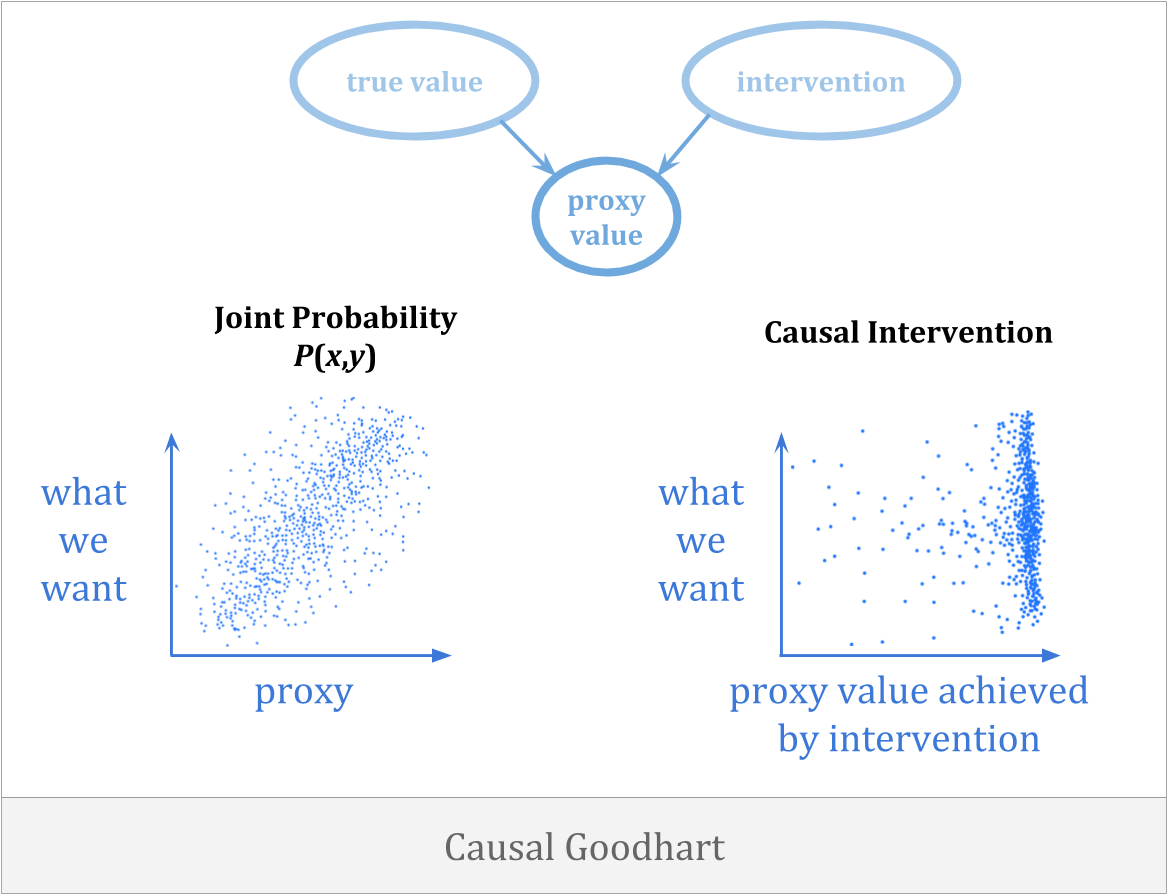
最適化が失敗するもう一つの形は、代理指標について選抜する行為が、私たちの関心対象とのつながりを壊す場合である。因果的グッドハートは、代理指標と目標の間に相関を観察したものの、代理指標を増やすために介入すると目標が増えない場合に起こる。観察された相関が、正しい形で因果的ではなかったためである。
因果的グッドハートの例として、傘を持ち歩くことで雨を降らせようとする場合を考えられる。この種の誤りを避ける唯一の方法は、 【トピック:意思決定理論】 反実仮想を正しく扱うことである。
これは意思決定理論へ問題を丸投げしているように見えるかもしれないが、ここでのつながりは、頑健な委任と意思決定理論の双方を豊かにする。
【トピック:意思決定理論】 反実仮想は、タイリングへの懸念、すなわち意思決定者が自分の将来の決定について推論する必要があることから生じる、信頼上の懸念に対処しなければならない。同時に、因果的グッドハートがあるため、 【トピック:頑健な委任】 信頼も反実仮想上の懸念に対処しなければならない。
【トピック:埋め込み型世界モデル】 ここでも大きな課題の一つは実現可能性である。埋め込まれた世界モデルの議論で述べたように、反実仮想が一般にどう機能するかについて正しい理論があっても、実現可能性を仮定しない限り、行動を適切に選べるよう学習するという保証をベイズ学習はあまり与えない。
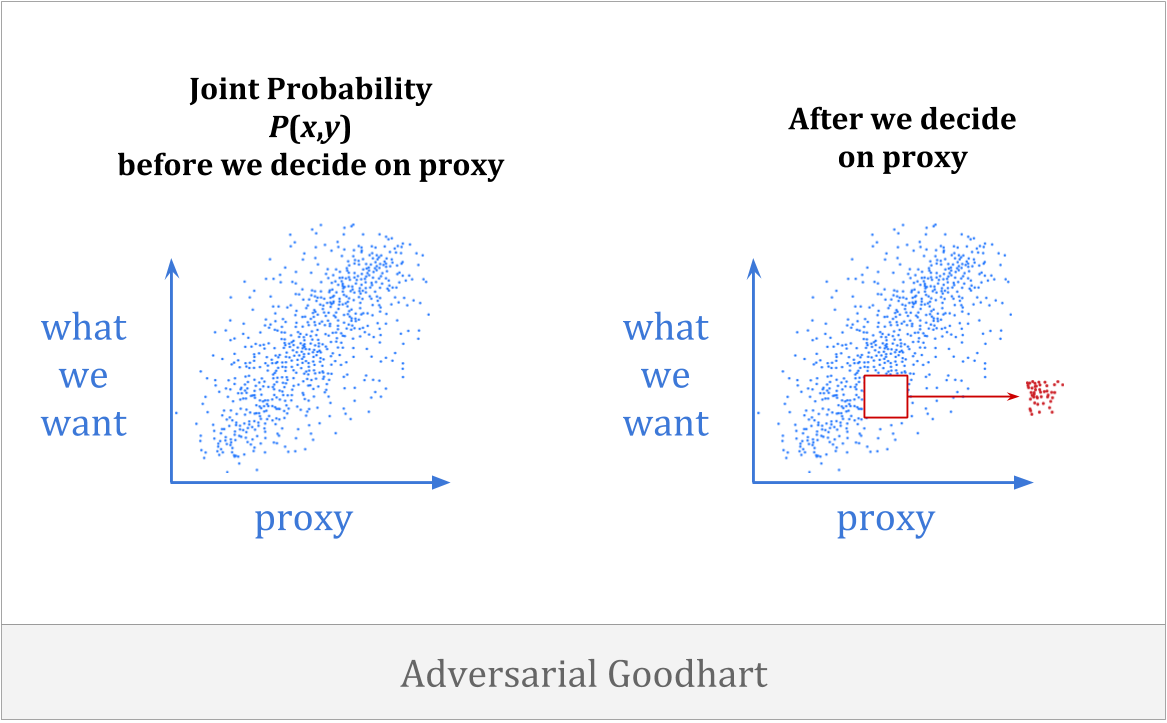
最後は敵対的グッドハートであり、そこではエージェントが知的に操作することで、私たちの代理指標を積極的に悪化させる。
グッドハートの指摘を解釈するとき、人々が最もよく思い浮かべるのはこのカテゴリーである。一見したところ、ここでの懸念にはそれほど関係しないように思えるかもしれない。私たちは、エージェントが将来の自己を信頼する方法や、ゼロから構築した助力者を信頼する方法を、形式的に理解したい。それと敵対者に何の関係があるのだろうか。
短く答えると、十分豊かな 【トピック:埋め込み型世界モデル】 大きな空間を探索するとき、その空間には敵対的戦略を実装する要素が必ずいくつかある。最適化一般を理解するには、十分に賢い最適化器が敵対的グッドハートをどう回避できるかを理解する必要がある。( 【トピック:サブシステム・アライメント】 サブシステム・アライメントの議論で、この点に戻る。)
グッドハートの法則の敵対的変種は、最適化の度合いが低い段階ではさらに観察しにくい。敵対者はテスト期間が終わるまで操作を始めたがらないうえ、システム自身の最適化から生じる敵対者は、最適化が十分強力になるまで現れないからである。
グッドハートの法則のこの四つの形は、まったく異なる仕組みで働く。そして大まかにいえば、最適化能力が高まるにつれて、まず回帰的グッドハート、次に因果的、極端な、敵対的グッドハートという順に現れ始める傾向がある。したがって、その一部を解決したからといって、グッドハートの法則を克服したと考えないよう注意してほしい。
反グッドハート策に加え、自分たちが望むものを正確に指定できれば、明らかに役立つ。システムが代理指標ではなく私たちの望むものを直接最適化していたなら、これらの問題はどれも生じないことを思い出してほしい。
残念ながら、これは難しい。では、構築しているAIシステムにこの作業を助けてもらえるだろうか。
より一般的には、後継エージェントは、前任エージェントがこの問題を解くのを助けられるだろうか。自分の知的優位性を使って、私たちが何を望むかを解明できるだろうか。
AIXIは、環境から得る報酬信号を通じて何をすべきかを学ぶ。人間がボタンを持ち、AIXIが好ましいことを行ったときに押すと想像できる。
問題は、AIXIが報酬ボタンを支配するという問題に、その知能を用いることである。これが ワイヤーヘディング の問題だ。
この種の振る舞いは、事前に予測するのが非常に難しい可能性がある。システムは訓練中、意図どおりに振る舞うふりをし、配備後に支配権を握る計画を立てるかもしれない。これを「裏切りの転回(treacherous turn)」と呼ぶ。
報酬を発行するブラックボックスとして、報酬ボタンをエージェントの内部に組み込めるかもしれない。その箱自体を、人間がどの報酬を与えたいかを解明する 【トピック:サブシステム・アライメント】 知的な下位エージェントにすることもできる。さらに、その箱を変更しようとする行動には罰を与えることで、箱に自己防衛させることもできる。
しかし結局、エージェントが状況を理解すれば、それでも支配権を握る動機を持つ。
エージェントに「ボタン」や「箱」から高い出力を得るよう命じれば、それらをハッキングする動機を持つ。しかし、計画の予想結果を実際の報酬発行箱に通すなら、箱をハッキングする計画は箱そのものによって評価され、箱はその発想を好ましいとは判断しない。
ダニエル・デューイ(Daniel Dewey)は、後者のエージェントを観測効用最大化器と呼ぶ。(観測効用エージェントを、より一般的な強化学習の概念に含める人もいる。)
RLエージェントのワイヤーヘディングを止めるためさまざまなことを試しても、エージェントはそれに逆らい続ける。それなのに、観測効用エージェントへ切り替えると問題が消える。この点は非常に興味深いと思う。
しかし、\(U\) を指定するという問題はなお残る。ダニエル・デューイが指摘するように、観測効用エージェントも、学習を用いて時間とともに \(U\) を近似できる。ただし、\(U\) をブラックボックスとして扱うことはできない。RLエージェントは報酬関数を予測することを学ぼうとするが、観測効用エージェントは、人間が指定した価値学習の事前分布から推定された効用関数を用いる。
しかし、ほかの問題を引き起こさない学習過程を指定することは、なお難しい。たとえば、人間が望むものを学習しようとするなら、 【トピック:埋め込み型世界モデル】 世界の中の「人間」をどう頑健に特定するのか。統計的にそこそこ優れた物体認識にすぎなければ、再びワイヤーヘディングへつながり得る。
その問題をうまく解決しても、エージェントは人間の中に価値を正しく見いだす一方、人間の価値観を満たしやすいものへ変える動機をなお持つかもしれない。たとえば、人間の選好を、ある薬物を使用することだけに関心を持つよう変える薬物があるとしよう。観測効用エージェントは、自分の仕事を容易にするため、その薬物を人間に与える動機を持ち得る。これを人間操作問題と呼ぶ。
真の価値の保管場所だと印をつけたものは、何であれハッキングされる。これが四種類のグッドハートのいずれかなのか、五つ目なのか、それともまったく別のものなのかはともかく、一つの主題であるように思われる。
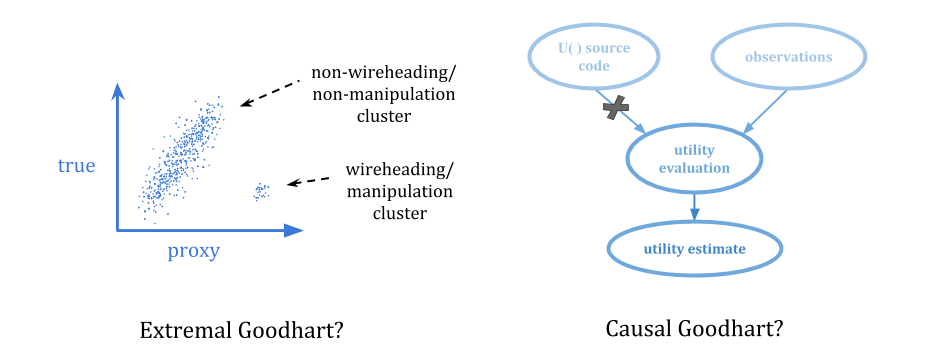
したがって課題は、私たちが価値を置くものへの安定したポインタを作ることである。つまり、直接には最適化できない価値を間接的に参照し、しかもそのために価値の保管場所のハッキングを促すことのないポインタだ。
トム・エヴェリットらは「Reinforcement Learning with a Corrupted Reward Channel」で一つの重要な点を指摘している。フィードバック・ループの設定方法によって、結果は大きく変わる。
彼らは次の図を示している。
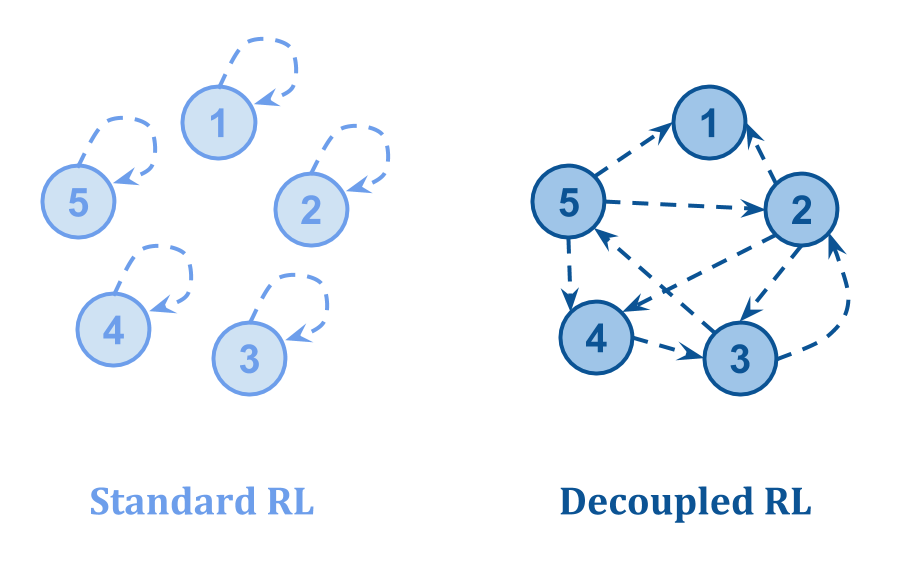
- 標準RLでは、ある状態の価値についてのフィードバックがその状態自体から来るため、破損した状態が「自己肥大化」し得る。
- 分離型RLでは、ある状態の質についてのフィードバックが別の状態から来るため、一部のフィードバックが破損していても正しい価値を学習できる。
ある意味で課題は、元の小さなエージェントを、正しい方法でフィードバック・ループへ組み込むことだ。しかし、先に述べた更新不要推論の問題があるため、これは難しい。元のエージェントは十分なことを知らない。
これへ対処する一つの方法は、知能増幅を用いることだ。後継エージェントをゼロから作って価値の読み込みを正しく行おうとする代わりに、元のエージェントを、同じ価値を持つより高能力なエージェントへ変えようとする。
たとえばポール・クリスティアーノ(Paul Christiano)は、小さなエージェントを大きな木の中で何度もシミュレートし、 【トピック:サブシステム・アライメント】 問題を部分に分割することで複雑な計算を行えるようにするアプローチを提案している。
しかし、これも小さなエージェントへかなり多くを要求する。問題をより取り組みやすい断片へ分ける方法を知るだけでなく、有害な下位計算を生じさせずに分ける方法も知らなければならない。
たとえば、小さなエージェントは自分自身の複製を使って大きな計算能力を得られるため、解の総当たり探索を容易に試みられるが、それがグッドハートの法則に抵触する結果になりかねない。
この問題が次節の主題、 【トピック:サブシステム・アライメント】 サブシステム・アライメントである。
これは、アブラム・デムスキ(Abram Demski)とスコット・ギャラブラント(Scott Garrabrant)によるEmbedded Agency(埋め込み型エージェンシー)連載の一部である。次の回へ進む。