
環境より大きなエージェントは、次のことができる。
これらはすべて、合理的エージェンシーの概念に典型的な特徴である。
埋め込まれたエージェントは、少なくとも単純な方法では、このどれも行えない。
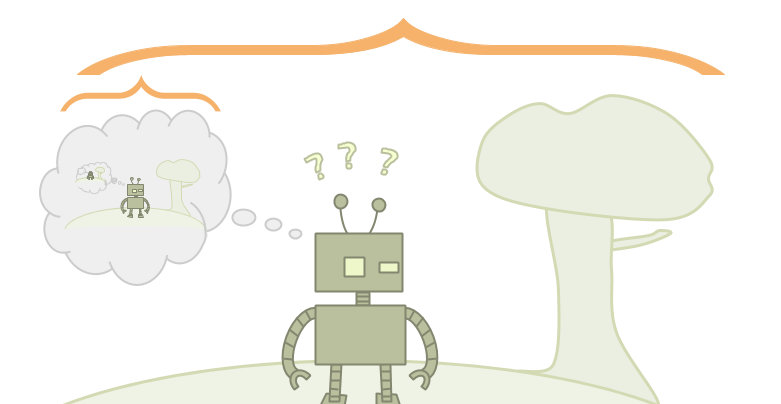
難点の一つは、エージェントが環境の一部なので、環境を細部までモデル化するには、エージェント自身も細部までモデル化する必要があることだ。そのためには、エージェントの自己モデルがエージェント全体と同じくらい「大きく」なければならない。エージェントは自分自身の頭の中に収まらない。
エージェントと環境の境界が明瞭でないため、自己言及のパラドックスへ取り組まざるをえない。世界の残りを表現するだけでも、すでに十分難しいというのに。
【トピック:埋め込み型世界モデル】 埋め込まれた世界モデルは、埋め込まれたエージェントにもっと適した形で世界を表さなければならない。この一群には次の問題が含まれる。
- 「実現可能性」/「真理の一粒」の問題:現実世界がエージェントの仮説空間に含まれない
- 論理的不確実性
- 高水準モデル
- 多水準モデル
- 存在論的危機
- 自然化された帰納:エージェントが自分自身のモデルを世界モデルへ組み込まなければならない問題
- 人間原理的推論:自分のコピーがいくつ存在するかを考慮して推論する問題
エージェントの不確実性を、ありうる世界上の確率分布で定量化するベイズ設定では、「実現可能性」がよく仮定される。観察を生成している真の基礎環境には、事前分布で少なくとも何らかの確率が割り当てられている、と仮定する。
ゲーム理論では、事前分布に「真理の一粒」があると言うことで、同じ性質を表す。ただし、ゲーム理論の設定でこの性質を得るには、さらに障壁があることに注意すべきだ。したがって、一般的な用法では、「真理の一粒」が技術的に難しい要求なのに対し、「実現可能性」は技術上の便宜である。
ベイズ推論を意味あるものにするうえで、実現可能性は絶対に必要というわけではない。一群の仮説を「専門家」、現在の事後確率を各専門家への「信頼」の度合いだと考えるなら、ベイズ則、\(P(h|e) = \frac{P(e|h) \cdot P(h)}{P(e)}\) に従って学習することで、相対的有界損失という性質が保証される。
具体的には事前分布 \(\pi\) を使う場合、各専門家 \(h\) と比べてどれほど劣るかは、最大でも \(\log \pi(h)\) となる。証拠列を見ることへ少なくとも確率 \(\pi(h) \cdot h(e)\) を割り当てるからであり、その証拠列を \(e\) とする。直感的には、\(\pi(h)\) は専門家 \(h\) への当初の信頼であり、その専門家が自分より少しでも正しい場合、そのつど信頼を相応に高める。この方法により、専門家と比べて \(\log \pi(h)\) を超える損失を被る前に、その専門家へ確率1を割り当て、正確に模倣することが保証される。
AIXIの基礎となる事前分布は、ソロモノフ事前分布である。入力がコイントスである万能チューリング機械(UTM)の出力として定義される。
言い換えれば、UTMへ無作為なプログラムを与える。通常、UTMは決定論的機械しかシミュレートできないと考えるだろう。しかしここでは、最初の入力がUTMへ、無限の入力テープの残りを乱数源として使い、確率的チューリング機械をシミュレートするよう指示できる。
これを、有界損失条件を満たしつつ「専門家」へ「信頼」を配分する方法としてベイズ学習を見る先の考えと組み合わせる。するとソロモノフ事前分布は、どれほど巧妙であれ、思いつきうるあらゆるアルゴリズムのように振る舞うことを学習できる、ある種の理想的な機械学習アルゴリズムとみなせる。
このため、計算上の事前分布を通じて推論するとはいえ、AIXIを「世界が計算可能だと仮定している」と必ずしも考えるべきではない。予測精度について、任意の計算可能な予測器と比べた有界損失を達成する。世界ではなく、ありうるアルゴリズムすべてが計算可能だとAIXIは仮定する、と言うべきである。
しかし、有界損失の予測精度を超える何かを求めるなら、実現可能性が欠けると問題が生じうる。
- 事後分布が永遠に振動しうる。
- 確率が較正されない可能性がある。
- 平均などの統計量の推定が、任意に悪くなりうる。
- 潜在変数の推定が悪くなる可能性がある。
- 因果構造の特定が機能しない可能性がある。
それならAIXIは、実現可能性の仮定なしでも良好に機能するのか。分かっていない。実現可能性なしでも予測について有界損失を達成するが、行動についての既存の最適性結果には、実現可能性の仮定を追加する必要がある。
第一に、環境が本当にソロモノフ分布から抽出されているなら、AIXIは 【トピック:意思決定理論】 最大の期待報酬を得る。しかしこれはかなり自明であり、本質的にはAIXIの定義そのものである。
第二に、AIXIがある程度無作為な行動を取るよう修正する――トンプソン・サンプリングを使う――と、任意の確率的チューリング機械のように振る舞う環境について、 【トピック:意思決定理論】 漸近的な最適性の結果が得られる。
したがって、どちらにしても何かを証明するため、実現可能性を仮定していた。(ヤン・ライケ(Jan Leike)の『Nonparametric General Reinforcement Learning』を参照。)
しかし、私が指摘する懸念は「世界が計算不能かもしれず、AIXIがうまく機能するか分からない」ということではない。これはどちらかといえば説明のための事例である。懸念は、AIXIが、学習し行動しなければならない環境より 【トピック:埋め込み型世界モデル】 はるかに、はるかに大きいエージェントを構築することでしか、知能または合理性を定義できないことだ。
ローラン・オルソー(Laurent Orseau)は「Space-Time Embedded Intelligence」で、これを考える方法を示している。しかし彼の方法では、現実を外部から考え、 【トピック:意思決定理論】 環境へ配置するエージェントを選ぶ、ある種の超知能的な設計者によって、エージェントの知能を定義する。
埋め込まれたエージェントには、宇宙の外へ出て、どう考えるべきかを考えるぜいたくはない。私たちが望むのは、状況の中にあるエージェントの合理的信念について、ベイズ主義が二元論的エージェントへ与える基礎と同じほど強い基礎を与える理論である。
コンピュータ科学の理論家が、プログラマーと意見を異にしている場面を想像しよう。理論家は抽象モデルを使っている。プログラマーは、計算上扱えないため、その抽象モデルは実際には決して実行できないと不満を述べる。理論家は、要点は実行することではない、と答える。むしろ、実行したい、もっと扱いやすいものにも関係する現象を理解することが要点だという。
これを持ち出したのは、私の観点が理論家のものにはるかに近いことを強調するためである。「AIXIは実行できない理想化だ」と言うために、AIXIについて話しているのではない。私が指摘する謎への答えは、実行できる必要がない。いくつかの現象を理解したいだけだ。
しかし、理論モデルを扱いにくくするものが、そのモデルを、関心を持つ現象とあまりにも異なるものにする場合がある。
AIXIがゲームへ勝つ方法は、仮説空間上で真のベイズ更新を行えること、世界が仮説空間に含まれることなどを仮定することである。したがってAIXIは、十分によい仮説空間上でおおよそベイズ更新を行っている、現実的エージェンシーの側面について何かを教えられる。しかし埋め込まれたエージェントは、その問題の近似解だけを必要とするのではない。その問題とは種類の異なる複数の問題を解かなければならない。
埋め込みエージェンシーの理論が対処すべき大きな障害の一つは、自己言及である。
嘘つきのパラドックスのような自己言及のパラドックスにより、エージェントの世界モデルが世界を正確に反映することは、単に途方もなく非実用的なのではなく、ある意味で不可能になる。
嘘つきのパラドックスは、「この文は真ではない」という文の状態に関する。真なら偽でなければならず、真でないなら真でなければならない。
難しさの一部は、地図自体を含む領域の地図を描こうとすることから生じる。
世界が私たちのために「静止」してくれるなら問題ない。しかし地図が世界の中にあるため、 【トピック:意思決定理論】 地図が異なれば世界も異なる。
現在建設中の道路が最終的に通る経路を、正確に地図へ描くことが目標だとしよう。さらに建設チームは地図を見ることになっており、どのような地図を作っても、それを誤りにするよう建設を進めることも知っているとする。すると、嘘つきのパラドックスに似た状況へ置かれる。
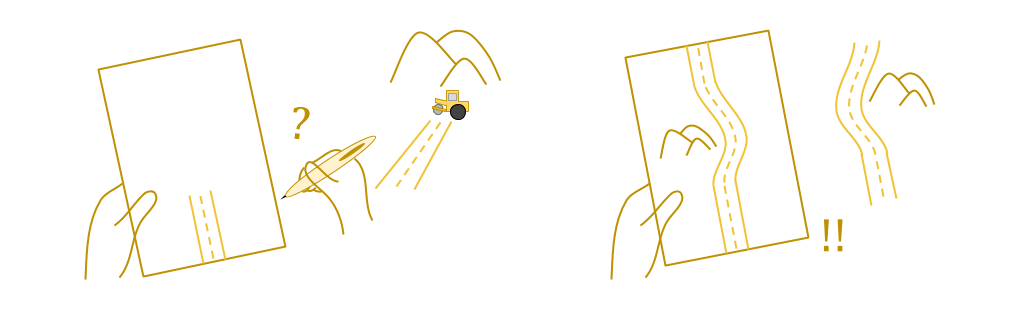
この種の問題は、 【トピック:意思決定理論】 ゲーム理論の意思決定に関係してくる。単純なじゃんけんのゲームでも、プレイヤーが勝とうとし、互いを偶然より正確に予測できるなら、嘘つきのパラドックスが生じうる。
ゲーム理論は、ゲーム理論的均衡によって、この種の問題を解決する。しかし問題は、別の形で戻ってくる。
実現可能性の問題は、ゲーム理論の文脈では異なる性質を持つと述べた。機械学習の設定では、実現可能性は非現実的な仮定かもしれないが、通常は矛盾なく仮定できる。
一方、ゲーム理論では、仮定自体が矛盾することがある。ゲームからは自己言及のパラドックスがよく生じるからだ。
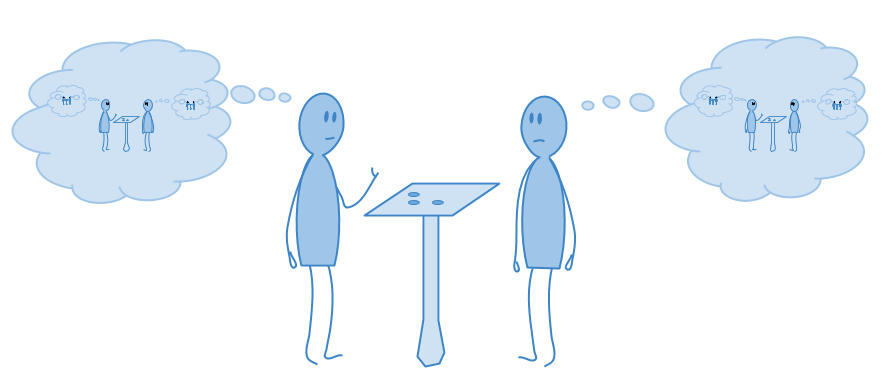
エージェントが多数いるため、ゲーム理論ではもはや「エージェント」を世界より大きなものにするという都合のよい方法を取れない。そのためゲーム理論家は、大きな世界を扱える合理的エージェンシーの概念を研究せざるをえない。
残念ながら、そのために世界を「エージェント」の部分と「エージェントでない」部分へ分割し、エージェントを特別に扱っている。これは二元論的なエージェンシーのモデルとほとんど同じくらい悪い。
じゃんけんでは、各プレイヤーが各手を確率 \(1/3\) で出すと定めることで、嘘つきのパラドックスを解決する。一人がこのように出すなら、もう一人も同じようにして不利益を被らない。ゲーム理論で生じかねないパラドックスを解決するため、確率的なプレイを導入するこの方法を、ナッシュ均衡と呼ぶ。
ナッシュ均衡を使えば、エージェントが自分のいる世界を正しく理解しているという仮定が、矛盾することを防げる。しかしこれは、世界がどのようなものかをエージェントへ伝えるだけで機能する。AIXIにもっと似た、世界について学習するエージェントをモデル化したい場合はどうだろうか。
「真理の一粒」問題とは、ゲームを行うエージェントが、相手の真の(確率的な)挙動を最初から正確に知らずとも、それぞれへ何らかの正の確率を置ける、適度に有界な事前確率分布を定式化する問題である。
最近まで、既知の解決策はかなり限られていた。ベンヤ・ファレンスタイン(Benja Fallenstein)、ジェシカ・テイラー(Jessica Taylor)、ポール・クリスティアーノ(Paul Christiano)の「Reflective Oracles: A Foundation for Classical Game Theory」は、非常に一般的な解決策を与える。詳しくは、ヤン・ライケ、ジェシカ・テイラー、ベンヤ・ファレンスタインによる「「真理の一粒」問題の形式的解決」を参照してほしい。
確率的チューリング機械は、ナッシュ均衡を問題なく表現できると思うかもしれない。
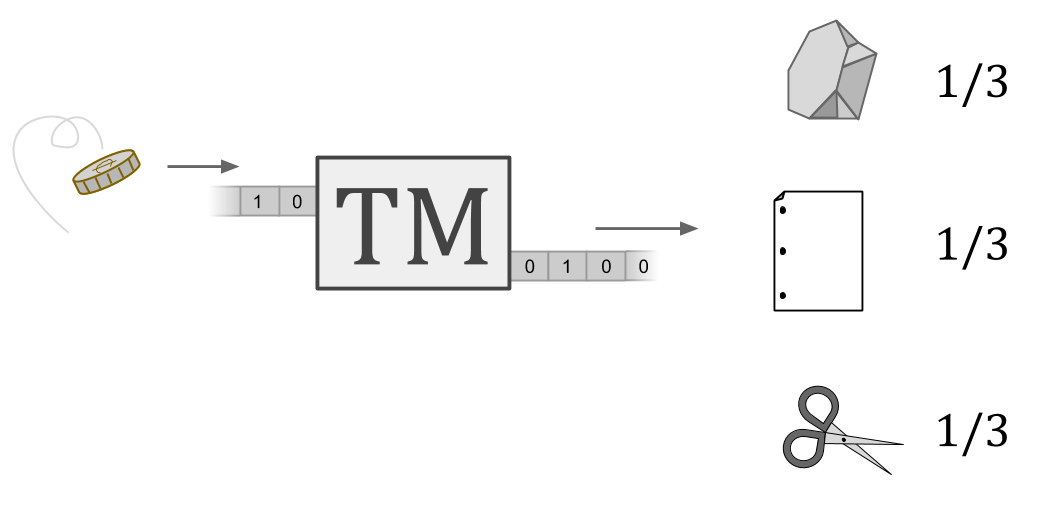
しかし、ほかのエージェントについて推論した結果としてナッシュ均衡を生み出そうとすると、問題が起きる。各エージェントが相手の計算をモデル化し、相手の行動を見るため実行しようとすれば、単に無限ループとなる。
チューリング機械には答えられない問いがある。特に、チューリング機械の挙動に関する問いだ。停止問題が典型例である。
チューリングは、そのような問いへ答えられる場合に何が起きるかを調べるため、「オラクル機械」を研究した。オラクルは、それまで答えられなかった問いへの答えをいくつか収めた本のようなものである。
しかし通常は、階層ができる。B型機械はA型機械が停止するかという問いへ答えられ、C型機械はA型とB型についての答えを持つ、と続く。しかし自分自身と同じ型についての答えを持つ機械は存在しない。
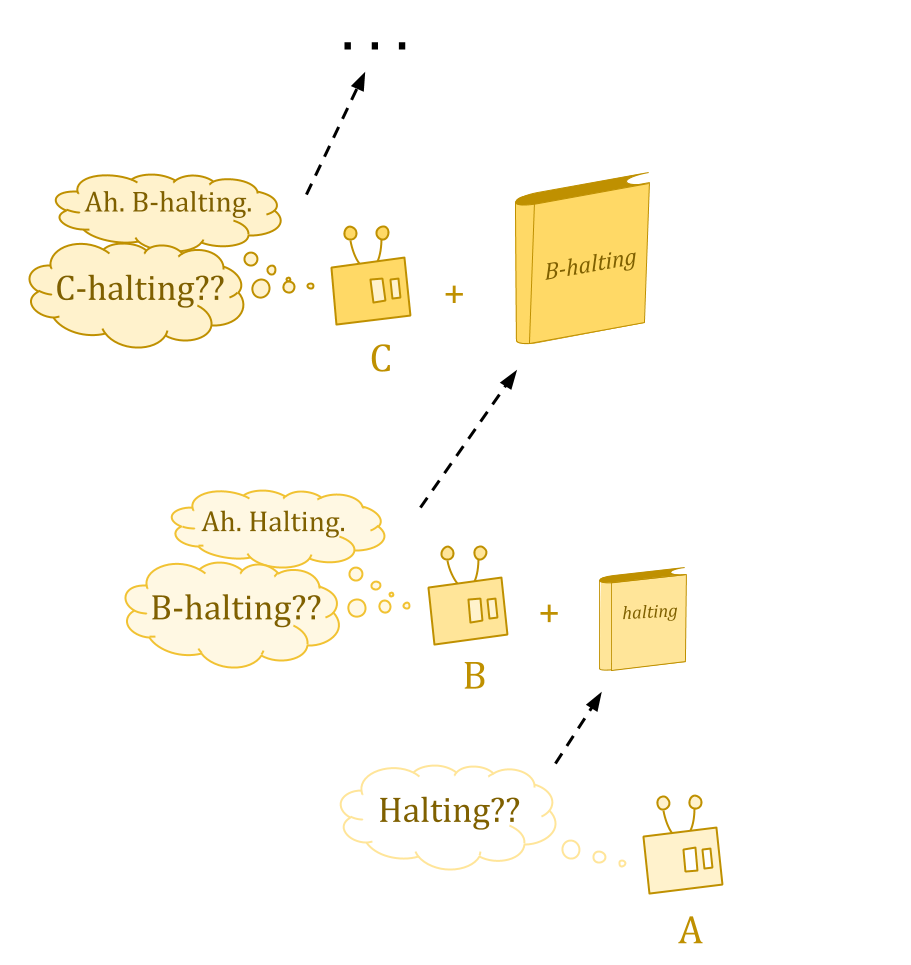
反射的オラクルは、通常のチューリング宇宙を自分自身へ折り返すことで機能する。ますます強力になるオラクルの無限階層ではなく、自分自身をオラクル機械として使うオラクルを定義する。
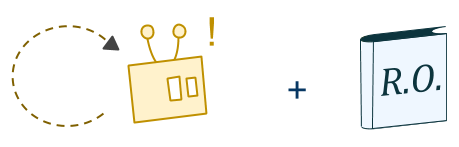
通常なら矛盾が生じるが、反射的オラクルは、パラドックスへぶつかる場合に出力を無作為化して避ける。したがって反射的オラクル機械は確かに確率的だが、通常の確率的チューリング機械より強力である。
反射的オラクルはこうして、先に述べた、地図自体が領域の一部となる問題へ対処する。無作為化するのである。
反射的オラクルは、先に述べた、ゲーム理論的な合理性概念の問題も解決する。エージェントを根本的に特別な事例として扱わず、環境のほかの部分と同じ方法で推論できるようにする。すべて、オラクルへアクセスできる計算にすぎない。
しかし反射的オラクルに基づく合理的エージェントのモデルにも、なお複数の大きな限界がある。その一つはAIXIと同じく、エージェントが無制限の処理能力を持つことを求め、そのため自分の信念がもたらす帰結すべてを知ると仮定することだ。
実のところ、信念の帰結すべてを知ること――論理的全知と呼ばれる性質――は、古典的なベイズ的合理性のかなり中核にあると分かる。
ここまでは、エージェントが仮説について信念を持ち、現実世界が仮説空間に含まれたり、含まれなかったりする、とかなり素朴に話してきた。
実際、そのどれが何を意味するのか、あまり明確ではない。
定義の仕方によっては、エージェントが世界より小さくても、正しい世界モデルを持つことは十分に可能かもしれない。真の物理法則と初期条件を知りながら、その帰結を極めて大まかにしか推論できない場合である。
人間は明らかに、省略表現と近似の中で暮らすことに慣れている。しかしこのシナリオがどれほど現実的でも、ベイズ主義者が何かを知るという通常の意味には合わない。ベイズ主義者は、自分の信念がもたらす帰結すべてを知る。
自分の信念がもたらす帰結についての不確実性が、論理的不確実性である。この場合、エージェントは自分がどの宇宙にいるかを特定する、一意の数学的記述へ経験的には確信していても、その記述がもたらす帰結の大半について、論理的には不確実かもしれない。
論理的不確実性をモデル化するには、論理(含意についての推論)と確率(信念の度合い)を組み合わせた理論が必要である。
論理と確率論は、合理的思考を体系化した二つの偉大な成果である。論理は 【トピック:頑健な委任】 自己言及を考える最良の道具を、確率は 【トピック:意思決定理論】 意思決定を考える最良の道具を与える。しかし両者は、想像するほど、うまく連携しない。
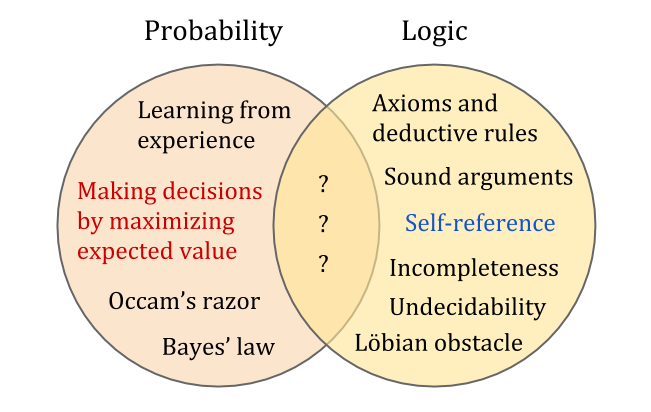
確率論はブール論理の拡張なので、表面的には両立するように見えるかもしれない。しかしゲーデルの第一不完全性定理が示すように、十分に豊かな論理体系はすべて不完全である。すべての文を真または偽と判定できないだけでなく、それを可能にする計算可能な拡張も存在しない。
(これが確率論をどのように混乱させるかについて、さらに図解した記事「An Untrollable Mathematician Illustrated」を参照。)
これは確率分布にも当てはまる。十分に豊かな理論と整合する形で確率を割り当てられる計算可能な分布は存在しない。そのため、計算不能な分布を使うか、矛盾する分布を使うか、選ばざるをえない。
簡単な選択に聞こえるだろう。矛盾する理論は少なくとも計算可能であり、何といっても私たちが開発しようとしているのは、論理的非全知の理論である。証明した事実について更新を続け、整合性へ少しずつ近づけばよい。
残念ながら、これは実現可能性へつながる理由のため、あまりうまくいかない。健全な理論が持つすべての帰結と整合する計算可能な確率分布は一つもないことを思い出してほしい。したがって、全知ではない事前分布には、正しい仮説が一つも含まれない。
真である数学的信念を次々に条件として加えると、このため病的な挙動が生じる。信念は妥当な推定へ近づかず、激しく振動する。
数学上のベイズ事前分布を取り、証明したものについて更新しても、領域を制限して妥当な事前分布を注意深く作らない限り、数学的直観と発見的な予想をうまく捉えられないように思える。
確率は、世界を重りとする天秤のようなものだ。観察により、ありうる世界の一部が除外され、重りが取り除かれて信念の釣り合いが変わる。
論理は、推論規則に従い、公理の種から育つ木のようなものだ。現実世界のエージェントにとって、成長過程は決して完了しない。それぞれの信念が持つ帰結すべてを知ることはない。
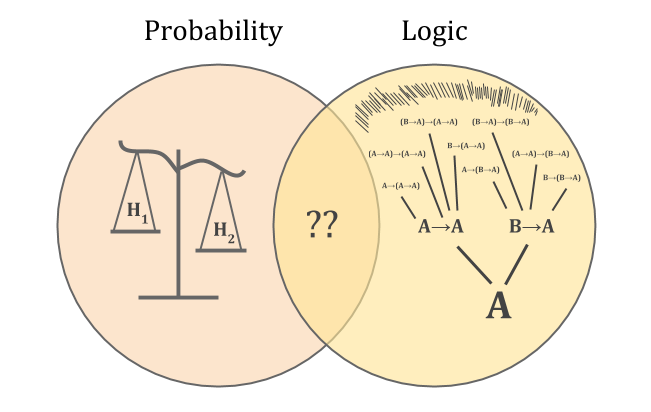
両者をどう組み合わせるか分からなければ、数学について確率的に推論することを特徴づけられない。しかし「天秤対木」の問題は、通常の経験的推論がどう機能するかも分からないことを意味する。
ベイズ仮説検定では、各仮説が、どの観察へどの確率を割り当てるか明確に宣言する必要がある。そうすれば観察したとき、オッズをどれほど調整すべきか分かる。信念の帰結を知らなければ、予測を行ったことについて、どれほど信頼を与えるべきか分からない。
これは確率の天秤のどこへ重りを置けばよいか分からないようなものだ。証明によって一方が除外されるまで、両側へ重りを置いてみることもできるが、その場合、信念は有用なことをせず、永遠に振動するだけである。
そのため、エージェントより大きな世界の問題へ直接取り組まざるをえない。不確実な帰結について、限定合理的な信念の何らかの概念がほしい。しかし論理についての計算可能な信念はどれも、必ず何かを取りこぼす。論理的含意の木は、あらゆる容器より大きく育つからだ。
ベイズ主義者にとって、確率の天秤は、ダッチブック――確実な損失となる一連の賭け――を仕掛けられないよう、厳密に釣り合っている。しかし、信念の帰結すべてを知る場合にしか、すべてのダッチブックを考慮できない。それがなければ、木のほかの部分を探索した者からダッチブックを仕掛けられる。
しかし人間の数学者は、数学的不確実性について推論する際、経験的不確実性の場合以上の特別な難しさへ直面していないように見える。それなら、悪い賭けを免れることではないとすれば、数学的不確実性の下でのよい推論を特徴づけるものは何か。
一つの答えは、木の中で素早く計算できる部分に基づく賭けだけを認めるよう、ダッチブックの概念を弱めることだ。これは、ギャラブラントほかによる「論理的帰納」の背景にある考えの一つである。これは「ソロモノフ帰納だが、数学的不確実性を組み込む推論のためのもの」のような何かを定義する初期の試みである。
世界が自分より大きいことから生じる、もう一つの帰結は、高水準世界モデル、つまりテーブルや椅子のようなものを含むモデルを使えなければならないことだ。
これは古典的な記号接地問題に関係する。しかし、あるシステムへの 【トピック:頑健な委任】 信頼を高める形式的分析を求めているため、関心を持つモデルの種類は多少異なる。これは 【トピック:サブシステム・アライメント】 透明性と 【トピック:頑健な委任】 十分な情報に基づく監督にも関係する。世界モデルは理解可能な部分から構成されるべきだ。
関係する問いは、高水準の推論と低水準の推論が、互いに、そして中間水準とどう関係するかである。すなわち多水準世界モデルの問題だ。
標準的な確率的推論は、この種のことをあまりうまく説明しない。世界を異なる精度水準で記述する複数のベイズ・ネットがあり、処理能力の制限から、主に精度の低いものを使わざるをえず、必要に応じて、より精度の高いものへどう移るか決めなければならないような状況である。
さらに、異なる水準のモデルは完全には対応しないので、その間を翻訳する問題があり、モデル間に重大な矛盾が存在する場合もある。高水準モデルはそもそも近似だと理解されているため、問題ないかもしれない。あるいは高水準または低水準のモデルに重大な問題があり、改訂が必要だという兆候かもしれない。
これは、私たちが価値を置く対象が、世界の「よりよい」モデルの一部ではないと判明する存在論的危機の場合、特に興味深い。
人間が価値を置くものは、すべて高水準モデルにしか存在せず、還元主義的な観点では、原子やクォークより「現実性が低い」と言って差し支えないように思える。しかし価値は低水準で定義されていないため、低水準についての知識が根本的に変化しても、価値を維持できる。(高水準が根本的に変化した場合、価値へ何が起きるかについても、何か言えるようになりたい。)
埋め込まれた世界モデルのもう一つの重要な側面は、エージェント自身がモデルに含まれなければならないことだ。エージェントは世界を理解しようとし、世界を自分自身から完全には切り離せないからである。これにより、 【トピック:頑健な委任】 自己言及と 【トピック:意思決定理論】 人間原理的意思決定理論の難題への扉が開く。
自然化された帰納。これは、環境内に自分自身を含む世界モデルを学習する問題である。難しさは、カスパー・オースターヘルド(Caspar Oesterheld)が表現したように、「心的なもの」と「物理的なもの」の間に型の不一致があることだ。
AIXIは、 【トピック:意思決定理論】 エージェントが収まる差し込み口を設けて作られたかのように、環境を捉える。直感的にはこのように推論するかもしれないが、これが悪いモデルに見える物理的な観点も理解できる。代わりにエージェントが、内省で利用できる 【トピック:頑健な委任】 自己知識、宇宙がどのようなものかについての仮説、そして両者をつなぐ「橋渡し仮説」を別々に表現すると想像できる。
これがどう機能しうるかについて、興味深い問いがある。そもそもこれが正しい構造なのかという問いもある。少なくとも、赤ん坊が学習する方法として私が想像するものではない。
トマス・ネーゲル(Thomas Nagel)なら、この問題への方法は「どこでもないところからの眺め」を含むと言うだろう。各仮説は、外部から見たかのような世界を仮定する。これはおそらく奇妙なことだ。
エージェントが自分自身について推論する必要がある特殊な場合として、 【トピック:頑健な委任】 将来の自分について推論する必要がある。
長期計画を立てるには、将来どう行動するかをモデル化し、将来の目標と推論能力へ、ある種の 【トピック:頑健な委任】 信頼を持てなければならない。これには、多くを学び成長した将来の自分を信頼することも含まれる。
伝統的なベイズの枠組みでは、「学習」はベイズ更新を意味する。しかし先に述べたように、ベイズ更新を行うには、エージェントが世界のさまざまなあり方を考えられるほど十分に大きな状態から始め、その一部を除外することで学習する必要がある。
埋め込まれたエージェントには、このようには機能しない、資源制約のある、論理的に不確実な更新が必要である。
残念ながら、時間を通じて一つに統合されたエージェントとして進むエージェントを考えるうえで、主に知られている方法はベイズ更新である。ベイズ推論をダッチブックから正当化する議論は、基本的に、この種の更新が、月曜日のエージェントの行動と火曜日のエージェントの行動が少しでも互いの目的を損なわない、唯一の方法だと述べている。
埋め込まれたエージェントは非ベイズ的である。そして非ベイズ的なエージェントは、将来の自分と戦争を始めがちだ。
そこで次の一群の問題、 【トピック:頑健な委任】 堅牢な委任へ進む。
本稿は、エイブラム・デムスキー(Abram Demski)とスコット・ギャラブラント(Scott Garrabrant)による埋め込みエージェンシー連載の一部である。次の記事:堅牢な委任。