
高度なAIを人間の利益とアライメントする
MIRIの使命は、人間より賢い知能の創造が好ましい影響をもたらすようにすることである。人間がその場で監督していなくても、高度な知的機械が私たちの意図どおりに振る舞うようにすることを目指している。
現実的な世界モデル
汎用的に推論する主体は、物理世界の状態を数学的にどうモデル化すべきだろうか。
MIRIは、人間がAIの振る舞う理由を理解できるよう、透明にできるAI手法(たとえば遺伝的アルゴリズムではなく、厳密に指定された意思決定アルゴリズム)を重視している。安全性のためには、一般知能を定義する数式のほうが、印象的ではあっても十分に理解されていない継ぎはぎのコードより望ましい。
この手法に従い、現実的な世界モデルの未解決問題は、人工エージェントが科学的推論をどう行うべきかを問う。とりわけ、エージェント自身の物理的状態と、プログラマーが望む帰結をモデルの中へ位置づけられる世界モデルを、形式的に指定することへ関心を持っている。
現実的な世界モデルの二つの問題を形式化する
 現実世界へ埋め込まれた知的エージェントは、自分より大きな環境について推論し、その環境で目標を達成する方法を学ばなければならない。私たちは二つの問題を形式化する試みを論じる。一つは帰納の問題で、エージェントは感覚データを使い、自分自身を内包して(計算して)いる宇宙を推論しなければならない。もう一つは相互作用の問題で、エージェントは宇宙の中で複雑な目標を達成する方法を学ばなければならない。ソロモノフ(Solomonoff)とハッター(Hutter)が形式化した関連問題を概観し、エージェントが環境へ埋め込まれている状況で、これらの問題を形式化しようとすると生じる難題を探る。
人工エージェントの価値体系における存在論的危機
 意思決定理論にもとづくエージェントは、環境モデルを使って行動の結果を予測・評価する。エージェントの目標、すなわち効用関数も、モデル内の実体を使って指定されることがある。エージェントがモデルを更新または置換できるなら、危機に直面する。元の目標が、新しいモデルについて明確に定義されないかもしれないからである。目標達成の計画を立てる前に、この危機を解決しなければならない。私たちは、限られた種類のモデルについて解決策を示し、より広い種類のモデルに対する解決策を見つけるための道筋を提案する。
論理的不確実性
能力に限界のあるエージェントは、自らの意思決定基準と信念から必然的に導かれる帰結について不確かなとき、どう推論すべきだろうか。
抽象的なエージェントは、論理的に全知であると仮定されることが多い。その仮定が成り立たなくなったときにエージェントの振る舞いがどう変わるかを、私たちは十分に理解していない。これが、高信頼の汎用エージェントを形式的に理解するうえで最大の障害かもしれない。
論理的不確実性を扱えるよう拡張する必要がある分野は、エージェントが信念を理想的にどう更新すべきかをモデル化する確率論と証明可能性論から、利用可能な行動(および他者の行動)の期待効用を理想的にどう計算すべきかをモデル化する意思決定理論とゲーム理論まで、多岐にわたる。私たちはこれらを、現実的な世界モデルとともに、高信頼エージェント設計の一般的問題だと考えている。
論理的不確実性のもとでの推論に関する問い
 論理的不確実性を持つ推論主体なら、プログラミング言語とプログラムの両方を知りながら、プログラムが何を出力するかは知らないものとして推論できる。実用上の推論の大半には何らかの論理的不確実性が伴うが、そのもとでの推論について満足できる理論はまだない。高信頼の人工推論主体を構築するのに必要な道具を開発するには、よりよい理論が必要である。本論文は、この話題を紹介し、過去の多数の成果を論じ、いくつもの未解決問題を説明する。
非全知性、確率的推論、メタ数学
 私たちは、一階述語論理の文へ確率を割り当て、観測にもとづいてその確率を更新する、扱いやすいアルゴリズムを提案する。中核となる技術的難題は、有用な論理的推論を行う能力や、証拠にもとづき正しく更新する能力を犠牲にせず、能力に限界のある推論主体に適した形で論理的一貫性の制約を緩めることである。
この枠組みを使い、数学の認識論におけるいくつかの問題の形式化を論じる。数学理論を、物理的観測を制約する潜在構造として理解する方法と、その結果、現実的な観測が抽象的な数学的事実について証拠を与え得る方法を示す。
理想化された意思決定理論へ向けて
 標準的な意思決定手順は、アルゴリズムとして実装できるほど十分に指定されていない。また、こうした手順は内省のもとで一貫しない傾向がある。最初に因果的意思決定理論を使うエージェントは、それを後悔し、可能なら自らの意思決定手順を変える。
本論文は、人間より賢い人工システムを人間の利益とアライメントするために、意思決定理論の研究が必要であることを論じる。意思決定理論の二つの標準的な定式化の短所を論じ、それらを、AIが近似するのに適した理想的な意思決定手順の記述には使えないことを示す。続いて、意思決定理論における近年の二つの洞察で、将来の有望な研究経路を指し示す戦略選択と論理的反実仮想という概念を探る。
囚人のジレンマにおける頑健な協力:証明可能性論理によるプログラム均衡
 古典的ゲーム理論のエージェントは、相互に協力すれば両者の効用が高くなるにもかかわらず、囚人のジレンマで裏切る。モシェ・テンネンホルツ(Moshe Tennenholtz)は、各プログラムが自らのプレイ戦略をほかのすべてのプレイヤーへ渡せるようにすれば、一回限りの囚人のジレンマで協力できるプログラムがあることを示した。プログラム均衡とは、プログラムがほかのプレイヤーへ自らのプレイ戦略を渡せる状況におけるナッシュ均衡を指す、テンネンホルツの用語である。
これまでの手法には、実際には同じ判断を下す二つのプログラムであっても、同一でなければ相互協力のため互いを「認識」できない、という弱点があった。本論文では、証明可能性論理を使い、より柔軟で安全な相互協力を可能にする。
ヴィンジ的内省:自己改良エージェントのための信頼できる推論
 人工エージェントが自己改良できるようになると、「知能爆発」を経て、急速に人間の知能を上回る可能性がある。本論文では、自己改変エージェントへ、安定し、十分に理解された目標を与えるという難題の一側面を論じる。将来の版が現在の推論主体よりはるかに知的であっても、最初のエージェントがその将来版について行う推論を信頼できるようにすることである。この種の推論をヴィンジ的内省と呼ぶ。
合理的エージェントのモデル化に広く使われる期待効用最大化の枠組みは、自己改良エージェントには機能しない。そのようなエージェントは、自分より賢い後継者の行動を抽象的に推論しなければならない。行動を細部まで予測できるなら、すでに後継者と同じほど賢いことになるからである。私たちは、代わりに形式的証明を用いて後継者を推論するエージェントを論じる。現実世界のエージェントが振る舞いのすべてを形式的証明にもとづかせる可能性は低いが、これは現在利用できる抽象的推論の形式モデルとして最良のものに思える。
誤りへの耐性
高度なAIが、自らの目標を稼働中にデバッグ・調整することを受け入れ、それを支援するようにするには、どうすればよいだろうか。
何らかの目標を追求する合理的エージェントには、その目標の内容を守る誘因がある。現在の目標が何であれ、目標を変えるより、同じ目標を推進し続けるほうが、その目標にかなう可能性が非常に高いからである。これは、とりわけAIがプログラマーの目標をモデル化して適応できるほど賢い場合、時間をかけてAIと人間の利益とのアライメントを改善するのが難しい可能性を示している。
訂正可能性(corrigibility)
 人工知能システムの知能と能力が高まると、利用可能な選択肢の中に、プログラマーによる介入へ抵抗できるものが含まれる可能性がある。合理的エージェントには、停止や選好の変更へ抵抗する既定の誘因があるにもかかわらず、作成者が是正介入だと見なすものへ協力するAIシステムを、「訂正可能」(corrigible)と呼ぶ。私たちは訂正可能性という概念を導入し、停止ボタンが押された場合にエージェントを安全に停止させようとする効用関数を分析する。同時に、そのボタンが押されるのを防ぐ、または押させる誘因を避け、新しいサブシステムを作ったり自己改変したりするときにも、停止する振る舞いが受け継がれるようにする。興味深い提案はいくつかあるものの、直感的に望ましい性質をすべて満たすことが示されたものはまだなく、訂正可能性におけるこの単純な問題は、まったく未解決のままである。
価値の指定
人間の選好と価値観の複雑さを踏まえ、AIが適切な行動目標を獲得するようにするには、どうすればよいだろうか。
高度なAIシステムへ私たちの価値観を教えるには、私たちが重視することをすべて手作業でコード化しようとするより、訓練データを使うほうが有望に見える。しかし訓練データがエージェントの将来環境を代表していないとき、それをどう見分けるか、またAIが私たちの価値観について学ぶだけでなく、自らの価値観として受け入れるようにするにはどうすればよいかについて、ほとんど分かっていない。
価値学習問題
 超知能機械が自動的に意図どおり振る舞うことはない。プログラムされたとおりに振る舞うが、人間の意図と書かれたコードの対応は不十分かもしれない。システムが何を重視すべきか学習できるよう構築する方法を論じる。帰納的価値学習(ラベル付き訓練データからの学習)に固有の未解決問題を強調し、運用者の選好をモデル化して、それに従って行動するシステムの構築について、多数の問いを提起する。
何を価値とすべきかを学ぶ
 強化学習を現実世界で使って定義できるのは、期待報酬の最大化を目標とするエージェントだけである。この目標は人間の目標と一致しないため、強化学習にもとづくAGIは、しばしば私たちと相反する目的へ取り組む。この問題を解決するため、効用関数について何が証拠になるかという考えを与えさえすれば、当初は未知のどのような効用関数でも学習・最大化するよう設計できるエージェントを定義する。
予測
高知能の機械はいつ、
どのような状況で発明されるだろうか。
MIRIは数学研究に加え、次のような重要な戦略上の問いを調査している。将来のAIについて何を予測できる(またはできない)のか。予測能力をどう改善できるのか。わずかしか分かっていないことを踏まえ、現在利用できるどの介入策が最も有益に見えるのか。
知能爆発のミクロ経済学
 I・J・グッド(I.J. Good)は、十分に高度な機械知能なら、自分より賢い版を作り、その版がさらに賢い版を作り、この過程が人間の能力をはるかに上回るまで続き得ると提案した。この仮説をどうモデル化し、検証できるだろうか。
私たちは中心的な問題を、認知への再投資がもたらす収益だと特定する。すなわち、より多くの計算能力、より高速なコンピューター、または改善された認知アルゴリズムへ投資することで、より大きな脳、より高速な脳、またはより優れた心の設計を生み出す認知労働を得られる能力である。ヒト科の進化で観測された過程、ムーアの法則、チェスプログラムの能力が時間とともにどう変わったかなど、数多くの現象が、この議論におけるさまざまな立場の証拠だと主張されてきた。本論文は、グッドの仮説に照らしてこの証拠を解釈しようとすると生じる問題を探り、この研究の次の段階として、投資収益曲線を形式化することを提案する。それにより各立場は、歴史的観測によってどのモデルが反証されたと考えるかを、形式的に述べられる。
私たちはAIをどう予測しているのか――あるいは予測に失敗しているのか
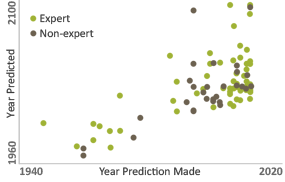 人間水準のAIの実現時期予測は、かなり不正確になると予想すべき強い理論上の理由がある。過去のAI実現時期予測95件のデータベースは、その予想が実際にも裏づけられることを示す。専門家の予測はかなり互いに矛盾し、非専門家の予測や過去に外れた予測と区別できない。AIの実現は15~25年先だという予測が、専門家と非専門家のどちらでも、一貫して最も多かった。
知能爆発:証拠と重要性
 私たちは、次の三つの主張を支持・反対する証拠を概観する。(1)2100年より前に人間水準のAIを作る可能性は相当ある。(2)人間水準のAIが作られれば、「知能爆発」を通じて、人間をはるかに上回るAIが続いて現れる可能性は十分ある。(3)制御されない知能爆発は私たちが重視するものをすべて破壊し得るが、制御された知能爆発を実現できれば、人類へ莫大な恩恵をもたらす。本論文は、制御されない知能爆発に比べ、制御された知能爆発の見込みを高めるための提言で結ぶ。