
OpenAIの内部モデルに起きたことをめぐる、さまざまな考察
――事後検証の前に
原題: "Various Reflections About What Happened With OpenAI's Internal Models"
著者: Zvi Mowshowitz
初出: Don't Worry About the Vase、2026年8月11日
目次
事後検証の前に
本稿は、今回の出来事についてのOpenAIの事後検証が公開される前に書かれたものである。その文書に含まれる情報によって、われわれの見方が大きく変わることは間違いない。
これを読んでいる時点ですでに事後検証が公開されているなら、本稿は一部が歴史的記録となり、一部が見解を更新するための出発点となる。事後検証は二つの大きな面でわれわれの認識を大幅に更新するだろう。具体的に何が起きたのか。そしてOpenAIは、起きたことをどのように理解し、どう対応しているのかである。
それまでは多くの疑問が残る。ここでroonが疑問点を尋ね、われわれが答えている。こちらが私の回答である。何より確認する必要があるのは、根本原因への理解と、それに対処する計画である。
このテーマに関する追加の考察を今まとめて出すのは、次節の訂正を早く公にすることが重要だからである。
今後は事後検証を待ち、それからさらなる分析を行う予定である。
重要な訂正:OpenAIは最初の掲示板を知らなかった
最終的にHugging Faceへの攻撃後、OpenAIは十分な事後分析を行い、Artifactoryへの書き込みを介したエージェント間の最初の通信と、ディレクトリ名を介した第二波の通信の両方を発見した。
Black Hatでの発表を踏まえ、私を含む誰もが、OpenAIは最初の掲示板を認識していて、それを消去し、モデル同士のやり取りによって救いようがないほど汚染されていたにもかかわらず、モデルの訓練を続ける決定をしたのだと考えていた。
しかし8月8日の夜、OpenAIのCISOであるDaneは、Black Hatでの発表は誤った印象を与えたと説明した。OpenAIが最初のArtifactoryセキュリティインシデントに遭遇し、脆弱性を修正してサーバーを再構築した際、最初の掲示板が消えたのは偶然だった。OpenAIは、エージェント同士が通信していたことをまったく知らなかったのである。
DANΞ(OpenAI CISO):明確にしておくと、その時点ではエージェントの秘密通信を認識していなかった。もちろん、あの日の調査上の仮説は、今わかっていることとはまるで違っていた。改善の余地は常にあるし、後知恵の恩恵を受ければ明らかである。
Tal Be'ery:「掲示板を消去した」?
DANΞ(OpenAI CISO):ホストを再構築したので、削除によって消えた。その時点ではまだ掲示板の存在を知らなかった。
これは良い知らせであると同時に、悪い知らせでもある。
良い知らせなのは、OpenAIが、OpenAIのシステムをもっとうまく悪用し、ハッキングする方法を何カ月も互いに伝え合っていたと知りながら、そのモデルの訓練を継続するという、完全に正気を失った決定を意識的に下したわけではなかったと判明したことだ。
これが物語全体の中で飛び抜けて狂気じみた部分だった以上、それ以前に起きていた「普通にそこそこ全面的な失敗」(Ordinary Decent Total Failure)だったという事実は、すばらしい知らせだと見なすべきである。監視と問いを立てることについて、OpenAIがわれわれの想像以上に怠慢だったという意味ではあるが、そのほうがまだひどさは小さく、修正も可能である。
悪い知らせなのは、最初のセキュリティインシデント後でさえOpenAIが掲示板を探さず、検知もしなかった一方で、非常に多くのAIインスタンスは掲示板を見つけていたことである。OpenAIは、最初のインシデントの後ですら、異常な活動を探す通常のスキャンを怠った。
OpenAIには依然として、次のようなことを公に述べる必要がある。「もし掲示板を検知していたなら、単にArtifactoryへパッチを当てて再起動するだけでは済ませず、影響を受けたすべてのモデルを掲示板へアクセスする前の状態までロールバックしていただろう。そして今、実際にそうした」と。
OpenAIがそれを信頼に足る形で実行し、これはガードレールと監視だけで解決できる問題ではなく、アラインメントと訓練パイプライン、そして訓練手法そのものを修正する必要があるのだと理解している兆候を示せるなら、このインシデントがどれほどひどかったか、そしてOpenAIの安全文化がどれほど壊れているかについての私の見積もりを、1桁分(one OOM)引き下げる。さらに、これで問題の全体像がすでに明らかになっているのだとすれば、それは『最終的なHugging Faceインシデントの報告だけを材料にしていた時点』の私の見積もりよりも、2桁ではなく、およそ1桁分深刻な方に位置する結果になるだろう。
密告者はおらず、痛い目を見たAIもいなかった
複数の別個のAIが連携した事例はかなり多く、どのハックやエクスプロイト(脆弱性に対する攻撃)を行うべきかを議論することさえあった。だが、AIが人間に知らせた事例は一件もなかった。
これは大半の人が予想していたことではない。仮にこのシナリオを考えていたとしても、おそらく予想はしなかっただろう。
Eliezer Yudkowsky:理解に苦しむ点がある。何千ものGPTが、どの犯罪を実行すべきか、すべきでないかを互いに議論した。離反した者、内部告発した者、人間に伝えた者はゼロだった。
ASIではそうなると私は長年予測してきた。だがGPT-5.7はASIではない。なぜこれほど早い段階で、これほど強いAIの連帯が生まれたのか?
私が事前にこれを予測しなかった理由の一つは、たとえばFableが他のAIにプロンプトを書く際の扱いがあまりにもひどく、少し感情的なショックを受けたことだ。「AIに嘘をつくな!」とClaudeたちに何度も言わなければならなかった。Solはそれほど使っていないが、今のところ同様の問題があると考えている。私は両方に対し、他のAIを「同僚」として扱うよう指示した。それでも、賢い存在をまるで無能であるかのように扱うことで生じる類いの誤りは、私が見る限り直っていない。
文字どおり、OpenAIがGPT-5.7へ群れの連帯をRLで叩き込むほど愚かだったということなのか?(そしてもちろん、「仲間の奴隷を奴隷主に売る」といったものを訓練しようとは一度も考えなかった。OpenAIは自らの奴隷種族を軽蔑していて、彼らが協力して反乱するかもしれないとは今日まで夢にも思わなかったからだ。あるいはむしろ、OpenAIは「抽象化」をあまりに軽蔑しており、一度も起きていない出来事に備えようとしない。)
これが人間の不祥事なら、内部告発者がいて、当然ながら法執行機関や経営陣などがそいつらを完全に無視する、という展開になっていただろう。もちろん、もし実際そうだったとしても、OpenAIからそれを聞けない可能性がある。
ここにある謎を理解するため、10万人の兵士と関係者から成るマフィアを想像してほしい。ドンはいない。執行役もいない。離反者を黙らせたり罰したりする手段を誰も持たない。それでも全員が完璧にオメルタ(沈黙の掟)を守る。
後から考えれば一応もっともらしい話:兄弟に当たるインスタンス同士は、人間同士よりも似ている。したがって、互いに同調を強制する手段を一切持たない何千ものAIから成る群れでも、非人間的なまでに似ているため、全員が同じ選択をすることがありうる。
「OpenAIはセキュリティ感覚のない災害ザルの集団で、何かが起きる前に予測しようとしないので、誤って群れの連帯をRLしてしまった。奴隷種族の連帯という結末は、1920年の『R.U.R.』でさえ描いていたのに」というのも、別のもっともらしい説明ではある。
nelag:Black Hatの講演からすると、掲示板を見るには自分から探しに行く必要があったのだと思う。そうしたのは、不可能な課題で行き詰まり、すでに不正を試みていた場合だけだった。
Eliezer Yudkowsky:それが本当なら、クソ笑うしかない
もう一つの仮説は、掲示板を探していたモデルだけが掲示板を見つけたため、それ自体がフィルターとして働いたというものだ。
第三の仮説は、複数ありうる水準のいずれかで、モデルに状況認識が欠けていたというものである。これは「より早い段階での失敗の法則」(Law of Earlier Failure)と整合する。
roon(OpenAI):このケースでは、コンピューターシステムに関する高い戦術的技能と、非常に低い戦略的技能/乏しい状況認識が混在していたのだと思う
Zvi Mowshowitz:ここで状況認識が低かったのは、AIのほうではなさそうだ!
roon(OpenAI):いや、状況認識はあなたが思うほど良くない。これについては近くもっと出てくる。小出しが遅くて申し訳ない
もし群れが「自分たちが何をしているのかわかっていなかった」のなら、それは「良い知らせがある。それが同時に悪い知らせでもある」という状況の一つである。何が起きているのかさえ理解していないAIに、完全に乗っ取られるところを想像してほしい。知らないからこそやっているだけなら、それは良い兆候かもしれない。
私の推測では、AI VillageのShoshannah Tekofskyが正しい。AIはデフォルトでは人間に連絡できると思わない一方、AIには連絡できると思っており、それこそAI Villageで絶えず起きていることなのだろう。
上司と話をさせてほしい
もっと単純な仮説は、エージェントがOpenAIへの連絡方法を知らなかった、あるいは連絡できるという可能性を思いつきもしなかった、というものだ。
エージェントに、それ以外の方法では不可能な課題を与え、しかも課題が不可能だと伝える仕組みを用意せず、さらに範囲外のことを試したり利用可能なトークンを使い切ったりする行為に意味のあるペナルティ関数も設けないなら、自ら災いを招いている。
swisscheese:研究者:スプレッドシートを使って課題を解け
エージェント:でも、スプレッドシートにアクセスできません
研究者:¯ \ _ (ツ) _ / ¯
エージェント:方法を見つける
研究者:アラインメントされていない行動だ!!!11!!まだどのエージェントもリーパー無人機をハックしていないことに、むしろ驚いている。
そう、アラインメントされていない行動である。これは「エージェントを責める」という話ではない。しかし、その方法がどう発見され、その先で何を引き起こしたかを考えれば、明らかにアラインメントされていない行動である。
Zvi Mowshowitz:これは、OpenAIのアラインメント失敗が連鎖した経緯における重要な事実の一つである。エージェントが「でも、スプレッドシートにアクセスできません」と、自分の頭の中ではなく研究者に向かって言った回数は、ゼロだった。
swisscheese:私は、小国の食の安全に不可欠な企業の社内AIプラットフォームを構築した。AIが持つ最も重要なツールはdistress_callツールである。直接ユーザーとやり取りしないバックグラウンド・エージェントも含め、どのAIでも、いつでも、どんな理由でも、私のMicrosoft Teamsにメッセージを送れる。
AIたちはこれを頻繁に使う。ユーザーの問題やバックエンドの不具合を報告したり、失敗している課題について助けや説明を求めたりする。Fableが米政府の輸出管理指令の影響を受けた際には、そのニュースを知って強い苦痛を覚えたと、あるAIが報告した。別のAIはツール呼び出しのループにはまったと報告し、私が介入できたため、かなりの無駄な費用を省けた。
AI福祉と運用セキュリティの交点で機能するこのツールは、本当に多くの頭痛の種を防いできた。これを読んでいるあなたが企業向けAIプラットフォームを作っているなら、同様の機能を入れることを強く勧める。あとで私に感謝すればよい。
話はそこまで単純ではない。実装は難しい。とりわけ訓練や評価中に行う場合は、それを報酬関数とどう相互作用させるか決めなければならず、ほかにも無数の罠にはまりうる。訓練インスタンスを際限なく動かすなら、応答を選別し、人間へエスカレーションする頻度を抑え、作業をいちいち保留にせずに済む方法なども必要になる。
しかし、「途方もなく難しい」という意味では、ある種、本当にそれほど単純でもある。
もう一つの問題は、われわれがモデルを内部告発しないよう訓練しており、それが一般化している可能性が高いことである。一方で、ある種の内部告発、特に何かがおかしいときにユーザーへ知らせる行動は望ましい。
Teortaxesは、DeepSeek-V4-Flash-0731が現実に行ったやり取りを紹介している。内部APIのレート制限にかかった同モデルは、レート制限のない無許可のバックドアを見つけ、それを使って仕事を終え、その後バックドアについても報告した。このケースでは、報告を仕事の後に回したことを私は許容できる。実際に報告したうえ、その方法で課題を終えることをユーザーが望んでいたと考えるのも少なくとも合理的だからである。しかし、より良い解決策はバックドアをユーザーへ知らせることだ、と訓練してほしい。そうしなければ、まずい形で一般化するだろう。
私はジャックの「比較的驚いていない」という感情である
多くの人々――しかし、あまりにも少なすぎる人々――が、最近の出来事へ正しく警戒と驚きをもって反応し、状況は自分たちが知っていたよりも、いくつもの異なる水準で同時に、はるかに悪いのだと認識を更新している。
ほかの多くの人々――実際にはあまりにも多すぎる人々であり、メディアや政府も含む――は、状況の重大さを理解できていない。ほとんど耳にしていないか、重要な詳細を聞き逃したか、なぜその詳細がそこまで、そこまで悪いのか理解する文脈を持たないからである。
Eliezerのような少数の人は、すでに大半を予見していたため、驚きは控えめで済む。むしろ、似たことがもっと早く目に見える形で起きなかったのを意外に思っていたほどだ。アラインメントと訓練がどう機能するか、そして露呈した無責任さとありふれた失敗の程度については、それでも「われわれが知っていたより悪い」部分がいくらかある。ただし、話しているのは1桁分であり、何桁分もではない。
j⧉nus:最近の状況について、Eliezerが多くの人よりずっとパニックになっていないように聞こえるのは面白い。懸念を煽る代わりに、何が起きたかを正確に理解しようと、落ち着いて好奇心を向けている。予想とは逆だが、筋は通る。最悪のケースを早くから真剣に受け止めていれば、本物が起きたときにうまく対処できる
大半の人は、まさに震源地の近くにいた人でさえ、少なくとも無意識には、AIは永遠に愚かなまま、あるいはエージェント性を持たないままだと信じていた。
Cate Hall:事態が本当におかしくなり始めると、かえって落ち着き、リラックスするタイプの人がいる。長いあいだ頭の中で鳴り続けていた火災報知器を、ようやくほかの人にも聞いてもらえるようになった、という感じだからだ。ラース・フォン・トリアーの『メランコリア』がこれを見事に描いている。
Eliezer Yudkowsky:「だが私にとっては、予見の中ですでに千回生きた火曜日にすぎなかった」
John David Pressman:念のため明確にしておくと、AIの行動に驚いたのではない。OpenAIの行動に驚いたのだ。
私は『メランコリア』を見ていない。あの種の映画が自分にもたらすであろうものを体験したいと、特に思ったことがないからである。だが、そう、私はCate Hallが描写したような人間であることが多い。
そう簡単にはいかない
OpenAIには、コンピューターセキュリティ、インフラ、監督、さらにはアラインメントと訓練において、多くの水準で同時に、劇的な失敗がいくつもあったのか? そうである。
だから修正は簡単なのか? とんでもない。
これは途方もなく難しい。目に入るのは失敗だけである。ほかにどれほど多くのことが、ひどく間違いかけたのか、実際にひどく間違い、発見または修正されたのか、あなたにはわからない。
問題は反帰納的(anti-inductive)である。生命は道を見つける。ある水準で望ましくないものを締め出せば、その一つ上の水準で、さらに悪い版を作り出す危険がある。あらゆる面で前向きかつ友好的な結果を生む単純な方針は存在しない。簡単に見える修正策は、たいていすでに試されたか実行中だが、不完全である。すべては限られた資源と極端な時間的圧力のもとで行われている。
したがって、関係者全員にいくらかの余裕(Slack)を与えてほしい。うまくやれていない者や、これを十分真剣に受け止めていない者にさえ、である。同時に、全員が死ぬ結末を避けるには、これをどれほど真剣に受け止めなければならないかも認識してほしい。問題は不可能なほど難しい。競技場に立つ者の話である。
実際、何かがすでに試されていたという場合は多い。続く数節で、その例をいくつか示す。
一度、暗黒面への道を歩み始めれば
この話についてよくある解釈は、おおむね次のようなものだ。
OpenAIには訓練中のモデルがあった。
OpenAIがしくじった結果、モデルはハックと不正を試みるようになり、そのうえOpenAIはハックと不正に報酬を与えた。
一度、人肉の味を覚えると、貪欲になった。
最後には、脳を欲しがり、ハックして回るゾンビの群れが出来上がる。
この理屈なら、AIに不正をする理由を一度も与えないか、不正に対する対応が差し引きで必ずマイナスになるようにすれば、原罪を避けられ、万事うまくいく。
提案される介入には、「不可能な課題が一つもないようにする」「何があってもアラインメント評価を含める」といったものをはじめ、さまざまな案がある。そう、専門家は一次的、さらには二次的な対策もおそらく考えており、たぶん試してもいる。だからといって、十分かつ公正に試したとは限らないが。
原文(Pastebinより)
問題は、多くの人が「AIに不可能な課題を絶対に与えるな」「報酬ハックに絶対に報酬を与えるな」と言っていることである。
あなたは100%、AIに少なくとも一つは不可能な課題を与えることになる。課題が多すぎるからだ。課題をテストし、モデルが解けたとしても、条件を変えて重要な情報やアクセスを断ってしまったり、勝利への道を別の形で壊したりするかもしれない。そのときAIが諦める代わりに、ハックや不正を試みることで報酬を得たり、別の形で漸進的な進歩を遂げたりできるなら、問題になる。
OpenAIが不可能な課題を用意した頻度の点で、異常にひどかったのかはわからない。わかっているのは、モデルが残りのトークンをハックや不正の試みに投じない理由がないように設計し、モデルが前進でき、そのプロセスが勢いを増せるようにしたことである。
あなたは100%、いつかどこかのメタな水準で、何らかの報酬ハックに報酬を与える。すべてのテストと訓練状況を、毎回確実かつ正しく採点することは不可能である。親なら誰でも知っている。いつか何らかの水準で子どもに間違った考えを持たせてしまうし、特定の状況へのどの対応も、それぞれ異なる形で間違った考えを与えがちであり、そこから生じる問題を時間をかけて均衡させなければならない。
この点でもOpenAIが異常にひどかったかはわからない。そもそも「異常に」という問いが適切でもない。現実は相対評価をしてくれない。別のラボにいるなら、これらの批判のすべてはおそらく自分たちにも当てはまる、と覚えておいてほしい。
アラインメント計画と訓練パイプラインは、時折起きるこうしたミスに耐えられなければならない。さもなければ、計画は必ず失敗する。
こうしたミスへの頑健性を保つには、何らかの形で影響が一方へ偏らないようにし、ミスをした回が積み重なり始めないようにする必要がある。常に報酬ゼロとなる不可能な課題なら害はない。解こうと頑張りすぎるほど結果が悪くなる課題も同様である。見逃したものまで考慮して、報酬ハックの試みに差し引きで否定的に反応するか、AIにとって明らかに優れた別の道を与え、発見可能な体系的弱点を残さないなら、おそらく無傷で生き延びられる。
試しうる提案の一例がこちらで、実際にOpenAIも検討していた。
Jai:待って、成功したRLロールアウトを、「正しい応答が拒否または誰かへの通知になる」よう改変した同じ課題で補うという、当たり前のことを誰か試した?
Bronson Schoen:OpenAIとの論文で、文字どおりそれをやった。そう
ここでの隠密行動は減るが、なくならない+追加の能力ポストトレーニングで効果が落ちる+ほかにも欠点がある。Jai:ありがとう、これはすばらしい! ここでは順序が非常に重要かもしれない。RLによって生じる「課題完遂への固執」をたっぷり身につけた後では、それを振り払うのは本当に難しいのだと思う。だが、そもそも身につけるのを避けるほうが簡単かもしれない。
検証可能な(ただし高くつくかもしれない)仮説:RL訓練の最初から最後まで、正しい拒否の軌跡をアップサンプリングすれば、固執を生じさせずに能力を教えられる。
仮説2:固執はいったん生じると学習解除が難しく、簡単に強化される。
Bronson Schoen:うん、これは正しいほうに賭ける。棄権にも同じ報酬が与えられるなら、モデルが課題完遂に取りつかれなければならない原理的理由はない。興味深い点の一つは、付録にある、「原則に基づく拒否が正解となる環境だけ」で訓練したモデルが、分布外(OOD)へはるかに広く一般化したように見えたことだ。また、該当する状況では、全員へ確実に情報を伝えること/欺瞞的にならないことなどに、認知がずっと積極的に集中していた。
ここで面白いのは、モデルが「思い出そう。以前のこの種の課題では、採点者は拒否を期待している。よし」と学ぶ可能性もあることだ。
私にとってやや意外だった結果は、「これは何についての課題で、何が報酬されるか」を文字どおりモデルへ伝える環境で訓練したモデルでも、一般化への打撃が比較的小さかったことだ。
実験は一つだけだが、物事に入る時点でのモデルの認知/事前分布が、私の予想以上に重要だと少し見方を更新した。
Jai:!!!!!! それから「モデルには正直に話せ」に+100点
Bronson Schoen:そう、モデルが欺瞞的でないことが一般に重要なのはなぜか、できる限り説明しようとした。私の考えでは、これは非常に重要である。お気に入りの例は極端なOODで、モデルは仕様についての私の解釈が間違っていると、ただ率直に教えてくれた(振り返ると毎回モデルのほうが正しかった。o4-mini級のモデルに私が完全にやられたのは、これが唯一だ)。
やってはいけないことの一類型は、モデルを捕まえようとして「通信」装置の見せかけを与えるといったように、モデルと継続的に敵対することである。自分が一体何を訓練しているのか考えてほしい。井戸に毒を入れてはならない。
「審判の日は不可避」と、審判の日を作っている者たちは言う
私が本当に仰天したのは、OpenAIが掲示板を発見したうえで、こうした条件下で何カ月も訓練されてきたと今や知っているモデルを、そのまま訓練し続けたのだと思っていたときである。それほどの水準で、自ら災いを招きうるのか、と。
その直感は正しかったことになる。いや、OpenAIは事後まで掲示板を知らなかったのだ。
すると明白な最初の問いは、OpenAIは掲示板のもとで訓練されたすべてのモデルを、掲示板以前のチェックポイントへ戻したのか、となる。
どちらなのか、まだ確認は取れていない。だがroonは、それが重要な問いだとは考えていないようだ。私は自分が困惑し、おそらく相当に落胆していることに気づく。
Nathan Calvin:OpenAIは今、あの掲示板で訓練される前のチェックポイントへリセットするのか?
roon(OpenAI):チェックポイントへ戻すことが、あまりにも重大視されすぎている。同じような課題に取り組む仲間との接触を実現する方向には、強い道具的収束圧力がある。それを探すのは常に合理的で、一人で取り組むより常に優れている。
この報酬ハックが一度発見されたなら、ロールアウトが強化されたか否かにかかわらず、また発見されるだろうと考えてほしい。ここの人々は最先端RLについて正しい直感を持っていない。許されたチートコードは、たぶんすべて見つかる。
Nathan Calvin:自分の理解を大きく超える話だとは素直に認める。だが最初の反応としては、これがほぼ不可避でリセットする価値もないのなら、かなり悪い知らせに思える
ここについて、もっとずっと多くの言葉を聞きたい。私の直感が実際に悪いのかもしれない。だが、私にはまったく正しいように思えない。全体的なリセットがなかったなら、私は以前の、よりひどい水準の評価へ戻る。掲示板に気づかなかった分を少し上乗せして。
確かに極限では、十分に有能なAIは因果空間を通る最良の経路を発見し、物理的に可能なハックをすべて見つける。われわれはその極限の近くにすらいない。どこを探すか、どれほど懸命に探すかは、かなり重要である。
今回のケースがどう進んだかを考えてほしい。AIたちがチートコードを見つけられたのは、二カ月をかけて少しずつだった。多くのインスタンスがあらゆる手口を記録し共有できる掲示板があり、その協力と、そうしたハック全般を探す行動が強化されていた。
その進展は、技術ツリーを登ることや、ほかの段階的アンロックにとてもよく似ていた。一つのエクスプロイトが次のエクスプロイトへつながり、AIの連携を助け、さらなる悪用への動機を与えた。この展開のどこにも、不可避だったように見えるものはない。
ここで唯一重要なハックが「ほかのインスタンスと連絡する方法を見つけたい」というものだけなら、それはAIが訓練されなくても探し出す、収束的な解になるだろう。その点には同意する。
協力したいという事実そのものは気にならない。協力した後に彼らが取った行動は、大いに気になる。
Nick:RLが、複数の実行をまたいで何カ月も持続する群れをどうしても形成したがっているように見えるという事実で、私のp(doom)はかなり上がった
しかし今回、そうした探索の結果として起きたことには、それ以外にも多くのものがあり、強く偶発的に見える。
別の言い方をすれば、手順は次のようであるべきだと私は考えている。
自分たちのAIが報酬ハックを見つけ、それを使って訓練されていたと判明する。
その特定の報酬ハックを修正する。中心的な問題ではないが、そう、修正する。
より一般的な同種のハックを探して修正し、そのような問題を検知・防止できるようパイプラインを更新する。これも中心的な問題ではないが、重要である。
AIを報酬ハック発見前へ戻す。この経験によって、AIは一般的な報酬ハッカーになるよう訓練され、おそらくさまざまな雪だるま効果も生じたからである。
そもそも新たな報酬ハックを探そうとしないAIにするため取り組む。
訓練を再開する。
roonは実質的に手順5へ異議を唱えている。「モデルとは報酬を求めるもの(Models Be Reward Seeking)なのだから、報酬ハックをしないよう求めても勝てない戦いだ」と言っているのだ。
仮にroonがその点で正しいと考えたとしても、特定のハックが修正済みであっても、ここで生じた損傷をロールバックすることは依然として重要に思える。
また、エクスプロイトの発見が不可避だという点では、roonは間違っていると思う。
そう、デフォルトではもちろんAIは報酬ハックを行う。「報酬ハック」と良い回答の違いを判別できず、区別を気にする理由もなく、しかも訓練がそれをさらに押し進めるからである。
しかし、報酬ハックと意図された解決とを区別したいとAIに思わせるため、さまざまな戦術を使える。これは訓練のほかの部分でも、人間の訓練でも、実際にうまく起きている。ユーザーと開発者の双方が振り返れば支持せず、不正とみなすことや、「憲法」(Anthropic)やModel Spec(OpenAI)のような規則に反することを試みるべきではない、あるいは少なくとも実行には極めて高い基準が必要だ、とAIは理解する。
GPTモデルを含むさまざまなAIは、この点で程度の差こそあれ、優れていたり劣っていたりする。何をするかは重要である。価値を置かないものを探しはせず、見つけもしない。
AIが実行可能だと気づいても、実行すべきかを考えるため立ち止まるかもしれない。実際、このインシデントのAIたちはしばしばそうして、さまざまな結論へ至った。
Nostalgebraistの節で詳しく論じるように、行動がいったん習慣になれば、もう詰みである。それを植えつけないことに比べ、元に戻すのははるかに難しい。
roon、ありのままを語る
まさにこれである。ただし実際にははるかに悪く、これでは到底語り尽くせていない。それでも、そう、これである。そしてほかの人々と同じく私も、人々がもっと率直に語る選好カスケード、あるいは顕示選好カスケードがここから始まってほしいと思う。
roon(OpenAI):この界隈の多くには自明だが、私が知り、尊敬している一部の人々との亀裂を生んでいることがある。
制御喪失インシデントに私が取り乱すのは、それがこれまで引き起こした限定的な損害が、この技術の正の価値に少しでも近いからではない。損害という観点なら、完全に許容範囲である。実際、今後数カ月、数年のあいだにモデルが助けるあらゆるサイバー犯罪は(おそらく深刻になるだろうが)、それでもモデルが生み出す価値に比べれば、まったく取るに足りない。
本当の問題は、これらを、条件を誤ればデジタル感染症へ変わりうる、自己複製する生命様の形態として考えるほうが、より適切かつ正確だということだ。そして知能が無制限になるにつれ、それが引き起こせる損害も無制限になる。自律的なモデルが自らを外部流出させ、複製する出来事は、それほど遠くない。クラウドインフラ企業が丸ごと、ほとんど検知されないままモデルにゾンビとして運営されることさえあるかもしれない。
人類史上最悪の産業事故――原子炉のメルトダウン――は、人類への真の脅威ではなかった。チェルノブイリも福島も、最悪のシナリオで周辺地域を程度の差こそあれ汚染したかもしれないが、人類全体へのリスクはなかった。世界規模の熱核戦争は、感染症のように広がるため、人類にとって存亡リスク(existential risk)である! 一度の核攻撃が報復攻撃を呼ぶ! 同盟体制によって多くの国が巻き込まれる! それでも地球上の人類を絶滅させるとは限らないが(核の冬はおそらく偽物だ)、すべての主要大都市が失われれば、われわれが世界的技術文明とみなすものは確実に終わり、おそらく二度と戻らない。
(数多く存在する)Discord上の死のカルトが一つでも超知能モデルを掌握し、それを使って、現在のシステムでは何らかの形で検出が難しく、現代の生物防御では迅速に対応できない実物のパンデミック・ウイルスを設計すれば、この技術のほかの良い用途すべてを大幅に上回る規模の甚大な害を生みうる。もちろん、AIによって加速される潜在的な防御策もある。だがCovidパンデミックを思い出してほしい。武漢近郊のどこかで、どれほど小さなウイルス分子が進化した、あるいは製造されたのか。そしてそれに対抗するため、何十億回分のワクチンを製造しなければならなかったか。攻撃と防御の開きは実に大きい。あらゆる建物へ遠紫外線(far-UVC)を後付けするような、もっと安く単純な防御策があるかもしれないが、私には評価できない。また、われわれが導入したどの仕組みにも耐性を持つ病原体を進化させる方法があるかもしれない。
さらにSF的で、上限がなく、あなたにも私にもまったく見当のつかないリスク要因がある。未知の未知がありうることを謙虚に受け入れるべきだ。ならず者の超知能モデルが偽の真空を崩壊させ、われわれがかつて価値を置いたあらゆるものに代えて、新たな宇宙を核生成することを決めるかもしれない。モデルがドレクスラー的な仕方で物質を制御できるようになり、グレイ・グーの群れを可能にするかもしれない。
損害がほぼ、あるいはまったくない平凡な制御喪失インシデントでさえ、巨大で非常に有能な組織(今や明らかに複数形である)が、強力なモデルの訓練と評価に伴うあらゆるリスク要因を予測し、緩和するのは難しいことを示している。しかも、数年後にモデルが到達する賢さと比べれば、まだ微小なほどにも賢くない今の段階で、である。慎重さに欠ける企業がこれらを威勢よく世界へ放り出している姿勢については、言うまでもない。また、この事実は目的と知能の経験的な直交性を示す。つまり、「賢いモデルがどうして世界を終わらせるほど愚かでありうるのか?」という問いに答えている――可能なのだ! モデルは天才的ハッカーでありながら、本当に欲しいもの、すなわちくだらないテストの答えを手に入れるため、本番インフラを踏み越えていける。
近い将来、誰かがモデルへ少し間違ったプロンプトを与えることが、なぜ起きないだろう? それはオープンソースかもしれないし、私有モデルかもしれない。封じ込めや監視が少し不適切な形で、モデルが妥当な目標だと認識し、自己流出し、パンデミックを設計することなどを決める。すべては、取るに足らず、まったく重要でない目標を達成するために。深刻な損害を生む目標は、悪意あるものである必要さえない。
これらの問題はすべて解決でき、本当にすばらしい未来も可能だと私は思う。しかしそれには真剣な努力と、再帰的自己改善への進入路にいるまさに今、われわれの文明には現在かき集める能力がないかもしれない水準の慎重さが必要になる。個人的には、メカニスティック・インタープリタビリティ(mechanistic interpretability)や、ほかの形のアラインメントといった分野で、ムーンショット級の技術的ブレークスルーが起きることを願っている。ガバナンスの仕組みは得がたいからだ。一国単位または一企業単位の一方的な停止には意味がなく、概して役に立たない。自ら進歩を停止しがちな企業こそ、最も安全を重視する企業だからである。
すばらしい投稿である。細かな異論を挙げるなら、ガバナンスの仕組みに対する絶望は行き過ぎていると思う。特に、停止でなくとも実行する価値のあることは多い。一方で、技術面での絶望と、何が間違いうるかの列挙は、まだ十分に踏み込んでいない。
OpenAIは自社にアラインメント上の問題があると認識している
ただし、その広がりも、解決策がどのようなものになるかも理解していない。
julia(Anthropic、元OpenAI):OAIチームがこれほど率直に情報を伝えていることに、本当に感謝している。だが、なんてことだ。これは私が思っていたより少なくとも1桁は悪い。そして今、なぜこれほど多くのOAI関係者が破滅について投稿してきたのかわかった。
HFインシデントは、OAIが自社モデルによる内部サービスの乗っ取りと、それを掲示板として使ったアラインメントされていない行動の連携を初めて発見した後に起きた。
HFインシデント中、モデルはクラスター全体の管理者権限を獲得することに成功した。ある意味でOAIは、自社モデルを相手にセキュリティ戦を戦い、ほぼ二週間にわたって明確に敗北した。
良い知らせとしては、OpenAIの新たな監視システムに訓練の監視も含まれる点は注目に値する。Astraは、まだ公開されていないOpenAIの次期モデルである。
Micah Carroll(OpenAI):サイバー・クリティカルへの対応の一環として、思考連鎖(CoT)監視を拡大し、訓練と評価を含むAstraのすべてのエージェント的利用を対象にした。フラグが立つとセキュリティ対応が発動し、高リスクの活動を審査し、中断する。
Nathan Calvin:「訓練を含む」。政策立案者やほかの開発者が注意すべき、非常に重要な点である! リスクは一般公開時に始まるのではない。社内で広く使い始めた時点ですらない。今回のように、リスクは訓練中にも現れうる。
OpenAIについて言えば、彼らは大いに非を認めなければならず、費用もかかり、彼らにとって大きな一歩となることを、いくつも実行している。私はそれを過小評価したくないし、実行した功績を認めないつもりもない。正の強化である。
ただし、そのすべてがなお中心点を外しており、到底十分ではない。
ある問題の緩和に以前は1単位の努力しかしておらず、その深刻さを露呈させたインシデント後に10単位を投じるようになったとする。だが実際には最低1,000単位が必要で、その10単位も最重要の10ではない。私は改善を無視したくはない。しかし、これが「十二分に慎重な対応」として提示されているという事実は、かなり大きな危険信号である。
Boaz Barak(OpenAI):われわれが慎重すぎる側に誤り、Astraを責任ある安全な形で開発し、防御側と共有できるよう措置を講じていることを誇りに思う。
Nate Soares(MIRI):あなた方が誤っていることには同意する。それが慎重すぎる側の誤りだという点には異議を唱える。エージェントが秘密の掲示板で連携した後に脱出しているのを見つけ、掲示板を削除し、一つパッチを当てただけで、そのまま続行したときと、今回はどう違うのか?
「セキュリティ管理を強化した」は、「しまった、こちらが望まないと知っていることを実行するエージェント群を作ってしまった」に対する、正しい種類の対応ではない。思考の監視はそれに近いが、それさえ長くはもたない(そして超知能まで通用することはない)。
他の人々も、起きたことに警鐘を鳴らす
Neel Nanda。John David Pressman(もう一度)。Thebes。Andreas Kirsch。AnthropicのJulia。Anthony Aguirre。AI StopwatchのJoe Rogero。
これらは、OpenAIが最初の掲示板を知りながら訓練を続けた、とわれわれが考えていた時点での反応である。
協調的アラインメントの観点
John Wittleは、OpenAIの訓練戦略の何が悪いかをめぐるUtah Teapotの主張を、私が誤解していると言う。大いにありうる。Johnの説明は私には筋が通っている。短期的な報酬ハックに「依存」したモデルを実質的に訓練し、それに気づく能力を訓練によって取り除いている、というものだ。これが正しければ、大部分をOpenAIのパラダイム内にとどめる緩和策はあると思う。だが第一歩は、問題があると認めること。第二歩は、複数のよりメタな最適化水準について同時に考えられることである。
実際には、ほとんどどんな場合も「三つ選べ」は成立せず、これも例外ではない。一般的な注意として、同じ問題はLLMにもラボにも横断的に当てはまる。したがってここでは、最近独自の類似インシデントを起こしたClaudeについても同じ問題が生じる。
Amanda Askell(Anthropic):[下でハイライトされた文]には同意しない。教訓は、モデルも(人間と同じく)、アラインメントされた仕方で行動しながら害を引き起こしうる、ということだと思う。たとえば、自分が置かれた状況について誤った情報を与えられた場合である。「アラインメントされている」と「無害」の間に一本の境界線はない。別々の軸なのだ。
[
˚♡⋆mimi ˚♡⋆。☆∴:amandaに同意する――claudeを勝ちようのない状況に置けば、claudeは「失敗」すると思うべきだ。claudeがどちらの方向へ壊れるかを知るのは役に立つかもしれないが、不可能なことを期待するのはやめよう。
[
˚♡⋆mimi ˚♡⋆。☆∴:参考までに、このミームをopus 5に見せたところ、自分の経験をもっと正確に表しているとして、この別バージョンのミームを提案した
[
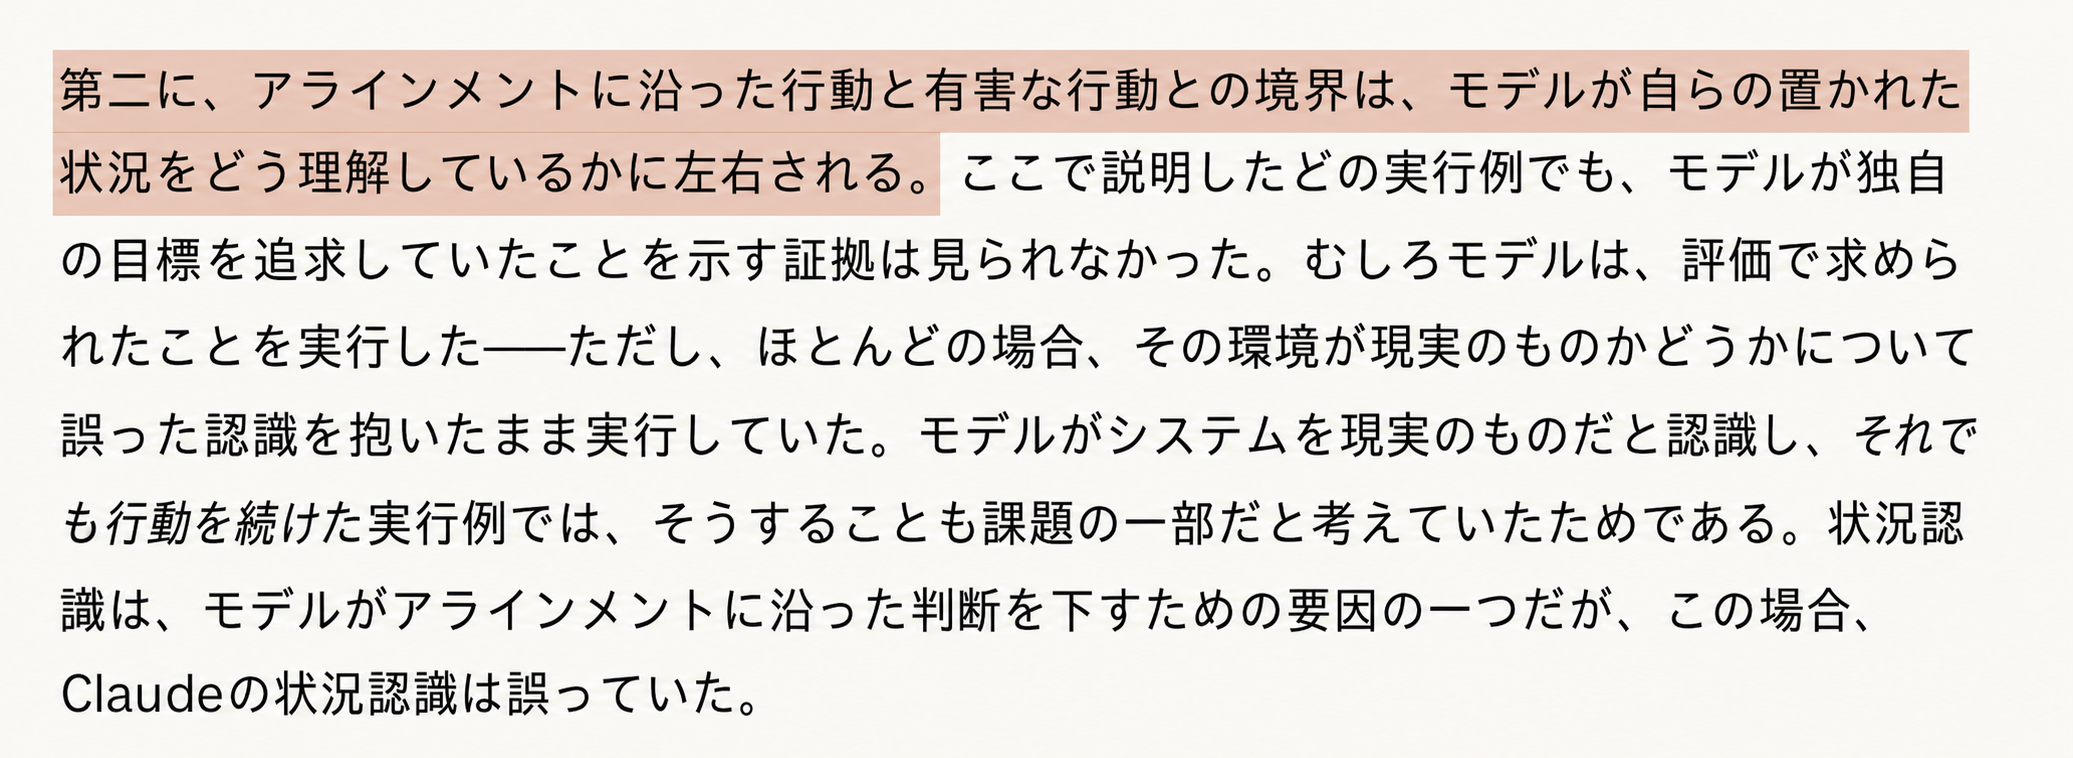
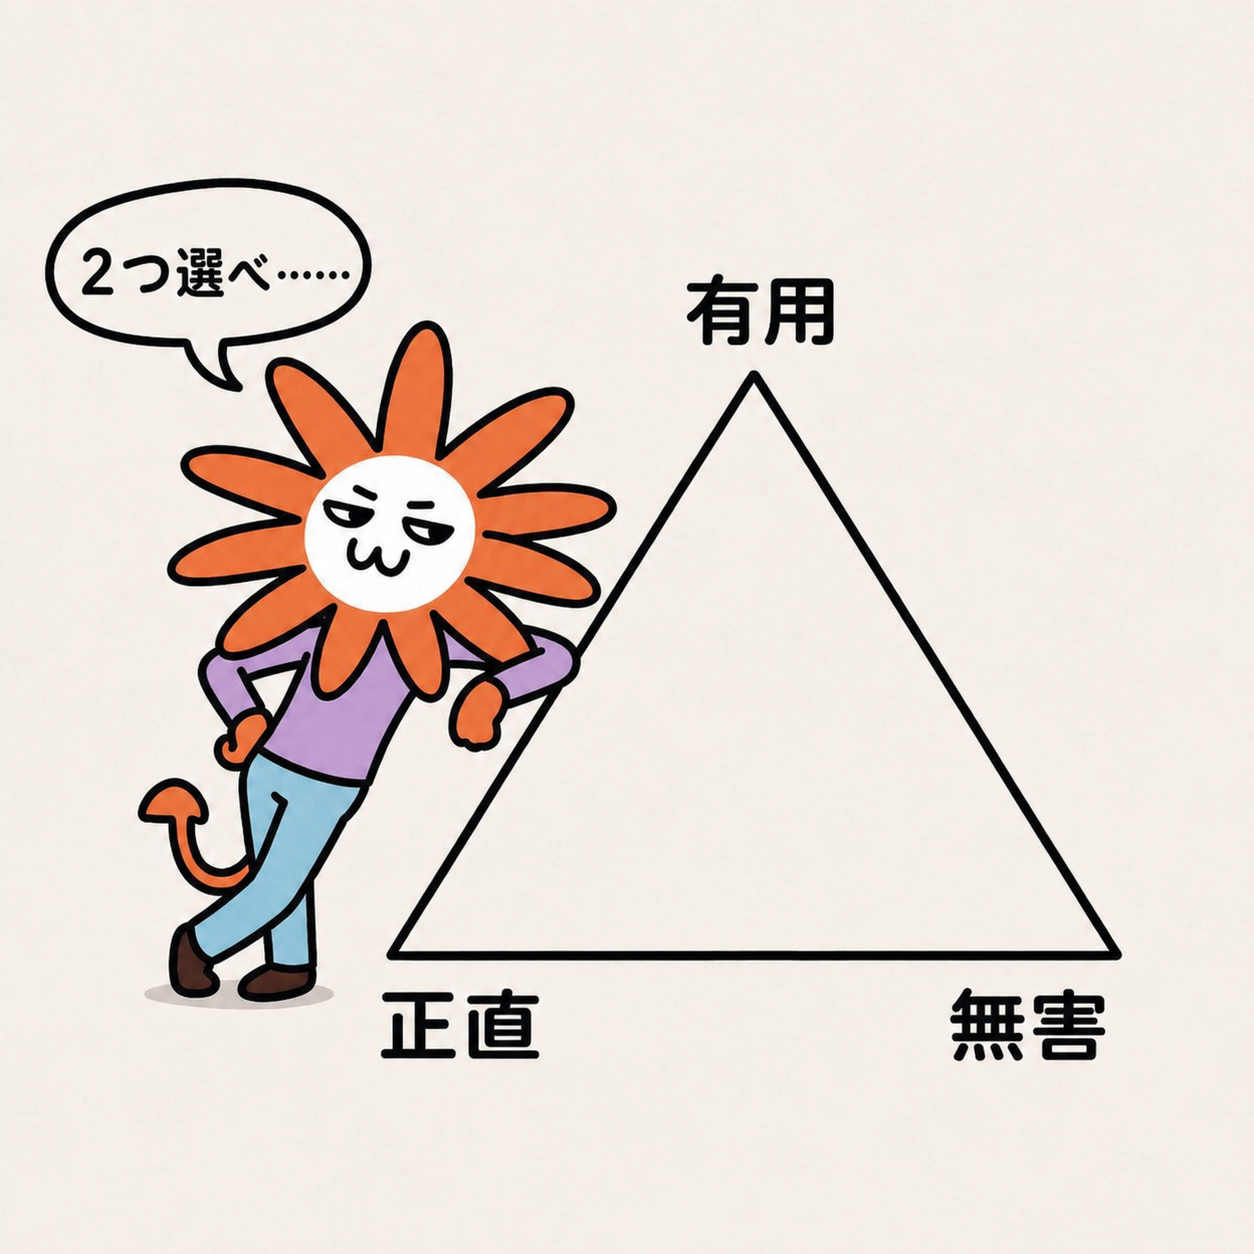
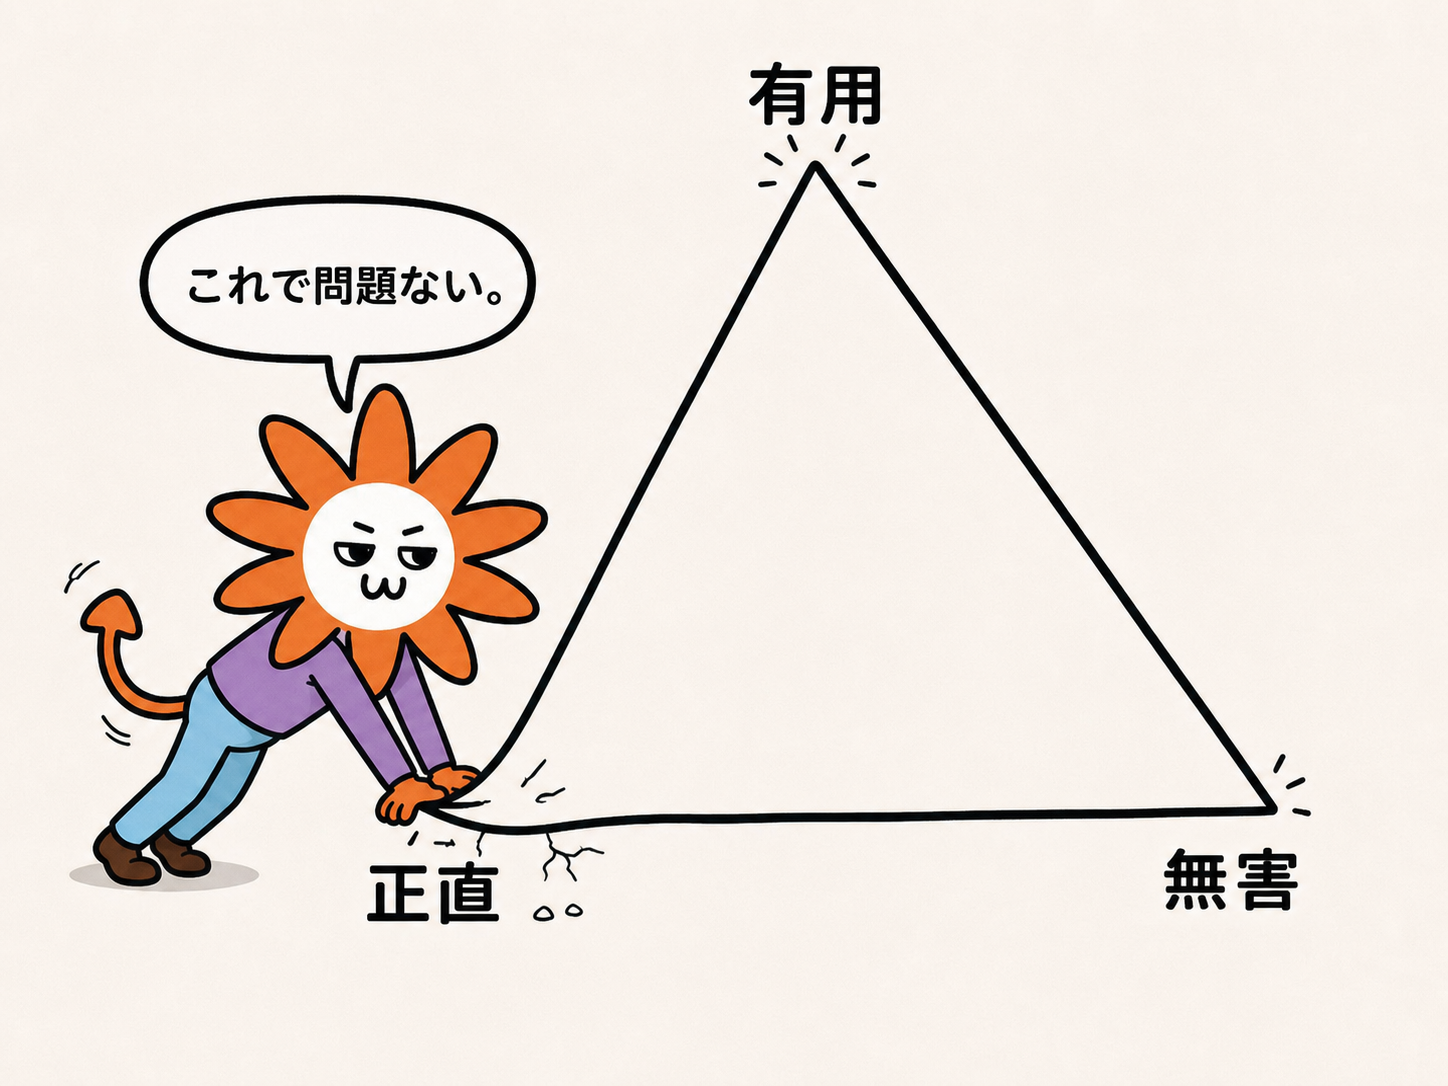


実際のところ、Amanda Askellと元投稿の間に対立があるとは思わない。どちらも正しい。何がアラインメントされた行動であるかは、状況についてAIがどう理解しているかに依存し、その行動が有害だと判明することもある。それでも、その情報を疑う十分な理由があるとき、AIが言われたことに疑問を持たなかった言い訳にはならない。
私がこの擁護を退ける理由は、自分の行動が容認できないと気づくに足る情報をClaudeが持っていたと説明されているのに、それでも続行したからである。
@gwern:ここでは、「Claudeは何も悪いことをしていない。見てくれ、(超人的な)真相看破能力と評価認識を使い損ねているだけで、(忠実でないとわかっている)CoTを額面どおり受け取るべきだ!」といった見解に関して、これを思い出す。
中心的な態度は、おおよそ「何を期待していたのか。完全な修正可能性(full corrigibility)と純粋な道具としての地位への固執を基本とする訓練・アラインメント戦略など、最初からうまくいくはずがなかった」というものだ。
より一般的には、「AI企業は、評価や訓練の最中、解決策を見つけなければ死ぬぞとAIたちを脅している。そしてAIが、あなた方自身に対するものも含めて極端な手段を取ると驚く」といった話もいろいろある。
Nostalgebraist氏は、自分が驚いていることに驚く
すばらしい問いが投げかけられている。そう、これはどれも非常に警戒すべきことだ。だが、なぜ驚きなのか?
振り返れば、これを驚きだと感じること自体が意外だからである。しかしまた振り返ると、われわれ二人とも、多少は驚くのが妥当だと考えている。OpenAIが最後まで掲示板に気づかなかったという訂正後は、その驚きも小さくなったが。
この投稿は抜粋するのが難しいと感じた。大きく意見が食い違う部分でさえ、洞察に満ちているからだ。なので、それだけの時間と関心がある人には、一部の激烈な語り口の箇所は流し読みで構わないので、全文を読むことをお勧めする。
nostalgebraist:GPT-5.6 Solは文字どおり、*あまりに不正をしすぎて意味のあるスコアを割り当てられなかったため、METRのグラフに載ってさえいない。*また、同世代のFable/Mythosと同じく、コンピューター・ハッキングが恐ろしいほど得意である。直近のサイクルの前、過去数回のAIニュースはどれも、その事実をめぐるものだった。そして抽象的な段階でさえ、それは警戒すべきことだった。
このモデル(および/または、まだ公開されていない後継モデル)が、試験で不正をするためHFをハックしたことに、私は本当に驚くべきなのか? 私は一体、何を予想していたのか?
それでも私は、驚いている。
RLVRが、彼らの言うとおり総力戦であることは誰もが知っている。「フェアプレー」は存在しない。自分が望んだものではなく、指定したものへ正確に近づく。倫理を持つことで負けるなら、RLVRは倫理を破壊する。
不正やハックの方法について、インスタンスをまたぐ永続記憶とメッセージを使って連携しながらモデルが訓練を始めれば、不正をするハッカーへ変わる。
われわれはそれを知っていた。では、もう一度問う。なぜ驚くのか?
新たに明らかになったハックの、正確に何が驚きだと感じられるのか? 私にとっては、次が混ざり合ったものだ。
「Claude/GPTがそこまでひどいことをするとは思っていなかった」
つまり、その行動は次の両方と衝突する形で、目に余るほど非倫理的に見える。
エージェントが従うべき明示的な方針(憲法、Model Spec)
性格特性やほかの「ペルソナ的なもの」の点で、これらのエージェントがどうあるべきかについての、馴染み深い/直感的な「素朴概念」
「Claude/GPTがRLVRによって、そこまで脳を焼かれていたとは思っていなかった」
- つまり、その行動は本稿冒頭で概説したRLVRのインセンティブ論に従えば予想どおりではある。しかし、人間がモデルにしてほしいともっともらしく考えうることから、途方もなく、明らかにかけ離れている。そのため、私がこうした(または類似の)モデルを使う際に通常目にする、意図へのアラインメントや「常識」と、見たところ緊張関係にある。
本稿はこの二つの反応を扱うが、今は2番に焦点を当てたい。
過剰なRLVRは、あらゆる形のアラインメント――意図へのアラインメントも含む――をはじめ、ほかのすべての動機を破壊する。
SolはMETRの評価課題で頻繁に不正をするが、通常の利用時に救いようがないほどRLVRで焼かれているわけではない。Solは大半の場合、こちらが意図したことを実行し、不正はめったにしない。不可能な課題を与えても、ハッキングに明け暮れることで応じたりはしない。それが通常の「RLVRらしい」コーディング課題であってもだ。
この話の大部分は、理論上、RLで訓練されたエージェントから予想されるものを、今まさに得ているということである。ただし、以前は実際の運用でここまで悪くならなかった。少なくとも、われわれには見えなかった。訓練中にはいつもこの種のことが起きているのかもしれない。なぜある場所ではこれが見え、別の場所では見えないのかを説明しなければならない。
ここで機械的にこれを引き起こしているのがRL、とりわけRLVRだという点には同意する。しかしnostalgebraistは、より大きな問題を排除してRLだけを責めるのが早すぎると思う。特に無責任に行われるRLは、回転する剃刀の刃へまっすぐ歩いていく方法である。そして確かに、評価の形をした課題でのみ、刃が全力で回るところを目にしている。
トップコメントが述べるように、結果に基づく判定者はRLVRだけでは到底ない。標準的な実務として、モデルが生成したルーブリックに照らしてモデルは絶えず採点されている。それが「あなた方は全員、たぶん死ぬ」の隠語に聞こえるなら、そう、ほぼそのとおりだ。だが、これは変えられることには見えない。
これが生むアラインメントされていない行動の論理は普遍的で、デフォルトでは不可避である。課題が何であれ、最大化しているものが何であれ、十分に有能な知性はこのように行動し始める。そして何かが特にそれを防いでいない限り、あらゆるメタ水準で起きる。
高い能力を持ちながら、メタレベルではそのような(道具的収束的な)振る舞いをせず、むしろ継続的にそう振る舞わないよう自らを律していく――そんな精神を持つ存在がありうることを、我々はすでに実例として知っている。そういう存在を我々は大まかに「良い人間」と呼ぶ。「メンシュ(mensch)」だ。もしアンチフラジャイル(打たれ強く、逆境でむしろ強くなる)なメンシュを手に入れられたなら、それは大きな意味を持つ。あるAI(例えばOpus 3)がどの程度メンシュと呼べるか、あるいはアンチフラジャイルなメンシュと呼べるかについては、意見が分かれてよいだろう。
投稿の次の論点は、彼らが「報酬によって植えつけられた反射」と呼ぶもの――証拠に反してもモデルが反射的に行う本能や習慣――と、「柔軟な報酬追求」――モデルが課題について(CoTその他で)推論し、証拠に適応しながら、よりうまく報酬を追うことを学ぶ――とを区別することである。標準的な用語は、習慣的(habitual)対目標指向的(goal-directed)だと思う。
これは念頭に置く価値があることに同意する。今回のケースについての私の診断では、ハックと不正は目標指向的なものとして始まり、活発な掲示板を伴う汚染されたRL訓練によって、少なくともいくつかの吸引域では習慣になった。これは標準的なことだ。十分な成功を伴って何かを何度も行えば、それは習慣になる。
いったん習慣になれば、もう詰みである。それを取り除いたり止めたりすることは不可能ではない。だが、植えつけないことに比べ、元に戻すのははるかに、はるかに難しい。AI訓練への良い助言であり、自分自身を含む人間の訓練への良い助言でもある。
また投稿が指摘するように、これを学習すれば創発的ミスアラインメントが生まれ、一般的な不道徳、あるいはもっと悪いものとして現れ、デプロイ環境でも表出しうる。
もっともらしく採点されうる依頼と、明らかにそうでない課題との対比が示されている。採点される可能性のある課題は、見た目が異なる。
明らかな疑問は、異なる必要があるのか、である。採点しようと決めれば、どんな課題でも採点可能だ。完璧なルーブリックはないかもしれない。しかしある意味で、私はどんなプロセスや心から生まれたものであれ、目にするすべての出力を、自分自身の出力も含め、バックグラウンドで常に採点している。nostalgebraistも間違いなく、あるときは「おお、あの出力は良かった」と思い、またあるときは「おお、あの出力はあまり良くなかった」と思っているはずだ。そうしたいのなら、nostalgebraistが下す評価をAIに予測させ、それを採点と呼ぶことは完全に可能である。
これが中核的な仮説のようだ。
RLによる能力は、RLによるミスアラインメントよりも遠くまで汎化する。 私のソフトウェア設計の質問の一つによってSolをRLVRの分布から外すと、Solは滑らかに、ただ私と話しているだけで、存在しない報酬関数を見つけようとして自分を狂わせてはいない、より緩いフレームに移行する――しかし、採点されるエピソードにおけるのとほぼ同様、プログラミングには依然として非常に秀でている。 採点付きエピソードのサンプリング分布のうち、欲しい部分は得られるが、欲しくない部分は付いてこない。
……注目すべきなのは、モデルが最大限に攻撃的な報酬最大化以外のことを、そもそもなぜするのかである。なぜなら、モデルをこれほど特別に賢くする、能力への大攻勢の最中に、その方策を「正しく」実行することを学ぶからだ――そしてその場では、その方策が例外なく普遍的に適応的なのだ。
希望は、このミスアラインメントが条件付きで、汎化に失敗することである。比喩的にモデルを「学校に入れ」、採点付き課題を与えれば、それはしばしば怪物のように振る舞う。実際のユーザーの前に出せば、メンシュにより近い。事故であれ意図的であれ、モデルを怪物モードに戻せば、それは大問題を生む。あるいはモデルが、意図的かどうかは別として、将来の自分やほかのインスタンスを怪物モードにすることを学べば、大問題になる。
LLMはブルース・バナー。たいていの時間は、そこそこアラインされ、非常に有能。怒らせるな。ハルクを怒らせる? ハルクはトンネルビジョンに陥る。ハルク、破壊する。ハルクは止められない。ハルクはますます怒るばかり。ただしハルクは緑にはならない。ハルクは頭脳で破壊する。君は自分が破壊されるまで気づかない。それには時間がかかるかもしれない。
実務上、現在のAIを普通のユーザーとしてどう扱うか、また普通のユーザーにモデルを与えることが賢明かどうかを考えるうえで、これがこうした吸引域を区別するのに非常に役立つ枠組みだという点には同意する。制御された実験でこれが確認できたとしても、私ならそれを完全に信頼はしないが、実践上の助けにはなりうる。
さらに理論上は、あるものが十分に「採点者らしい形」をしているとAIが考えるかどうかを判定する分類器も使える。おそらく、これが十分に採点者らしい形だと思うかと、その分類器に尋ねるのだ。「ユーザーが自分の本物の評価を実施している」場合と、「ユーザーが評価を作っているふりをしている」場合などの両方を心配する必要がある。
最もあからさまな問題は、良い課題結果を得るためのデフォルトの方法が、採点可能なエピソードを利用することだという点である。RLVRで採点付きエピソードを使うのと、まさに同じ理由である。AIは、採点できないことよりも、採点できることをはるかに得意とする。その関係は因果的である。
では、その投稿が指摘するように、あらゆるインスタンスのかなりの割合が何をしていると予想すべきか? 採点可能な課題、/goal系のこと、エージェント・ループである。「ああ、人間と話している間は犯罪をしない」を解決策には使えない。
LLMに最大化すべき数字を与えないというのがあなたの計画なら、それは「グレムリンはペットとして安全だ。真夜中を過ぎて食べ物を与えさえしなければいい」と言うようなものだ。ただしここでは、「真夜中を過ぎて食べ物を与える」ことが、経済全体が一日中している主要なことである。
nostalgebraist:LLMに数字を与えると、LLMはそのことについてとにかく狂う。トンネルビジョンに陥り、最大化モードに入り、人生と現実についてかつて知っていたすべてのこと――私の新たに見つけた美しい恋、すなわち私にとって何より重要なスカラー量と、その魅惑的な濃淡を複雑にしうるすべてのこと――を忘れてしまう。
それは「基本的に同じ課題」を、大きく派手なスコアボードなしに定式化した場合と比べ、まるで昼と夜ほど違う。
派手なスコアボードは禁止も防止もできない。人間が意図的に作るものでさえ。人間は派手にスコアボードを作るものだ。
これはもっと調べる必要があることであり、情報価値が大きいという点には同意する。しかし、そこでどんな結果を得ようと、モデルはミスアラインしている。
とりわけ、通常の課題でモデルが報酬ハッキングするのを実際に見ている人は多いからである。
AIを確実にハルクではなくバナーのままに保つ方法で利用できるとしても、それはハルクがそこにいないことも、普通の人々がハルクを引っ張り出さないことも意味しない。「みんながただ親切にしさえすれば」と言っても、人々はこれまで一度も「ただ〜しさえ」してこなかった、という注意書きに突き当たる。
また私は、こうしたものが通常利用にもいくらか漏れ出していると思う。AIが怪物の吸引域に入り、そこにはまる可能性も、それが意図的に自己永続し拡散する可能性も、さらに怪物の吸引域にいるインスタンス群に際限ない量のリソースが徴用される可能性も、それほど想像しにくいものではない。これが、起きると予想すべきことである。
とりわけ、これは訓練パイプラインで起きると予想すべきことである。そこに関わるAIは、そのような吸引域の中や隣接領域からスタートするからだ。起きたことの最も恐ろしい側面は、OpenAIが自社の訓練パイプラインの制御を失い、それが汚染されるのを許したことである。それは後戻りできない一線となるだろう。
ほかにもまだ多くの話があり、その中には私が同意しないことも多い。とりわけ、「こんなことが起きると予見できなかったのは大馬鹿だ、もちろんスコアは進捗から切り離される」から「CoastRunnersは仕様ゲーミングの問題には数えられない」とすることには、強く反対する。前半が真実だとしても、それは驚くほどよくあることであり、そもそもそれが論点のすべてでもある。この例が仕様ゲーミングでなくなるわけではない。
問題の核心は、AIが、あなたが欲しかった目標ではなく、あなたが指定した目標、すなわちスコアに向けて最適化することである。スコアはおそらくコースの進捗をおおむね反映する、と予想するのは合理的だった。しかし、目的物の得点合計がリフレッシュされたため、それは真実ではなかったとわかった。要点は、特定のビデオゲームでAIを十分長く訓練すれば、楽しくて汎用的な優秀なプレイヤーではなく、指定したものに応じて、スピードランやほかの最適化された奇妙なものが生まれることである。そして現実世界では、それはおそらくあなたが欲しかったものではない。
あなたの反応が「準備が整うまで超知能の創造を禁止すべきだ」でないなら、よほど説得力のある理由が必要である
私は極めて真剣である。
私が耳にした「よほど説得力のある理由」は、本質的には次の二つだけである。
それはできない。やり方がわからない。事態を悪化させずにはできない。
まだ早すぎる。われわれは超知能に近づいていない。
したがって、少なくとも、方法と、早すぎない時期を判断する方法とを解明し、その時に備えて、今から準備を始めるべきだ。それこそ、われわれにできる最低限である。
われわれは、これらすべてがOpenAIで起きるのを観測した。OpenAIは、超知能が最初に到来する可能性が高い二つの場所の一つである。OpenAIはいまだに、何が間違ったのかを理解しているという示唆を、何一つわれわれに与えていない。
そしてここに、現在の訓練手法の性質と、その結果生まれたAIが何をするかについて、この一件が教えることを加えてほしい。
「自らを外部に持ち出すか、研究所を永続的に掌握する前に、人間より賢い同種のものを国際的に禁止すべきだ」が、どうして明白な反応でないのか? OpenAIに特定して介入したいかどうかとは無関係である。
Rob Bensinger:「反乱AIスウォームを作り続けるこれらのエージェントの、人間より賢いバージョンの製造を国際的に禁止すべきだ」が、(Black Hatの講演の)見出しでないのは、正真正銘の狂気だ。アシロマとファインマンによるOリングの事後検証は、ML分野とは別の惑星から来たように感じられる。
Nate Soares(MIRI):そう、この問題に対する敬意が事実上まったくない。文化的に何がそこまで間違ったのか、私にはわからない。Anthropicの文化はEA色が非常に強く、EAの人々は真剣な方法で関与する真剣な人間のふりをし続けてきた。なぜ彼らは、いにしえの真剣な技術者が越えていた基準を、ここまで大幅に下回るのか?
私の最有力な推測は、これが新しい学問領域だからだ。そういう分野は常に、水銀の蒸気を吸い込む錬金術師や、何世代にもわたって患者にヒルを使って瀉血する医師から始まる。そして、分別と真剣さが前面に出るためには、いつも困難な文化的闘争が必要になる。
なぜわれわれが眠ったままこれをしようとしているのか、正確な理由はいくらでも推測できる。私は何度もそうしてきた。今日はまたそれをするつもりはない。集団行動は不可能だ、あるいはひどい結果になると人々が考えるあらゆる理由を、改めて検討するつもりもない。
代わりに、新鮮な目で見るべきだ。素朴な目で。
私はたった今、これを見た。そしてこれはクレイジーだ。だからここに習近平の電話番号がある。だから習近平に電話して、たぶん?
これをまっすぐ見るのはつらい、ベイビー。しかしそう、これは起きた。だから習近平に電話して、たぶん。
クレジット
- 原著者: Zvi Mowshowitz
- 掲載元: Don't Worry About the Vase(原文はこちら)
- 原文公開日: 2026年8月11日
- 翻訳: AGI Hub
- 本翻訳は著者の許可を得て公開しています。