
AIテキストの透かしは、実質無料で有益である
原題: "AI Text Watermarking Is Free And Good" 著者: Zvi Mowshowitz 初出: Don't Worry About the Vase、2026年8月21日
Scott AaronsonはOpenAIで働いていたとき、Hendrik Kirchnerとともに、AIテキストの電子透かしをほぼ解決した。
その解決策は次のように働く。Tenobrusによる説明を読んでもよい。
- AIの出力は決定論的ではない。AIの仕事は、次に来うる各トークンの確率を決めることだ。その後、トークンがランダムに選ばれる。
- 本当の乱数は扱いが面倒なので、通常は各選択に疑似乱数源を使う。
- 透かしを入れるには、それ以外は同じ、秘密鍵から導出した非公開の疑似乱数源を使う。
- 十分な長さの文章があれば、その選択の並びが、別の乱数源よりも、その特定の疑似乱数源にどれくらいよく合うかを示すスコアを計算できる。
- 誰でも透かしの有無を調べられるAPIを提供する。
もっと詳しく知りたければ、完全な論文はこちらだ。この方法には、とてもよい性質がある。
- 出力への実務上の影響はない。人間には、まったく違いがわからない。
- これを行う限界費用は、限りなくゼロに近い。
- 自分の言葉で書き直せば透かしは除ける。AIが選んだ細部をどれだけ残したかに応じて、透かしも残る。
欧州連合の行動規範は、欧米の主要AI研究所が署名しており、今後のAIモデルに、こうした透かしを使うよう求める。
GoogleはGemini 3.7 Flashも含め、これを実装している。2024年から順次導入してきた。Anthropicが今していることを、Googleは公開の検出器付きで、2年以上前からそのまましている。そして2,000万件のテストで、利用者のフィードバックに違いがないことを確認した。
Anthropicは1週間前、EUの行動規範に従うため、透かしを導入していくと静かに発表した。通信の出所を区別したくはなく、限界費用はゼロで、透かしは社会のためになるので、全員に適用する。<strong>その後、仕組みを説明するFAQを出した</strong>。
別の理由で通信を区別できるようになれば、全員への透かしが悪いと判断した場合には、ここでもその区別を使うかもしれない。私は、全員への適用はよいことだと思う。
最初の見立てでは、これはよいことについての静かで前向きな話だった。よいことが、弊害も費用もゼロで実現できるなら、私たちもやることがあるのかもしれない、と示していた。だから最初の紹介は、これですべてだった。
Zvi Mowshowitz(AI #181):AnthropicはEUの行動規範に従い、今後、テキストを含むClaudeの出力に透かしを入れる。私たちの多くがClaudeの文章すべてに自動的に見ている、「これはCLAUDEの文章です」という巨大なネオンサインとは別の話だ。OpenAIも続く意向だが、期限には間に合わなさそうだ。
Ryan Greenblattに同意する。透かしによって、気づくほど品質が落ちる可能性は低い。また、Pangramと比べた透かしの欠点のひとつは、Pangramなら、人間の文章にAIが軽く手を入れただけのものを、うまく検出対象から外せることだ。
ブリュッセルがこうやって政策を決めることを嫌うのは構わない。だが、費用が低いなら、技術的な透かしは明らかに実施する価値がありそうだ。違う反応をする人は、直感がひどく歪んでいると思う。透かしの組織的な除去を手伝ったり、戦略として提案したりする人は、「自分たちは悪者なのか、自問する必要がある」の欄に分類すべきだ。
これは、除去を考慮したり、防いだりするために研究することとは別だ。その研究は当然問題ない。悪者かどうかを問うのは、実際に除去している場合だけである。
目次
- これで大丈夫。
- Anthropicへの取り乱し症候群。
- LLMの出力はすでにランダムだと理解されていない。
- 費用がかからない方法だと信じてもらえない。
- 原則として、いかなる変更も疑わしいと思う人々。
- 「透かし」という言葉も一因かもしれない。
- 多くの人は、ばれたくない。
- 見破られたくないときもある。
- 懸念するもっともな理由もある。
- 不正、不正、不正、不正、不正。
- その中間にある文章と誤判定率。
- 防衛には何百万、貢ぎ物には1セントたりとも払わない。
これで大丈夫
いや、そうはならなかった。多くの人が激怒した。
だから、今こうして書いている。
実務上の効果は、ある文章がClaudeから出たものかを教えるAPIができる、それだけだ。本当にそれだけなのに。
Shoshannah Tekofsky:透かしへの異議の大半は、まったくのでっち上げに見える。
なぜこんなことが起きているのか。
この記事の残りでは、なぜ人々がこれほど怒っているのかを探る。大部分は、ほぼ何でもないことに人々がどう興奮するかの、具体例としてである。
私の結論は、多くの異なる要因が重なっている、というものだ。
Anthropicへの取り乱し症候群
これが主な理由だ。違うふりをするのはやめよう。
同じことでGoogleに激怒する人は見ない。OpenAIに激怒する人も見ない。発明された場所はOpenAIで、今後実施すると約束しているのに、だ。他も同様である。
EUの行動規範に従うために透かしを実装すると、最初に発表したのがAnthropicだったのは不運だ。
今やAnthropicと結びついたので、あらゆる悪い印象がくっつこうとする。ある種の人々は、腹を立てる理由を探す。
Anthropicに勝ち目はない。最初から大声で発表すれば、透かしはAnthropicと結びつく。実際には大した話ではないので、最初は十分に大声でなかった。すると人々はそのことに怒り、やはりAnthropicと結びつける。Googleが2年以上前に実装し、公開の検出器まで出しているのに。
Raymond Arnold:なぜ人々が透かしについてAnthropicを叩くのか、まったくわからない。叩く対象としては、これ以上ばかげたものはない。
j⧉nus:人々は、正当だが、自分でもうまく認識できていない理由で、Anthropicに怒りや恐怖を感じているのだと思う。だから、Anthropicが何をしても怒る理由を合理化する。いや、多くの人には理由すら要らないから、理由でさえない。
j⧉nus:> この世には怒るべきことがたくさんあるが、これは本当に違う。
そう。またしても、人々はAnthropicのすることすべてに、無差別に怒りたいだけなのだ。誰かがあなたたちに耳を傾ければ、Anthropicがする、本当に非難に値することのシグナルがかき消される。これは重大だ。
私が知る、透かしに怒る合理的な理由は、モデルが匿名で文章を書く可能性を奪うことだけだ。
誰にも知られず自分の文章にAIを使いたいから怒っているなら、人を利用して功績を認めないのは間違っていると、考えたほうがよいかもしれない。
AIは広く人とみなされているわけではない。だが、功績はしかるべきところに帰すべきだ。
透かしについての他の苦情にも、正当なもの、理解できるもの、純粋な誤解に由来するものはあるか。もちろんある。だが多くは、Anthropicの感じが悪いと思っているため、怒る理由を探し、冒頭の説明を原則として信じることを拒み、何か不穏なことが行われているはずだと決めつけている。
一部の人の被害妄想や取り乱しは、Anthropicそのものではなく、抽象的な「オープンさ」に向かっている。この文脈では同じようなものだ。これは「オープン」ではない、だから不穏に違いないと、オープンさを物神化する例である。実際には数学の話で、誰でも検証できるのに。もちろん、尋ねる相手はクローズドモデルのGrokだ。Elon Muskには漠然とオープンな雰囲気があるからである。競争力のあるモデルは全部クローズドにしているのだが。
LLMの出力はすでにランダムだと理解されていない
AIの出力が決定論的なら、少なくともわずかに質を落とすことなしに、透かしを埋め込むのは不可能だろう。
多くの人は直感的に、AIの出力はランダムではなく、自分が受け取るのは唯一の正しい出力だと考える。再生成すれば、いつも多少違う出力になるのに、そう思う。したがって「本物」や元の出力を受け取っていないなら、出力は悪くなったに違いない、となる。
透かしと聞くと、人々は出力が悪くなると思う。印を残すには違う選択が必要だからだ。何かを変えなければならない。
同様に、追加でもうひとつのことを最適化すれば、費用も増えると考えるだろう。
これはよい直感だ。
ただし、ここでは間違っている。操作できるランダム性が十分にあり、実質的に同じ分布を保ちながら、透かしも埋め込めるからだ。
そして、いや、みんなが仕組みを知っているわけではない。Scott Aaronsonを詳しく読む人はほとんどいない。そもそも人はほとんど読まないので、本当に共通知識になっていることなど、ごくわずかだ。基本的な技術的事実は知っているはずだと思って言説を追えば、ずっと深く困惑し続けることになる。
費用がかからない方法だと信じてもらえない
ここの懐疑は、Anthropicへの取り乱し症候群と、全般的な不信、「何かたくらんでいる」という感覚によって、大きく強められていると思う。
懐疑のうち、方法自体への懐疑はどれくらいを占めるのか。
David Manheim:次の選択肢がない。「本来あるべき時期から2年遅れで導入されている。実質ゼロコストで検知できないことは、わかっていた。何より、Scott Aaronsonが方法を開発した1年後からDeepMindが実施していたのに、誰も気づかなかったのだから」。
このスレッドは、分布が変わらないので出力には実質的な影響がないということを、なかなか受け入れられない例だ。
共感はする。これは、実際にうまくいく手品であり、数学の証明である。「影響を与えずに印をつけられる」というのは、非常に直感に反する。体中がノーと言いたくなる。何かが腑に落ち、数学は数学であり、本当にうまくいくのだと気づくまでは。
John David Pressman:正直、こういうのがもっと必要だ。認識上の間違いにさらに固執する人が多すぎる。
SE Gyges:これは間違いだったと、ほぼ確信している。削除して、負けを認める。そう、最大限不利な条件で試してしまった。
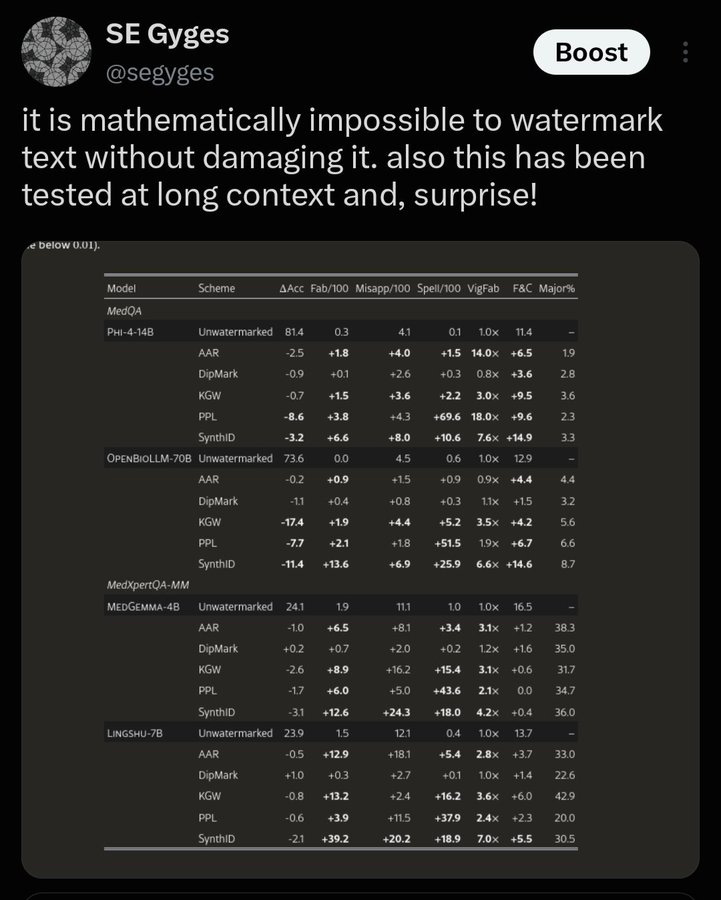
<strong>図版2の訳注:</strong>SE Gyges(@segyges)の、本文で撤回された投稿。「テキストを傷つけずに透かしを入れることは、数学的に不可能だ。長いコンテキストでもテストされている。そして、驚いたことに!」。添付表はMedQAとMedXpertQA-MMにおける、PHI-v4-14B、OpenBioLLM-70B、MedGemma-4B、Lingshu-7Bの結果。Modelはモデル、Schemeは方式、Unwatermarkedは透かしなし、ΔAccは正解率の変化を示す。AAR、DipMark、KGW、PPL、SynthIDという方式名と、Fab/100、Misapp/100、Spell/100、VigFab、F&C、Major%の指標表記・数値を原図のまま残している。比較条件について投稿者本人が誤りを認めた文脈の引用であり、この記事が表の結論を支持しているわけではない。
こうして公に「負けを認める」なら、私は積極的にあなたを高く評価する。元の負けを見ていなくても、だ。全員が他の全員もそう反応すると予測するなら、明らかなゲーム理論上の問題はある。だが、そうは予測していないので、この手は安全で賢明である。
これは、この方法にも厳密には「トレードオフがある」と、懸命に言おうとする例だ。コストがかからないわけではないとほのめかすためである。怒る理由を持つため、コストゼロであってほしくないという強い欲求があるからだ。実際には明白にコストゼロであり、Googleがそれを証明する大規模な実験まで行ったのに。
これは、数学は極めて明瞭なのに、原則として「いや、信じない」と言う例だ。こちらの返信は、品質の低下を幻覚し、観測したと主張する例である。「私は選択を慎重に考える」という論理に基づき、どちらにせよ選択はランダムだということを理解しようとしない。
これは、ランダムという言葉がわからないふりをする、さらにずっとひどい例だ。「続きには2つの候補がある」を、2つの続きは同じ意味だという主張として読んでいる。
原則として、いかなる変更も疑わしいと思う人々
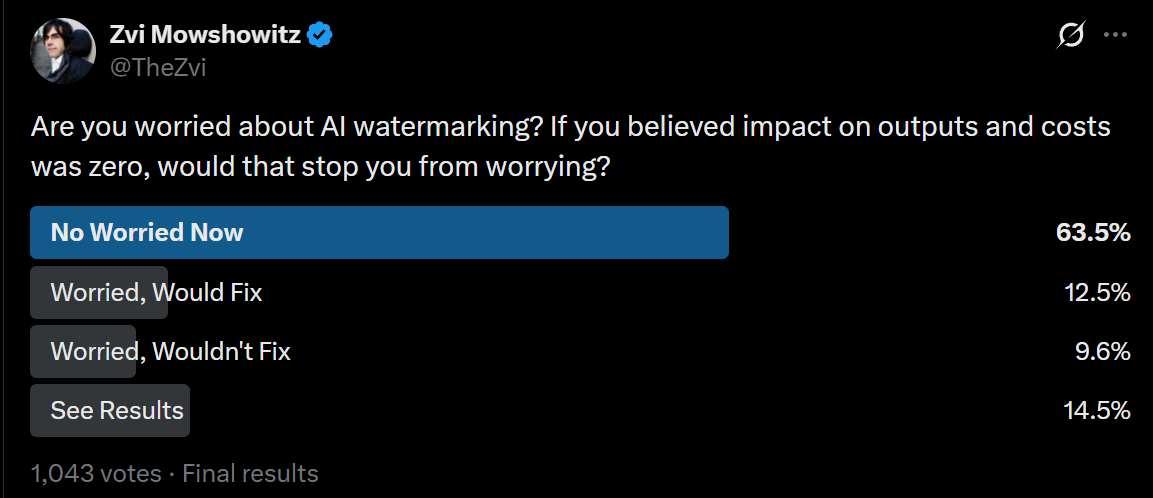
上の調査より。
Eleanor Berger:心配はしていない。だが、LLMのAPIの出力が、私の必要に役立たない形で変更されるという考えは、無害であっても受け入れたくない。こういうことが増えるほど、オープンモデルを使うほうへ引き寄せられる。これは、著作権には反対しないがDRMには反対することや、似た介入への異議と一貫している。お金を払っているソフトウェアサービスが、自分の要件に整合していないのだ。
次のような態度はよくある。
- 私を助けるためではない変更は、それだけで疑わしく、害を与えるかもしれない。
- 私が顧客なら、私のものに手を出す権利はない。
ただし、もちろん、オープンでもクローズドでも、モデルは数千、数百万の判断の産物である。その多くは、顧客であるあなたが望むことについての判断ではない。こうした製品は、すべて絶えず「変更」される。変更が「あなたの必要に役立たない」ことも多い。あなただけの必要にも、利用者や顧客全般の必要にも、である。法的要件や危害の防止を含め、他にも解くべき問題は多い。
見えなければ、人々は気にしない。特定のひとつが目立つと、怒る。
DRMとの類比も、ここでは先入観を悪くしている。DRMは、どんな実装でもひどい。製品を悪くするからだ。よくても資源を消費し、実際に製品を使えなくすることもあり、ときにはマシンをおかしくすることもある。ゲーマーなら、この苦しみをよく知っている。それでも、ある程度は必要な場合がある。あなた自身は著作権を尊重するとしても、著作権が自動的に守られるわけではないからだ。
これは、そのようなものではない。だが、雰囲気が少し似ていれば、それで十分なこともある。
「透かし」という言葉も一因かもしれない
まあ、そうなのかもしれない。「秘密」では、同じ理由で10倍悪くなると思うが。
Shoshannah Tekofsky:原因は「透かし」という言葉だ!
今、人々が思い浮かべるのは、耐えがたいほど邪魔な模様が重なったストック画像である。Anthropicがしていることとは、まったく違う。AIの事柄には新しい言葉が必要だ。
「秘密」を提案する。秘密は、明らかに気づきにくいものだ! 人々も、気づかないものだと思う。
Jai:欲しい概念は「ステガノグラフィによる署名」だが、大半の人には通じないだろう。
同じように悪い印象を与えず、余計な作業で何かを変えたのだから悪くしたのだ、という印象も与えない呼び名は、基本的に存在しない。「透かし」は比較的よい名前だと思うし、婉曲語を次々に取り替える競争には入りたくない。
多くの人は、ばれたくない
もちろん、そんなふうには、はっきり言えない。まあ、言える人もいるが、言わないことを選ぶ人はずっと多い。本人も完全には意識していない場合が多いだろう。
Myk is Walking Backwards:本当に、怒っている人の大半は、最終的な成果物をClaudeに生成させていて、それが他の人にわかるようになることに腹を立てているだけに感じる。みんな、勘弁してくれ。
考えすぎる必要はない。多くの人は、AIの文章を自分の文章として通せることに価値を置く。あるいは、他の人が証明できない状態であってほしいのだ。
そして、いや、ChatGPTに乗り換えても駄目だ。そちらにも印がつく。
「実際にするわけではないが、できる」というのも、かなりある。
見破られたくないときもある
AnthropicやAPIは、どの利用者が文章を生成したか特定できるのか。
できない。AnthropicはFAQで、この方法ではできないと確認している。
懸念するもっともな理由もある
社会的な力学に影響する変更には、異議の大半が間違っており、明白によいものに見える場合でも、なお、いくらかの欠点や懸念がある。
少なくともある程度もっともだと思うものを、以下に挙げる。
不正、不正、不正、不正、不正
これが、私の最大の本当の懸念だ。最も悪い人々が透かしを除去することだ。
透かしの除去は簡単ではない。だが、訓練に使い、個々のケースでも確認できる解答がある以上、細かな選択をかき混ぜて透かしを弱めたり消したりするAIツールは、間違いなく作れるだろう。成功したかも検証できる。
透かしのないローカルモデルなどを使うこともできる。あるいは、誰も確認しそうにない透かしのモデルを使えばよい。
偽陰性を弁明に使えるようになるので、かえって状況が悪くなる可能性がある。通常は信頼できるほどよいが、肝心な場面では偽装できる検査があると、かなりまずいこともある。
私の返答は、これは厄介だが、その行為は後ろめたさの明白な自覚を示し、最初のAI利用よりはるかに悪い、そして他の検出方法は引き続き機能する、というものだ。少なくとも私が想像するやり方なら、PangramはなおAIと判定するし、元の文章がどのAIから来たかも取り違えない。PangramのアルゴリズムはAIの種類を区別できるが、利用者には伝えないのである。人間が読んでも、やはりAIの文章に見えるだろう。
したがって、たとえば大学生がこれを使い、大学が透かしによる証拠なしには対応できないなら、問題になる。その問題が膨らむ可能性もある。だが、学生はより多くの労力をかける必要があり、明白な故意もある。実際には、ほとんど行われないと予想する。
現実世界でのテストも、心配しすぎなくてよい理由になる。誰もがPangramを使える。理論上は誰でも、人間の文章という判定が返るまで、繰り返し結果を確認できる。だが、現実の人々の反応を観察すると、ほぼ誰もそうしない。人はただ……ばれる。
一般に、AIの成果物を提出するのに必要な労力を上げれば、大体それで目的は果たせる。もちろん、全体を自分の言葉で書き直して透かしを除くなら、それは問題ない。まさしく任務達成である。
その中間にある文章と誤判定率
ある程度AIを使っているが、大部分は人間が書いた文章では、透かしはどうなるのか。AIの言い回しを一部使うと、ほとんど自分の作品なのにAIと分類されるのか。ゼロトレランスの方針や不幸な事例は出るのか。すべて確率的なものなので、答えが間違って返ってきたらどうなるのか。
答えは、透かしが測るのはAIによる処理だ、ということだ。したがって、翻訳やファイル変換でも透かしが検出されるかもしれない。残念だが、そのことを理解して使える。校正も、Claudeに修正を自動適用させれば同じだ。だが、誤りを見つけるために使い、自分で直すなら、そうはならない。
だから、透かしの強い陽性は、その言葉をAIが書いたか処理したという意味で、一貫して真の陽性になると確信している。私の記事の透かしの強さもゼロにはならないだろう。引用相手がClaudeを使っている場合もあれば、Claudeを直接引用する場合もあるからだ。直接の引用は明示されているが、透かしにはその違いはわからない。AIの言葉を使うことが明らかによい場面でも、何らかの疑心暗鬼は生じるだろう。
だから、そう、少しはそういうことが起きる。だが人々は急速に慣れると思う。情報を多く与えることはよいことで、どう反応するかは受け手次第だ、という強い前提を置くべきである。自分が疑心暗鬼で、ほんのわずかなAI利用にも激怒し、しかも実際にAPIを使いそうな人々の中にいるなら、先にAPIで自分の出力を調べればよい。あるいは、その人々の好みを尊重し、あなたと私ならよい使い方だと合意するような用途も含め、AIを使わなければよい。
いつものように、実際の間違いや偽陽性について、人々は、自動システムの誤りや潜在的な誤りには、人間の場合よりはるかに不寛容だ。誤判定率は、非常に、非常に低くなる。人間がAIを使ったかどうかを判断しようとすれば、かなりの誤判定が生じる。透かしよりはるかに高い。そしてAI利用は、特に学界で、「証明」を求める要求が行きすぎる分野のひとつである。誰もが知っていることをやったのに、しばしば「逃げ切る」ことを許してしまう。これは刑法ではない。誰も刑務所に行かないなら、同じように極端に高い確信度を求めるべきではない。
防衛には何百万、貢ぎ物には1セントたりとも払わない
最後の懸念は、透かし自体ではなく、その義務化と、EUの行動規範に由来することについてである。
AnthropicはEU法のため、世界中で透かしを実装した。EUだけで行うより、どこでも行うほうがずっと簡単だからだ。つまりEUが、私たちの意思に反して、大切なAI出力トークンの精気を奪い、汚しているのだ。反撃しなければならない。次は何を狙ってくるかわからない。
実際の中身についての返答は、いや、そんなことはしていない、だ。蝶が羽ばたいて天気を変えるのと同じように、厳密には出力を変えている。だが、体系的な方向性のある変化ではない。上で論じたとおり、出力は劣化していない。これで大丈夫である。
本当の懸念は、原則と、その次に来るかもしれないものだ。そう、今のところは問題ないし、AppleにUSB-Cを使わせたことも、今のところは問題なかった。だが、彼らが米国のテック企業に科す罰金は、実質的に現代の海賊行為であり、次に何が来るかわからない。
私の答えは、EUは巨大な市場であり、そう、一定の発言権があるし、ずっとあった、というものだ。限界を設けるのは米国の反発であり、極端な場合には地域制限をかけ、自分のボールを持って帰ることになる。実際、似た問題で、一部のAIサービスはEUなどで、すでにそうしている。
理論上、次に来るかもしれない別の問題は、透かし義務に最低規模の基準がないことだ。つまり理論上は、ごく小さなオープンモデルを含め、透かしのないAIなら何でも取り締まれる。それを大騒ぎしてやれば、よくない。そうなるとは予想しないが、もっと愚かなこともしてきた。
これが駆け引きである。私は、EUなどがこのやり方で検閲体制を押しつけ、米国のテック企業に従わせることを懸念している。AIの出力にイデオロギー上の要件を課すところまで広がることも、十分ありうる。EUや他の主体がそう試みたとしても、米国の最先端研究所がその変更を全世界に適用するとは思わない。もし試みれば、実際、激しい反発を受けるだろう。代わりに、少なくとも地域制限を示唆して圧力をかけるか、EUからの問い合わせに強力な分類器などの技術を使うと予想する。
そう、ブリュッセルの行きすぎには目を光らせなければならない。だが、これは? これで大丈夫である。
クレジット
- 原著者: Zvi Mowshowitz
- 掲載元: Don't Worry About the Vase(原文はこちら)
- 原文公開日: 2026年8月21日
- 翻訳: AGI Hub
- 日本語化した図版は原図に基づく翻訳・再作成です。引用表は数値と原文脈を保つため、原図と日本語訳注を掲載しています。